#检索增强生成
共 15 篇相关文章

ZeroRAG:无中心化语义对等路由,重构RAG检索架构
ZeroRAG 提出一种去中心化 RAG 检索路由层,文档留在所有者节点,通过语义最佳优先游走实现自组织检索。实验显示其在召回率与网络消息开销上优于去中心化基线,接近中心化文档存储的召回与LLM回答准确率,并可扩展至10万节点、具备节点故障自愈能力。

长上下文失效真相:干扰竞争比长度更致命
新研究发现长上下文检索失败主因是干扰项竞争而非长度。中性填充下准确率保持0.97以上,同格式竞争陈述可致损失扩大百倍,注意力质量解释58%方差。

NitiBench+:泰国法律问答基准如何解决法律时效性难题
NitiBench+是覆盖17个领域的泰国法律问答基准,通过同时保留判决当日法与现行法文本,量化法律时效性对模型表现的影响。研究发现67%的判决引用已变更法律,错误文本导致Bar标准分显著下降,最佳模型仅得7.78分。
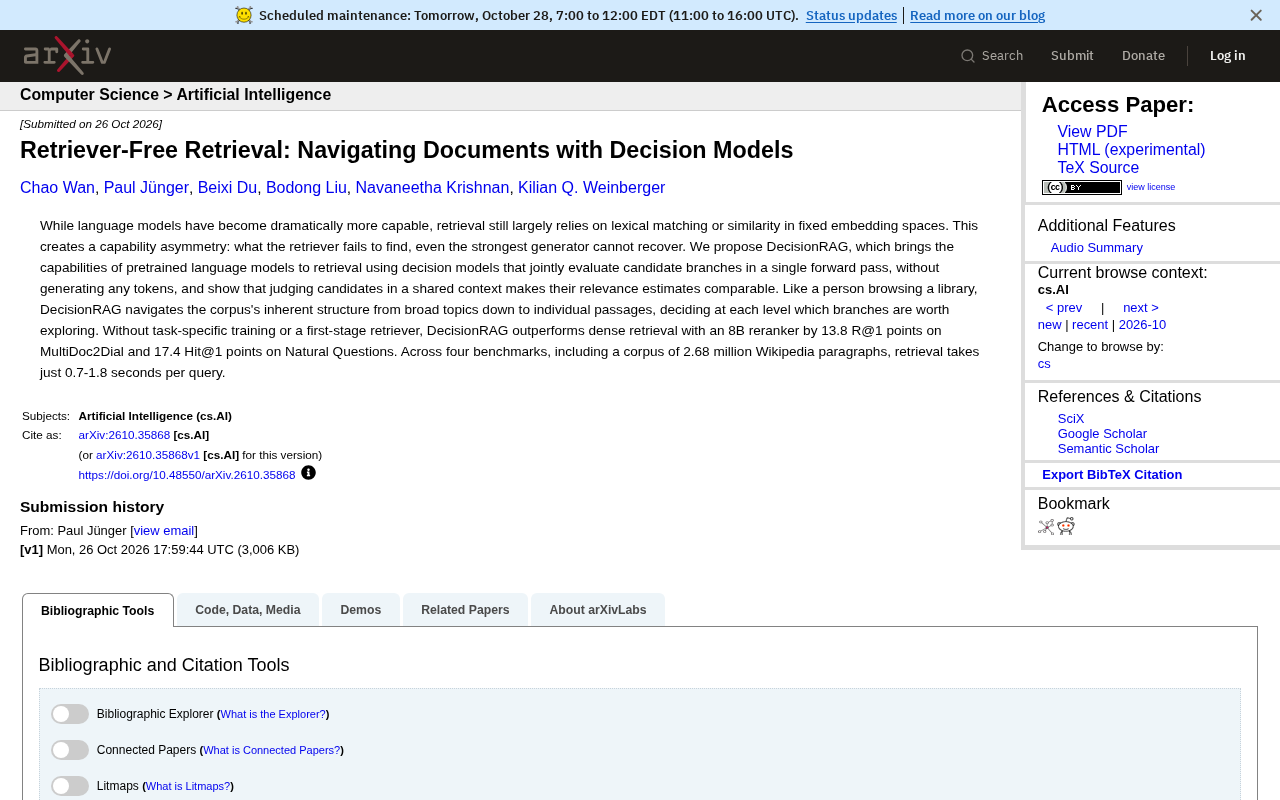
无检索器检索:DecisionRAG用决策模型导航文档
DecisionRAG提出无检索器检索新范式:用决策模型在单次前向传播中联合评估候选分支,沿语料库结构逐层导航,无需任务训练即超越8B重排器的稠密检索,检索仅需0.7-1.8秒。
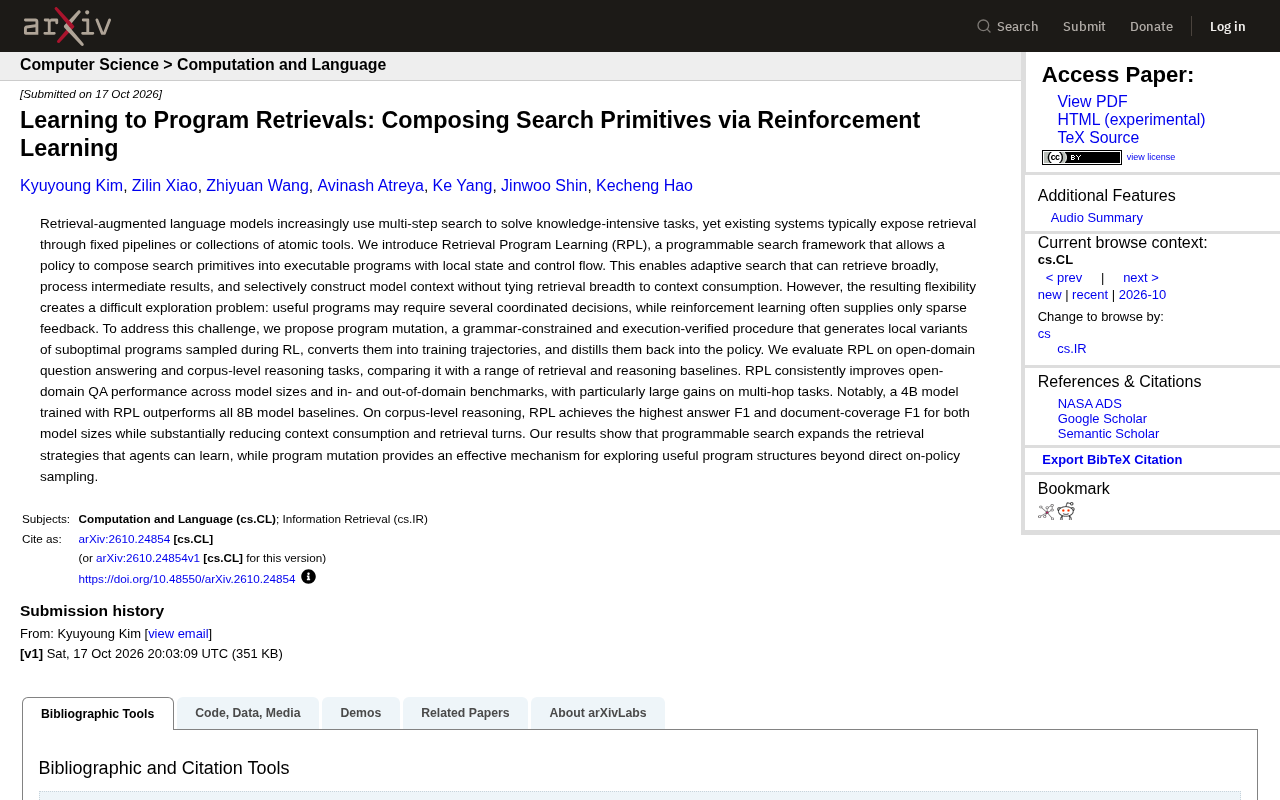
强化学习让AI自主编写检索程序,4B模型超越8B基线
RPL框架让AI通过强化学习将检索原语组合成可执行程序,结合程序变异机制解决稀疏反馈难题。4B模型在多跳问答上超越8B基线,同时降低上下文消耗和检索轮次。

多语言RAG不只是翻译:电商场景下的实体一致性与检索评估
多语言RAG不只是翻译问题。本文拆解电商场景下多语言RAG的五个关键关注点:规范产品标识、语言特定知识、结构化约束、跨语言评估与答案质量分离,并指出流畅答案不等于正确检索,一致性比翻译质量更关键。

Naive RAG 正在骗你:7 种能活到生产环境的 RAG 架构
Naive RAG 为何在生产环境失效?本文拆解检索的五种失败模式,并系统介绍七种能活到生产的 RAG 架构:混合搜索与重排序、查询变换、上下文检索、RAPTOR、GraphRAG、Self-RAG/CRAG、智能体与自适应路由,附成本与选型决策规则。

RAG分块策略怎么选?从固定切分到late chunking的实战指南
RAG分块策略怎么选?本文解析固定切分、递归切分、语义分块、结构感知分块、父文档检索与late chunking的适用场景与陷阱,结合Chroma研究报告与ACL 2025论文,帮你避免RAG检索到答案却答不完整的常见问题。

RAG系统:LLM不是难点,检索质量才是关键
RAG系统的失败往往源于检索质量而非模型能力。本文深入分析检索相关性、分块策略、混合搜索、多文档问题、评估方法及生命周期管理,揭示RAG工程中真正困难的部分。

Footnote:句子级引用的 Agentic RAG,让回答句句可查
Footnote 是一个带句子级引用的 Agentic RAG 研究 Agent:自行规划多次检索、引用由 API 校验而非模型手打、检索不到就直说不知道。本文解析它的架构、BM25+向量混合检索融合策略,以及为什么"可核实的引用"才是 RAG 真正的难点。
企业知识检索基准测试:AI智能体为何在真实数据前失灵
AI智能体在真实企业知识库上的检索为何频频失灵?本文解析杂乱企业数据与干净基准数据集的鸿沟,探讨RAG检索基准测试的挑战与企业级AI落地的实用建议。
厌倦手动调优RAG?开源工具Muffakir自动跑实验
开发者厌倦手动调优RAG流水线,打造开源实验运行器Muffakir。支持分块、嵌入、检索、重排序、top-k等组件的自动化组合实验,并用检索/生成指标、延迟和成本量化对比,可导出配置到Python。
 教程攻略
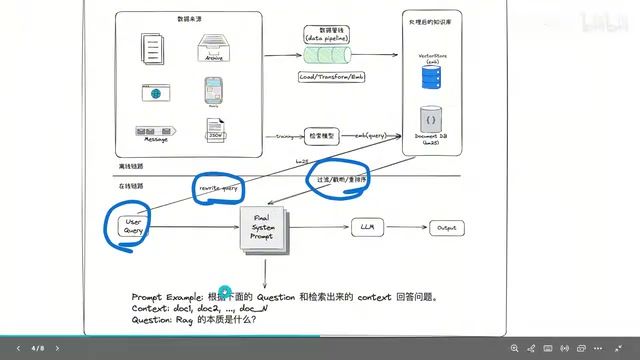
大模型RAG开发实战:原理详解与企业级落地指南
深入讲解RAG检索增强生成的核心原理与搭建流程,涵盖Embedding向量化、FAISS向量数据库、LangChain开发框架,以及企业级RAG项目中回答质量优化的实战经验与解决思路。
 深度解读
Agentic RAG完整指南:原理解析与代码实现
深入解析Agentic RAG与传统RAG的核心区别,详解工具调用、多步迭代、Query改写等关键机制,附LangChain和LangGraph代码实现,帮助开发者构建具备自主决策能力的智能检索增强生成系统。
 教程攻略
Agentic RAG实战:原理剖析与LangChain代码实现指南
深入对比传统RAG与Agentic RAG的架构差异,解析Agentic RAG的规划、工具调用、多步迭代三大核心能力,并基于LangChain和LangGraph提供完整的ReAct Agent代码实现,附ChatBoss开源项目实战案例。