45秒给Cursor Skill添加脚本:三步教程
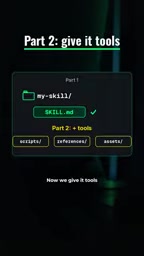
三步为 Cursor Skill 添加 scripts 目录,让 Agent 从读说明变为真正执行脚本。
文章介绍了一种让 Cursor Skill 具备实际执行能力的方法。纯 `skill.md` 只能描述任务,Agent 无法真正动手;在 Skill 目录中加入 `scripts` 文件夹并在 `skill.md` 中用相对路径指向脚本,Agent 即可运行 Python、Bash 等真实代码。教程给出三步配置:创建 scripts 目录、用相对路径声明脚本、把长文档和模板分别移入 references 与 assets 以精简上下文。文章还强调脚本应自包含并带清晰错误信息,并解释了目录分离背后的设计思路——为 Agent 区分可执行内容与参考内容。
Cursor 的 Skill 机制让 Agent 能够按照预定义的方式工作,但只有 skill.md 的 Skill 更像一份说明书——它告诉 Agent 该做什么,却没法真正动手。这个来自 YouTube 的短视频教程展示了如何用三步给 Skill 装上“手脚”,让它在执行任务时直接运行真实的 Python、Bash 或其他语言的脚本,而不是停留在文字描述层面。
从说明到执行:为 Skill 添加脚本能力
上一阶段的工作是写好 skill.md,把任务的目标、步骤和约束讲清楚。但描述性文字有天然上限:Agent 只能“理解”,不能“执行”。教程给出的核心思路很直接——在 Skill 的目录结构里加入一个 scripts 文件夹,把需要运行的实际代码放进去。
这一改动让 Skill 的能力边界发生质变。Agent 不再只是复述流程,而是可以在需要时调用脚本完成具体操作,比如处理文件、调用接口或执行计算。脚本语言不限,Python、Bash 等都可以,选择取决于任务本身的需要。
Skill 机制中的 Agent 通常是一个具备工具调用能力的语言模型。理解“调用脚本”的关键在于区分两种模式:纯文本模式下,Agent 只能读取 skill.md 并据此生成回答;工具调用模式下,Agent 可以发起一个函数调用,由运行时环境实际执行该命令并返回结果。scripts 目录的作用正是为 Agent 提供一个被显式允许调用的命令集合,skill.md 中的相对路径则充当“函数签名”,告诉 Agent 有哪些可执行入口、参数如何传递。因此,脚本能力本质上扩展了 Agent 的行动空间,而不是改变其推理方式。
三步完成配置
第一步:创建 scripts 目录
在 Skill 文件夹内部新建一个 scripts 文件夹,把准备好的脚本放进去。这个目录是 Skill 存放可执行代码的固定位置,Agent 后续会从这里定位并运行脚本。
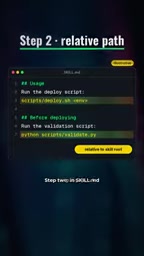
第二步:在 skill.md 中用相对路径指向脚本
这一步是关键。打开 skill.md,用相对路径写明脚本的位置,告诉 Agent 具体该运行哪个文件。相对路径的写法保证了 Skill 在不同环境下都能正确找到脚本,而不依赖绝对路径。
第三步:用 references 和 assets 管理非代码内容
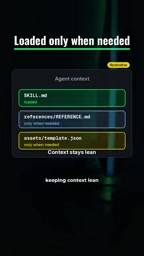
教程还给出了一个保持上下文精简的实践:把长文档移到 references 目录,把模板类文件移到 assets 目录。这样做的好处是 Agent 只在真正需要时才加载这些内容,避免无关信息占用上下文窗口。对于文档量大或模板较多的 Skill,这一分离能明显降低每次调用的上下文负担。
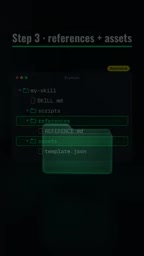
上下文窗口是 LLM 单次调用能处理的最大 token 数量,包括系统提示、skill.md、对话历史以及工具返回结果。如果把所有长文档和模板都直接写入 skill.md,每次调用都会携带这些内容,不仅挤占可用的推理空间,还会增加延迟和成本。将长文档放入 references、模板放入 assets 后,Agent 可以先判断当前任务是否需要这些资料,再通过读取文件的方式按需加载。这种“延迟加载”策略在大型 Skill 中尤为关键,它让上下文预算集中在与当前任务直接相关的信息上,而不是被静态资料占满。
脚本设计的两个实用原则
教程特别强调,每个脚本应当保持自包含(self-contained),并且带有清晰的错误信息。自包含意味着脚本不依赖外部隐式状态,单独拿出来也能运行;清晰的错误信息则让 Agent 在脚本失败时能拿到可读的反馈,而不是面对一段无意义的堆栈信息。这两点直接决定了脚本被 Agent 调用时的可靠性。
“自包含”在工程上指脚本不依赖调用方的工作目录、环境变量中的隐式配置或未声明的外部文件。对于被 Agent 调用的脚本,这一点尤其重要:Agent 可能在不同项目路径下触发脚本,如果脚本依赖相对路径或当前 shell 状态,就会在部分场景中静默失败。清晰错误信息则要求脚本在失败时输出结构化、可读的提示,例如“输入文件不存在:/path/to/file”,而不是抛出未捕获的堆栈。Agent 拿到这类信息后能够判断失败原因并决定重试、换参数还是向用户反馈,从而把一次失败转化为可恢复的交互。
目录结构背后的设计思路
把 scripts、references、assets 分开,本质上是在为 Agent 区分“可执行内容”和“参考内容”。脚本是需要被运行的,文档和模板是供查阅的,两类内容混在一起会让 Agent 难以判断该拿它们怎么办。分开之后,Skill 的结构本身就成了一种指令:看到 scripts 就知道这里有可执行能力,看到 references 就知道这里是按需读取的资料。
这种组织方式也便于维护。脚本更新不影响文档,模板替换不涉及代码,各部分的职责边界清晰。对于一个需要长期迭代的 Skill 来说,这种结构比把所有内容堆在一个目录里更容易扩展。
适用场景与注意事项
给 Skill 加脚本最适合那些有明确执行动作的任务——需要读写文件、调用外部命令、做数据处理或执行固定流程的场景。如果 Skill 只是提供知识或写作规范,纯 skill.md 可能已经够用。
需要注意的是,脚本一旦被 Agent 调用,其行为就直接影响结果,因此脚本的正确性和错误处理比普通代码更值得关注。教程中提到的“清晰错误信息”不是可选项,而是让 Agent 能够正确应对失败的前提。
这套方法的价值在于把 Skill 从“告诉 Agent 怎么做”推进到“让 Agent 真正去做”。三步配置本身耗时很短,但它带来的能力提升是结构性的。
相关推荐

5B小参数大能力:Flux.3 Klein与MOSS Image在Draw Things上手指南
基于B站实测教程,详解5B级开源图像模型Flux.3 Klein与MOSS Image在苹果Draw Things上的使用:协议差异、SFT与蒸馏版本选择、Bbox精准布局、加速LoRA参数配置与Mac/iPad本地出图速度表现。

奥特曼称本地部署不如数据中心,开源AI路线之争再起
奥特曼称开源大模型本地部署不如数据中心集中运算,B站UP主瓜熟迪落拉拆解这一表态背后的技术路线之争与中美AI业态差异,讨论本地部署是否真的该被放弃。

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。