MiniMax H3开源工作流:低显存也能打造呼吸感皮肤

拆解MiniMax H3去油腻双采样工作流:12G显存可跑,融合模型加LoRA改善肤质并提速。
本文基于B站UP主的MiniMax H3双采样多采样工作流教程,梳理其在去油腻、提速与低显存适配三方面的技术要点。工作流将FL模型与RE模型融合,并引入破线LoRA以减少人物面部油腻感;双采样方案把一采潜空间数据直接送入放大节点后再采样,省略重新编码环节从而提速。针对低显存,内置两个分块处理节点,块数越多显存压力越小,据称12G显存亦可运行。文章还介绍了多个LoRA的搭配与权重注意事项、节点配置与步数分配建议(如一采0.4、二采0.7,十二步拆为八步加四步),并结合5060Ti实测给出速度参考。总体评价是:该方案并非一键神器,但为硬件受限的创作者提供了可操作的优化路径,同时融合模型与多LoRA叠加也带来一定调试成本。
AI视频生成中,人物面部“油腻感”和低显存门槛一直是创作者的痛点。近期,一套针对MiniMax H3模型的双采样多餐工作流在B站UP主中引发讨论,号称能优化执行方案、改进模型与LoRA搭配,并让12G显存设备也能跑通。本文基于该教程内容,拆解其技术要点与实际体验。
核心改进:去油腻与双采样提速
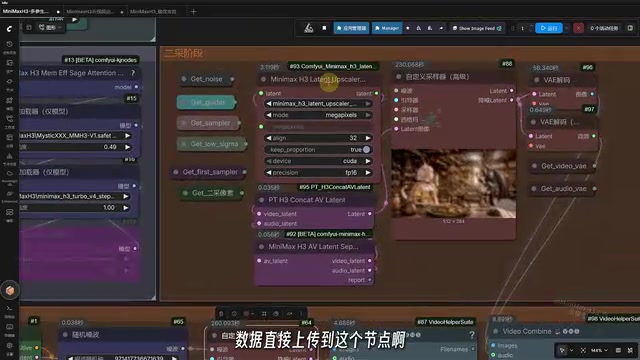
以往用FL模型生成的人物面部容易显得油腻、缺乏真实皮肤质感。这套工作流将FL模型与RE模型融合,形成兼具参考能力与美学表现的融合模型。同时引入一个“破线”LoRA,专门用于减少人物生成的油腻感。UP主表示,实际效果“还不错”。此外,工作流采用双采样方案,将一采的潜空间数据直接上传到节点进行放大处理,再进入采样器,省略了重新编码的过程。据UP主分析,这一改动“速度是会更快一点的”。
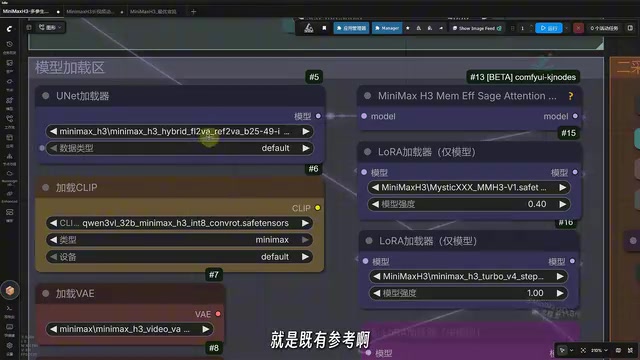
潜空间(Latent Space)是扩散模型中的关键概念。在AI视频/图像生成中,原始像素数据经编码器(如VAE)压缩到一个低维的潜在表示空间,扩散与去噪过程在这个空间中进行,最后再经解码器还原为像素画面。相比直接在像素空间运算,潜空间大幅减少了计算量,是当前主流生成模型能在消费级显卡上运行的基础。文中所说的“一采潜空间数据”即指第一次采样后得到的抽象特征张量,而非最终画面;将其直接送入放大节点,意味着绕过“解码→像素放大→再编码”的传统链路,减少了信息损失与计算开销,这也是双采样方案能提速的核心原因。
LoRA(Low-Rank Adaptation,低秩适配)是一种轻量化的模型微调技术。它不修改基座模型的全部权重,而是在特定层旁挂接小规模的低秩矩阵,训练时只更新这些附加参数。由于参数量通常只有原模型的百分之几甚至更少,LoRA文件体积小、加载快,且可在推理时按需启用或组合。不同LoRA往往针对特定风格、画质缺陷或动作类型训练,因此叠加多个LoRA时会出现相互干扰,需要调整权重来平衡效果——文中提到的破线LoRA、加速LoRA、打戏LoRA以及mystic的权重协调,正是这一机制的直接体现。
低显存适配:分块处理与节点配置
针对低显存用户,工作流内置了两个低显存节点。UP主自己的设备是5060Ti 16G显存、32G内存,坦言“性能也不咋地”。这两个节点的底层逻辑是将模型数据和视频生成数据分块处理,用户可自行设置分块数量——数字越大,显存压力越小。据称,即使12G显存也能运行。生成速度方面,UP主实测88秒视频跑了10分钟,14秒视频跑了20分钟,并认为“这个速度我是可以接受的”。更好显卡下,基本十几分钟可出一个视频。
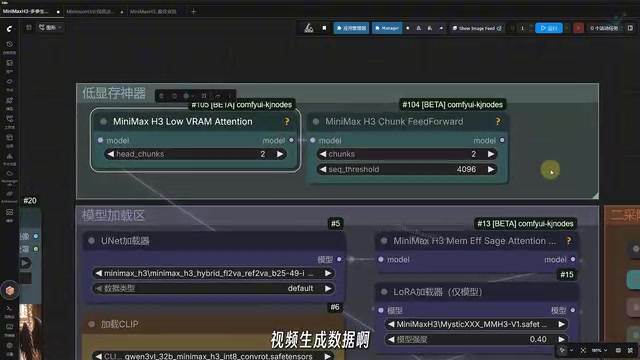
分块处理(Tiling / Chunking)是应对显存瓶颈的常用工程手段。视频生成需要同时驻留模型权重、潜空间特征和注意力计算的中间结果,分辨率或帧数稍高就会触发显存溢出(OOM)。分块思路是把模型层或数据张量切成若干小块,逐块计算后再拼接,从而把峰值显存占用压到单块所需的水平。代价是块与块之间需要额外的调度与同步,计算效率略有下降,因此分块数量越多显存越省、速度越慢,用户需要在显存与耗时之间权衡。文中“数字越大,显存压力越小”的说法即源于此。
模型与LoRA搭配策略
工作流提供了多个LoRA选项。除了去油腻的破线LoRA和加速LoRA外,还有一个“关闭的LoRA”用于打戏或武器等动作幅度较大的视频。UP主提醒,开启该LoRA后不建议再打开mystic,否则需将其权重降至0.2左右。这种灵活的搭配让创作者能根据内容类型调整风格。
双采样底层逻辑与参数设置
双采样的变化在于:将一采潜空间数据直接传入节点进行放大,再采样。流程上省去了重新编码。工作流中设有六个普遍加载节点、两个视频上传节点和两个音频参考节点,可用Ctrl+B或按钮启停。输入区域包括提示词、分辨率选择器、视频时长和二采像素大小。UP主建议一采设为0.4,二采设为0.7,具体对照表格调整。基本调度器中,十二步是降噪总步数,分离为八步给一采,剩下四步给二采。若追求更快速度,总步数可改为十步(六步一采、四步二采)。
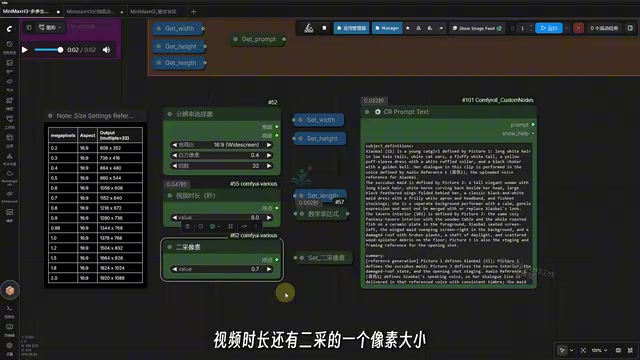
基本调度器(Sampler/Scheduler)决定去噪过程中每一步的噪声水平与采样策略。文中“十二步是降噪总步数,分离为八步给一采、剩下四步给二采”,指的是把总去噪预算拆分到两个采样阶段:一采在较低分辨率或较粗粒度下完成大部分结构生成,二采在高分辨率阶段用较少步数精修细节。这种步数分配是一种速度与质量的折中——一采步数不足会导致构图与语义偏差,二采步数不足则细节发糊。常见调度器(如Euler、DPM++系列)对步数的敏感度不同,实际调参时可先固定总步数,再微调两阶段的比例。
实际体验与适用场景
从UP主的演示看,这套工作流在5060Ti上能稳定出片,速度可接受。去油腻LoRA对皮肤质感的改善是直观的,但“呼吸感”描述带有一定主观色彩。双采样省略重编码带来的提速,在低显存设备上意义更大。对于需要快速迭代的创作者,这套方案降低了硬件门槛。不过,融合模型与多个LoRA的叠加可能增加调试成本,新手需花时间理解节点逻辑。
总体而言,这套MiniMax H3工作流在去油腻、提速和低显存适配三方面给出了具体方案。它并非一键神器,但为受限于硬件的创作者提供了一个可操作的优化路径。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。