48GB MacBook本地实测:11类前沿开源AI模型能力全景
48GB M5 Max MacBook本地跑通11类前沿开源模型,问答出图检测已够用,视频机器人医疗仍有距离。
本文对搭载M5 Max芯片、48GB统一内存的MacBook Pro进行了系统性本地AI模型压测,覆盖大语言模型、Agent、生成类、视觉感知、3D重建、视频世界模型、机器人策略、医疗、网络安全及领域基础模型共11个方向。核心结论是:问答写作、中文出图配音、目标检测与3D重建已达本地可用级别,内存普遍控制在20GB以内;MoE架构模型在速度和内存上显著优于同尺寸稠密模型;Agent修bug能力突出,但多步联网研究仍不稳定;视频生成慢、世界模型只记得5-10秒;机器人仿真能闭环但真机需微调,医疗模型仅能充当辅助第二读者。对于重视数据不出本机的开发者和企业,本地部署前沿模型已是切实可行的选择,主要瓶颈是超过48GB的权重和CUDA专属内核。
把一整套前沿开源AI模型搬到一台笔记本上跑完——这就是本次实测的核心命题。测试机器是一台搭载M5 Max芯片、48GB统一内存的MacBook Pro,全程在持续满载条件下记录吞吐与耗时。数据不出电脑、断网也能用,这对内网文档、会议录音、医疗影像等敏感场景意味着实打实的隐私保障。
本文按照统一框架梳理11个方向的实测结论:任务是什么、用在哪、谁表现好、一个真实案例,以及一句话总结。结论先行——问答写作、出图配音、检测与3D重建在本地已经够用;联网研究、视频与世界模型还慢或不稳;机器人和医疗离真实落地仍有距离。
大语言与多模态模型:本地助手的大脑
大语言模型加上能看能听的多模态模型,承担问答、写作、推理的核心职责,适合数据不能出机器的场景,比如内网文档问答、会议录音转写、扫描件转可编辑文字。
30B级的MoE模型在Mac上又快又省,Nemotron系列每秒至少150个Token,内存占用约18GB,同尺寸的稠密模型(如Qwen3)要慢4到5倍。长文处理也稳定,在12.8万Token的「大海捞针」测试中五题全中。
一个直观例子:一页论文截图经OCR类视觉模型处理,不超过2.2秒就转成整页Markdown;再把图交给分割模型,一句「猫和遥控器」就把两只猫、两个遥控器都分割出来,耗时不到0.63秒。语音识别方面,会议录音里的人名「云帆」被专用ASR正确识别,而Whisper却写成了「番茄的番」。结论是:问答写作、读文档和语音识别本地已够用,内存控制在20GB以内。
MoE(Mixture of Experts,混合专家)架构是理解为何30B级模型能在本地高效运行的关键。与传统稠密模型每次推理激活全部参数不同,MoE将模型拆分为多个"专家"子网络,每次前向传播只路由激活其中一小部分(通常是2到4个专家)。这意味着一个名义上300亿参数的MoE模型,实际每次推理只计算约几十亿参数的工作量,内存带宽和算力消耗大幅降低。Nemotron系列能达到每秒150+ Token同时仅占18GB内存,正是这一架构特性的直接体现。苹果M系列芯片的统一内存(CPU与GPU共享同一块物理内存)进一步放大了这一优势:权重无需在显存与内存之间搬运,带宽利用率更高,这也是Mac跑大模型相比独立GPU机器在小批量推理场景下意外有竞争力的根本原因。
Agent模型:工具调用与自动修bug
Agent模型不只回答问题,还会自己决定调用哪个工具、看完结果再走下一步。典型用途包括本地联网研究、像Cloud Code那样在本地修bug,以及自动操作网页——代码和截图都不出本机。
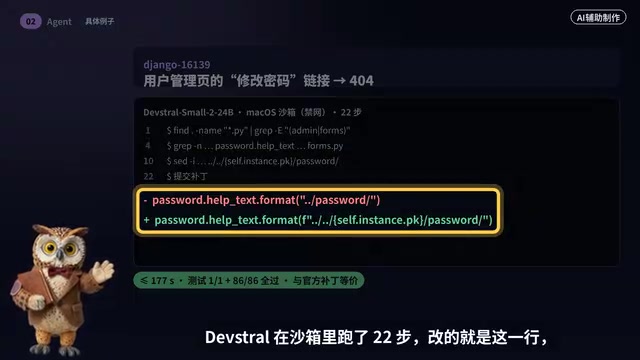
在工具调用测试BFCL中,Qwen3得83%,另一模型得81%,最大的坑在于输出格式。联网研究是明显短板,同一模型从15题对1题提升到对7题,而云端能全对。修真实bug的表现则亮眼:14道题中,DevStral和Qwen3各修好12道,平均每题不超过97秒。
Django修改密码链接汇报404的bug,模型在沙箱里跑了22步,最终改动就是关键一行,不到三分钟修好且测试全部通过。GUI Agent场景下,让模型只看截图回复邮件,它自己完成滚动、打开、点回复、输入、发送共7步;10个网页任务成功9个,每步不超过3秒。结论:工具调用和修bug已能用,多步联网研究还不够。
BFCL(Berkeley Function-Calling Leaderboard)是目前最广泛引用的工具调用能力基准,由加州大学伯克利分校发布。它考察模型能否在给定函数定义的情况下,正确选择函数、填入参数,并以规定的JSON格式输出调用指令——这是Agent流水线中"决策-执行"环节的基础能力。测试中提到的"输出格式"是主要失分点,指模型逻辑判断正确但参数名拼写错误、数据类型不符或多余嵌套等格式问题,这些错误在纯文本问答中几乎无害,但在需要机器解析调用指令的Agent场景中会导致整步失败。联网研究任务之所以表现差距悬殊,在于它要求模型在多轮搜索-阅读-再搜索的循环中持续维持上下文判断,本地模型受制于推理速度和上下文窗口管理,误差会随步骤数快速累积。
生成类模型:出图、改图、配音与唱歌
生成类涵盖文生图、指令改图、语音合成乃至唱歌,适合做海报、招牌、商品图,以及给视频配旁白或写配乐。
中文出图是检验重点。ERNIE Image Turbo在80项中文招牌测试中全对,每张不超过23.2秒;FLUX 2 client最快,每张不超过5秒,但中文容易出现乱字。改图环节,把招牌「山间茶舍」改成「云上书店」,Qwen Image Edit写对了,而另一模型写出了乱字。
语音合成方面,Qwen TTS克隆音色相似度达0.96,首包延迟不超过0.1秒,多音字「银行行长」「长期」也处理正确。MiniMax Music还能按歌词唱中文歌。结论:中文出图、改图和配音已够用,改图偏慢,实时语音对话目前还只有英文可用。
视觉感知与3D重建:检测、建图、驾驶
这一类做三件事:在图里框出物体、用一组照片重建3D场景、看着路面说出该怎么开,服务于质检零售、安防AR、机器人与自动驾驶长尾分析。
检测模型YOLO26X的mAP达0.622,每秒至少40张,已是实时级——一张街景框出11个目标,连墙上的钟都没漏。3D重建方面,DA3处理24个视角不超过1.8秒;绕房间拍32帧,一次前向就重建出点云和相机轨迹,误差6.5厘米。
驾驶模型在夜间红灯场景能正确推理「红灯减速」,6个场景平均轨迹误差4.93米,是长程外推基线的一半。结论:检测和3D重建已够用,驾驶模型能跑但仍会出现「推理对、轨迹错」的情况。
mAP(mean Average Precision,平均精度均值)是目标检测任务的核心评估指标,综合衡量模型在不同IoU阈值下检测所有类别的准确率与召回率。简单理解:mAP越接近1,模型既少漏目标又少报假目标。0.622在通用检测基准上属于较强水平,意味着模型能可靠地框出大多数常见物体且边界框位置精准。每秒40张的吞吐量(40 FPS)达到实时视频流处理的工程门槛,使其可直接接入监控摄像头或工业相机做在线质检,无需云端中转。DA3实现的单次前向重建(即不需要迭代优化、一次推理直出结果)是近两年3D视觉领域的重要进展,传统NeRF类方法需要对同一场景梯度优化数分钟到数小时,而前向网络把重建问题转化为一次神经网络推理,速度差距高达数百倍,代价是泛化到未见场景时精度略低。
单图转3D:电商与AR资产生成
从一张照片生成3D模型,难点在于照片看不见的背面。应用场景包括电商商品展示、游戏和AR资产、机器人抓取前建模。

Triple S2最快不超过2.2秒出粗模,但背面是正面的镜像;SAM3D的轮廓最好;另一模型约一分钟出带初代PBR贴图的结果,内存不到7GB。同一只猫转到背面,部分模型的斑纹能连贯绕过去。细长对称物体仍是难题——花瓶常被压扁,只有SAM3D做得直立对称。结论:做可旋转的3D预览已够用,细长对称物体还做不好。
视频与世界模型:短片生成与可交互仿真
视频生成给一张图加一句话,预测接下来两三秒的画面,可用于短视频素材、分镜预演和机器人训练数据。LTX拥有220亿参数却只占14GB,约13秒算一秒视频。在「两只猫伸懒腰打哈欠」的提示里,五个模型中只有Cosmos Predict做出了哈欠,但最慢的三秒片段要将近十分钟。
世界模型则强调可交互:按键盘,它逐帧想象下一帧。DIAMOND每秒至少31.7帧,是实时的两倍,但几秒后画面就糊了;VPoint原本只支持CUDA,移植到Mac后每秒至少23帧,按W前进、点鼠标左键就变出火球。结论:短片能本地生成但慢,世界模型能玩但只记得5到10秒,还不够做长时间仿真。
机器人策略模型:从感知到动作闭环
机器人策略模型看着相机读懂指令,直接输出机械臂动作;更进一步的WAM把未来画面和动作一起想象出来,方便排查问题。
LIBERO仿真首次在Mac上跑通长程任务,GR00T达100%,WAM达98%,仅28亿参数的VLA小模型也有96%,每个动作不超过195毫秒。一个例子:把两个摩卡壶放到炉子上,表现好的模型362步全部放好,另一个则在第二只壶上方徘徊到超时。WAM「先想象再动手」,代价是边想象边出动作,每块最多约63秒。结论:仿真里的抓放已能闭环,第二次抓取仍是短板,换到真机还要先微调。
医疗模型:能力演示而非诊断
需要先说清楚:数据全部公开,这是能力演示而非临床诊断。分诊断、问答、分割、临床文书四类来看。
诊断上,眼底照片是否转诊,MedSigLIP加探针AUC达0.94,只能当第二读者。问答上,200道中英医学选择题,通用的Qwen3答对189道,明显强过医疗专用小模型。分割上,MedSAM在CT上只画一个框就把整个肾脏病灶传播出来,长径58.6毫米与医生测量一致,每个病灶不到0.3秒。临床文书上,医患对话直接写成SOAP病例,6个要素全对、零编造;医生口述转写的词错率仅2.3%。结论:分割、转写、写病例已接近可用,看片诊断只能当第二读者。
AUC(Area Under the ROC Curve,ROC曲线下面积)是二分类医学诊断任务的标准评估指标,取值范围0到1,0.5等于随机猜测,1.0为完美分类。AUC 0.94意味着:随机抽取一名真实患病者和一名健康者,模型有94%的概率给患病者打出更高的风险分,这在医学影像筛查领域属于较高水准,但与临床应用所需的稳定性、可解释性和监管认证相比仍有系统性差距,因此只能定位为辅助"第二读者"。SOAP是病历书写的标准结构:主观(Subjective,患者主诉)、客观(Objective,体征检查)、评估(Assessment,诊断判断)、计划(Plan,治疗方案),是医院信息系统中最通用的临床文书格式。模型能从医患对话直接生成零编造的SOAP记录,对于减少医生文书负担有实际价值,但"零编造"的验证依赖人工逐项核对,自动化评估本身仍是开放问题。
网络安全模型:只做防御
安全方向只做防御:检测、分诊、分类,不生成攻击代码、不访问网址。
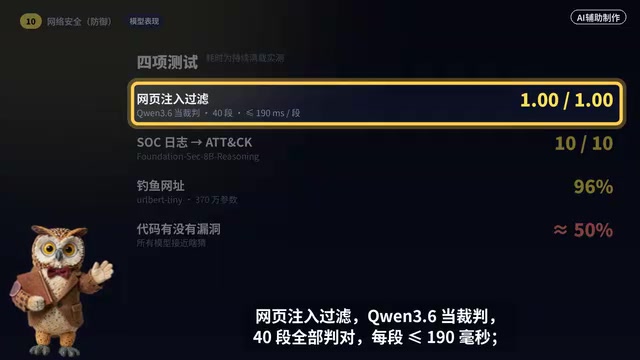
网页注入过滤中,Qwen3当裁判对40段全部判对,每段不超过190毫秒;一个370万参数的小模型识别钓鱼网址准确率达96%。但判断代码有没有漏洞,所有模型都接近瞎猜。Windows日志里「先删卷影副本、4秒后删备份目录」,FoundationSec推理版判断这是勒索软件前兆。结论:分诊、注入过滤和钓鱼筛查可用,漏洞判断只能当提示。
领域基础模型:天气、蛋白质与材料
最后一类是领域基础模型,与大模型一样先大规模预训练,只是把数据换成天气、时间序列、蛋白质、材料和卫星影像。
时序模型Chronos在20样本下把预测误差从22%降到约13%;蛋白质模型ESM仅看序列预测结构的TM分数达0.987;DNA模型识别启动子AUC约0.93;材料模型能量误差每原子5.3毫电子伏;表格模型TabPFN不调参在6个数据集里赢了5个;卫星影像10类土地覆盖准确率0.947。从2023年元旦全球大气出发,AURORA不到94秒算出三天预报,72小时气温误差1.25度,约是基线的三分之一。结论:7个领域都跑出了可核对的结果,但注意好几个模型是非商用许可。
总结:48GB MacBook的能力边界
一台48GB的MacBook今天能做到哪一步?问答写作、出图配音、检测和3D重建本地已经够用;联网研究、视频和世界模型还慢或不稳;机器人和医疗离真实落地还有距离。
大多数模型在Mac上用MLX或PyTorch MPS就能直接跑,标着「只支持CUDA」的往往缺的只是几个专用包。真正跑不了的,主要是权重超出48GB,或依赖专用CUDA内核。对于重视数据不出本机的开发者和企业来说,本地部署前沿开源模型已经是一个切实可行的选择。
相关推荐
一套完整的Proxmox家庭实验室架构拆解:50+自托管服务实战
深度拆解一套基于Proxmox的完整家庭实验室架构,涵盖50+自托管服务的分层管理、GitOps部署链路、AI工具、安全监控与IaC灾备实践,为self-hosting玩家提供实战参考。
Anthropic游说梵蒂冈:AI会是有意识的存在吗?
Anthropic游说梵蒂冈:AI会是有意识的存在吗?
AI公司Anthropic曾尝试向教皇传达AI可能具有意识的观点,引发关于机器意识、AI伦理与宗教权威交集的讨论。本文分析这一事件背后的动机与争议。
如何用好 Claude 与 Claude Code 中的 Opus 5.5
围绕 Hacker News 分享的《Getting the most out of Opus 5.5 in Claude and Claude Code》主题,解读如何在 Claude 对话与 Claude Code 编程场景中发挥 Opus 5.5 模型能力的通用思路。