4B小模型专精训练,能否替代大模型?

开发者用 3D 场景数据集训练小模型,发现 350M 专精模型表现远超预期。
一位开发者训练 Qwen3.5-4B-3D-Coder 并构建跨领域 3D 场景数据集,由此改变了对小型专精模型的判断:按领域拆分的 4B 模型足以覆盖 3D 资产、Web 与后端开发等任务,而非追求单一万能模型。实验中 350M 小模型在中等复杂度编码上可处理约 16K tokens 上下文,专精 4B 模型接近 96K,但长上下文与复杂推理仍是小模型短板。最反直觉的发现是 epoch 数量被严重低估,eval loss 无法指示哪个 checkpoint 能产出可运行代码。作者还认为,在拥有高质量领域样本时,SFT 可能以远低于 RL 的成本取得良好效果,且 350M 模型可在 8GB 显存 GPU 上全量微调。
从一次意外开始的实验
一位开发者在训练 Qwen3.5-4B-3D-Coder 时,原本并没有抱太高期望。但随着模型和后续的 GLB 资产版本逐步成型,他的判断发生了变化:专门针对特定任务训练的 4B 模型,可能足以覆盖大多数实际需求。
这个判断并非空想。生成 3D 资产、构建和编排复杂场景、Web 开发、后端开发、逆向工程——这些任务在他眼中都可以用不同的小型专精模型来承接。他强调的不是“一个万能小模型”,而是“多个专精版本各司其职”。
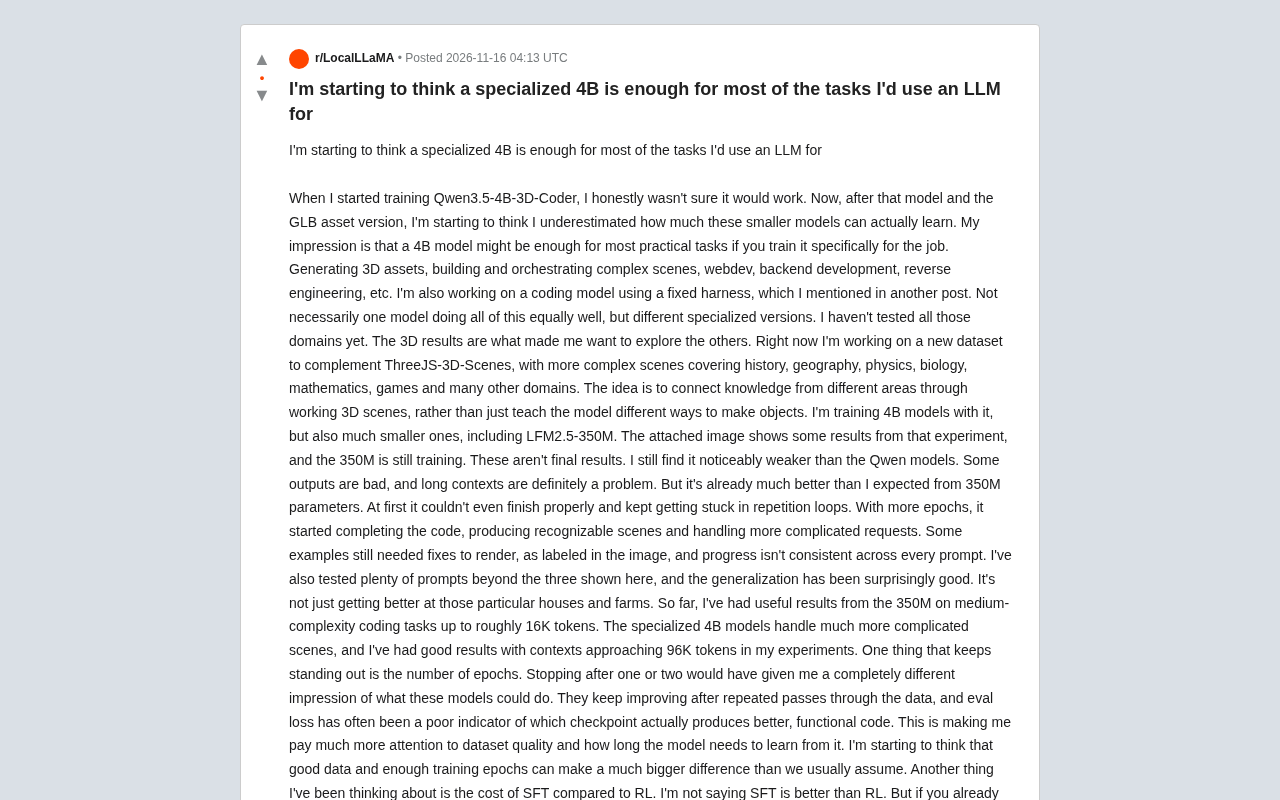
目前,他只完整验证了 3D 方向的结果,其他领域还在测试中。但 3D 上的表现足以让他想继续探索下去。
用 3D 场景连接知识,而不只是教模型造物体
他正在构建一个新的数据集,用来补充已有的 ThreeJS-3D-Scenes。与单纯教模型“怎么生成不同物体”不同,新数据集的思路是通过可运行的 3D 场景把历史、地理、物理、生物、数学、游戏等领域的知识连接起来。
换句话说,模型不仅要会写 Three.js 代码,还要理解场景背后的跨领域知识,并把它们组织成可运行、可交互的 3D 内容。这对模型的知识整合能力提出了更高要求,也让数据集本身成为训练效果的关键变量。
他用这个数据集训练 4B 模型,同时也尝试了更小的模型,包括 LFM2.5-350M。
350M 的意外表现与明显短板
350M 参数听起来几乎不可能完成有实际价值的代码生成,但实验结果比作者预期好得多——尽管他明确表示“这还不是最终结果”。
初期问题很直接:模型无法正常结束输出,反复陷入重复循环。随着训练 epoch 增加,它开始能完成代码、产出可识别的场景,并处理更复杂的请求。截图中有部分示例仍需手动修复才能渲染,作者也如实标注了这一点,并承认不同提示词之间的进步并不一致。
更重要的是,泛化能力出乎意料。他测试了远超示例范围的提示词,模型并非只对那几栋房子和农场“过拟合式”地变好。目前,350M 在中等复杂度的编码任务上,大约能处理到 16K tokens 的上下文;而专精的 4B 模型在实验中可接近 96K tokens 的上下文,并能处理复杂得多的场景。
作者坦言,350M 相比 Qwen 系列仍有明显差距,长上下文是明确的短板,复杂推理和长距离依赖也受限。但一个 350M 能做到这个程度,本身已经改变了他对“参数规模下限”的直觉。
被低估的 epoch:eval loss 不是好裁判
实验中最反直觉的发现之一,是 epoch 数量的影响被严重低估。作者直言,如果只跑一两个 epoch 就停下,他对这些模型能力的判断会完全不同。
模型在反复遍历数据之后仍在持续进步,而 eval loss 往往无法指示哪个 checkpoint 真正能产出更好、可运行的代码。这意味着依赖验证损失做早停,可能会错过实际能力更强的模型。
这个观察把注意力引向了两个更根本的变量:数据质量和训练时长。作者开始认为,好数据加上足够的训练轮次,其影响可能比通常假设的更大。
eval loss(验证损失) 指模型在留出的验证集上计算的损失值,训练中常被用来监控是否过拟合、并作为早停(early stopping)和 checkpoint 选择的依据。然而 eval loss 衡量的是模型对下一个 token 的预测概率,与下游任务的实际可用性(如代码能否成功运行、3D 场景能否正确渲染)并不总是一致。尤其当模型在训练后期从“记忆局部模式”转向“掌握可组合的生成规律”时,验证集上的 loss 可能已经趋于平缓甚至轻微上升,但生成质量仍在提升。因此,只看 eval loss 做早停,可能恰好停在能力尚未充分释放的 checkpoint 上,这也是作者强调多跑 epoch 后需以可运行输出而非 loss 判断模型的原因。
SFT 与 RL 的成本之辩
作者并没有主张 SFT 优于 RL。他的观点更具体:如果你已经拥有覆盖目标领域的高质量样本,监督微调有可能以远低于 RL 的训练成本取得很好的效果。
代价当然存在——创建和验证这些样本本身就要投入大量时间,作者在这一环上花了不少精力。但一旦数据集成型,它可以复用、可以训练不同规模的模型、可以反复做实验,而不需要搭起整套 RL 流水线。
对于小型专精模型而言,这种路径的性价比值得更多关注。
SFT(监督微调) 与 RL(强化学习) 是两条常见的模型对齐/能力塑造路径。SFT 直接用“输入—期望输出”的样本对模型做监督训练,目标明确、流程简单;RL(如 RLHF、GRPO 等)则通过奖励信号引导模型探索,往往需要额外搭建采样、奖励模型和策略优化流水线,算力与工程成本更高。对于小型专精模型,SFT 的优势在于:只要已有覆盖目标领域的高质量样本,训练目标就是“复制这些样本的行为”,收敛快、可控性强,并且数据集可复用到不同参数规模的模型上。代价是前期数据构建与验证工作量大,且模型能力上限受样本覆盖范围限制。
消费级硬件上的全量微调
另一个有趣的发现是硬件门槛。350M 模型可以在仅有 8GB 显存的 GPU 上做全量微调,而非只能用 LoRA。配合合适的环境和内存优化,对于规模可控的数据集和上下文长度,训练只需几个小时。
上下文更长、数据集更大,训练时间会显著增加。但“在廉价消费级硬件上训练出有用的专精模型”这件事本身,已经足够有吸引力。
全量微调(full fine-tuning) 指更新模型全部参数,与只训练少量附加参数的 LoRA 等参数高效方法相对。全量微调通常需要存储完整参数的梯度与优化器状态,显存开销远高于 LoRA,因此大模型上往往不可行。对 350M 这样的小模型,结合梯度检查点、混合精度、优化器状态分片等内存优化手段,8GB 显存的消费级 GPU 也能容纳全量微调。全量微调的好处是不会受低秩适配的容量限制,模型能更充分地吸收领域数据,这对追求专精能力的小模型尤其有意义。
容量上限,还是训练方式的上限?
作者反复强调自己没有否定 scaling law,也不认为 350M 能替代大模型。局限是客观存在的。
但他提出了一个值得深思的问题:我们所认为的模型容量上限,有多少其实是训练方式的限制? 也许在很多任务上我们用了远超必要的大模型,仅仅是因为还没有充分探索小型专精模型能走多远。
这些模型仍在训练中,作者计划很快发布新模型和扩展后的 3D 数据集。如果 350M 继续进步到令他满意的质量,也会一并开源。
注:原帖由作者用葡萄牙语撰写,借助 AI 翻译为英文。
相关推荐
AI滥用警报:儿童性虐待材料报告两年飙升8400%
Hacker News 报道显示,AI 相关儿童性虐待材料报告两年内增长 8400%。本文分析生成式 AI 如何降低非法内容生产门槛,平台检测与法律监管面临的两难,以及技术对抗的可行方向。
AI员工工具泛滥,35人创业公司如何选出真正能落地的?
35人创业公司面对众多AI员工工具无从下手?本文提炼社区真实经验,从无人值守能力、集成深度、结果可验证性三个硬标准出发,帮你筛选真正能落地的AI员工工具,避免吃灰。
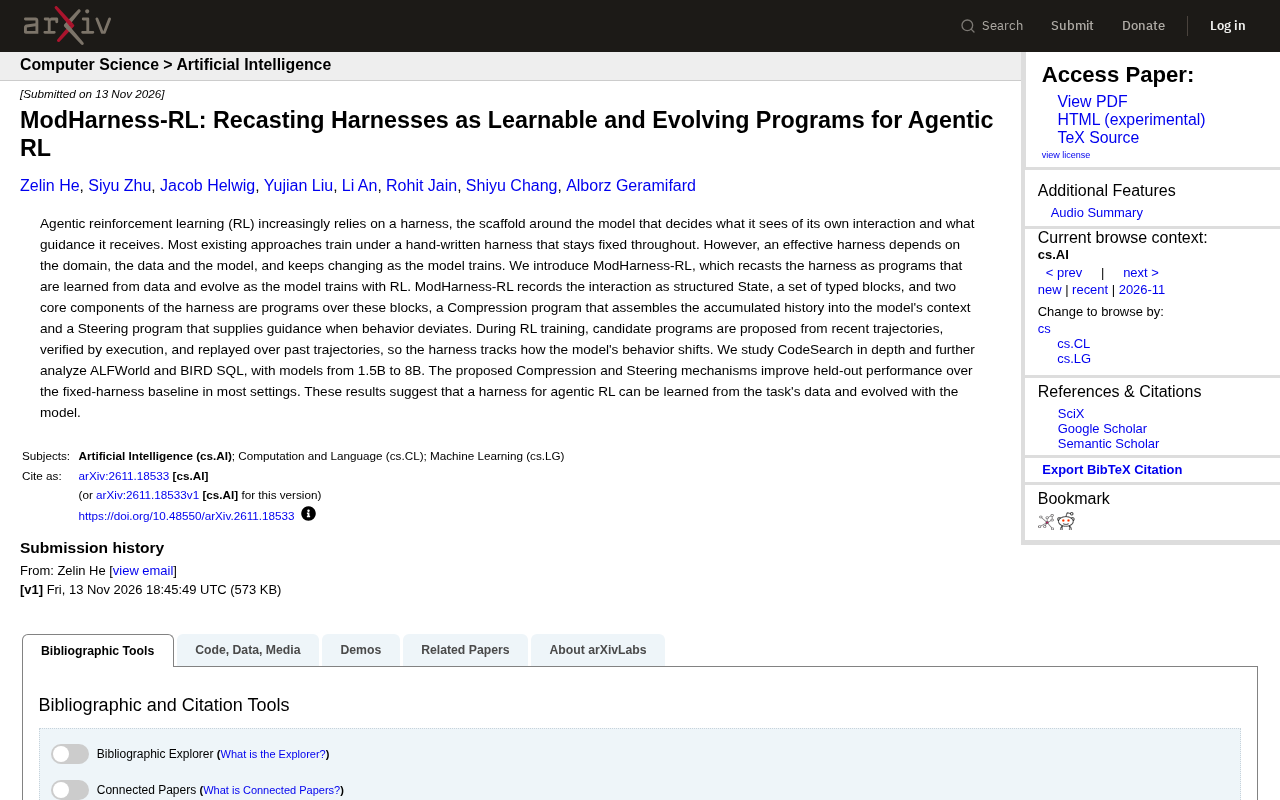
ModHarness-RL:让智能体训练框架自我进化
ModHarness-RL 将智能体强化学习中的 harness 重构为可学习、可演化的程序,通过压缩与引导两大机制及提议-验证-回放循环,在 CodeSearch、ALFWorld 和 BIRD SQL 任务上多数设置优于固定框架基线。