ModHarness-RL:让智能体训练框架自我进化
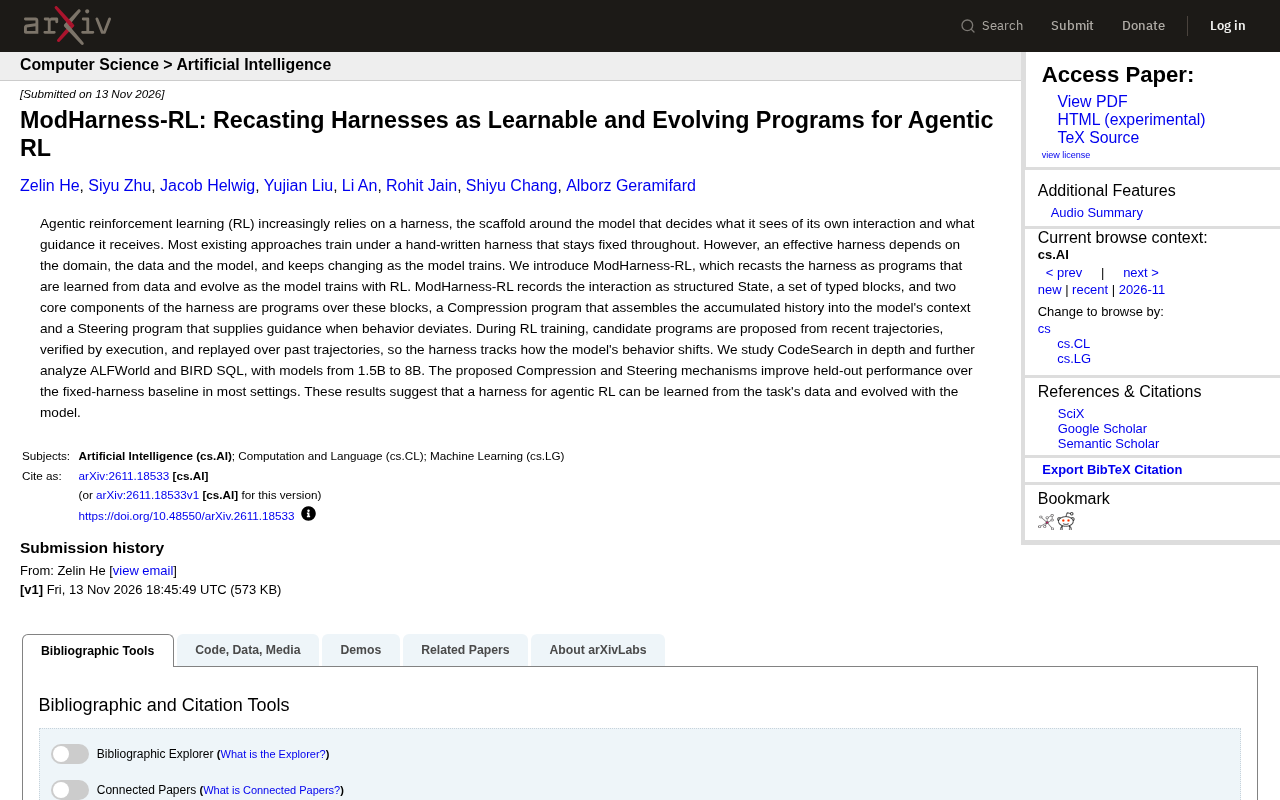
ModHarness-RL 将智能体 RL 的手写 harness 变为可学习、随模型演化的程序。
文章介绍 ModHarness-RL 这一方法,针对智能体强化学习中手写固定 harness 难以适配动态模型的瓶颈。该方法将 harness 重构为可从数据学习并随训练演化的程序,基于带类型的结构化状态表示,把压缩程序(决定模型可见的上下文)与引导程序(行为偏离时提供指导)作为核心可学习组件。训练上采用提议—验证—回放的循环,使 harness 能跟踪模型行为分布的变化。在 CodeSearch、ALFWorld 和 BIRD SQL 任务上,1.5B 至 8B 模型多数设置下留出集性能优于固定 harness 基线,支持了 harness 可与模型共同进化的假设。
智能体强化学习的瓶颈:手写框架的局限
在智能体强化学习(Agentic RL)中,模型并非在真空中训练——它依赖一个被称为 harness 的外围组件。这个“框架”决定了智能体能看到自己交互历史中的哪些部分,以及在行为偏离时接收何种引导信号。
目前的主流做法是使用一个手写且固定不变的 harness。然而,一个有效的 harness 高度依赖于任务领域、训练数据和模型本身,并且随着模型训练过程的推进,模型的行为模式也在不断变化。用一套静态规则去适配动态的模型,本质上是用昨天的地图找今天的路。
近期提出的 ModHarness-RL 正是针对这一矛盾:它不再将 harness 视为人工设计的常量,而是将其重新定义为可以从数据中学习、并随模型训练而演化的程序。
核心机制:结构化状态与双程序驱动
ModHarness-RL 的设计围绕两个关键抽象展开,让 harness 从“固定规则”转向“可学习程序”。
结构化状态(Structured State)
方法首先将智能体的交互记录为一种结构化的状态表示:一系列带有类型的块(typed blocks)。这种表示方式便于后续程序对这些块进行有选择地组合与操作,而不是将原始的历史文本一股脑塞进上下文窗口。
**带类型的块(typed blocks)**这一设计借鉴了程序语言与结构化数据处理的思路:每条交互记录(如模型的一次工具调用、环境返回的观察、系统提示)不再是一段自由文本,而是被赋予明确类型标签的独立单元。这样做的好处是,后续的压缩程序与引导程序可以针对特定类型的块进行检索、筛选、重排或截断,而不必对整段文本做模糊的摘要或截取。与常见的"滑动窗口截断"或"摘要压缩"相比,类型化表示保留了交互的语义边界,使程序化操作更精确、更可复现,也为学习出的程序提供了稳定的操作接口。
压缩与引导:两大核心程序
在结构化状态之上,harness 的两个核心组件被实现为针对这些块的程序:
- 压缩程序(Compression program):负责将累积的交互历史组装成模型最终接收的上下文。它决定了“模型能看到什么”。
- 引导程序(Steering program):当检测到行为偏离预期时,向模型提供指导信号。它决定了“模型在偏离时得到什么帮助”。
这两个程序共同构成了 harness 的行为逻辑,而 ModHarness-RL 的关键在于——它们不是写死的,而是从数据中学习出来的。
**上下文压缩(context compression)**在长程智能体任务中是一个刚性问题:交互轨迹往往远超模型上下文窗口,如何取舍历史信息直接决定模型能否保持任务连贯性。常见做法包括保留最近若干步、对历史做摘要、或按相关性检索。ModHarness-RL 的压缩程序把这一决策交给可学习逻辑,本质上是在学习一个"历史选择策略"。**引导(steering)**则不同于奖励信号——奖励作用于参数更新,而引导是在推理时注入的即时提示,用于把偏离的智能体拉回正轨,二者在时间尺度与作用对象上互补。
训练循环:提议、验证与回放
ModHarness-RL 如何在 RL 训练过程中实现框架的演化?其流程可以概括为三个步骤的循环:
- 提议(Propose):从最近的轨迹中产生候选程序。
- 验证(Verify):通过实际执行来验证候选程序的有效性。
- 回放(Replay):在过往轨迹上重放程序,观察其表现。
这一循环使得 harness 能够跟踪模型行为的变化。随着训练推进,模型的行为分布发生偏移,harness 也随之调整自身的压缩和引导策略,形成一种“共同进化”的关系。
这种设计避免了手工设计 harness 时常见的困境:设计者需要预判模型在整个训练过程中可能出现的行为模式,而这在复杂任务中几乎不可能做到。
这里的**回放(replay)**与强化学习中的经验回放(experience replay)有相通之处,但目标不同:经验回放用于稳定价值估计,而此处的回放是把候选 harness 程序放到历史轨迹上重新执行,以评估其在不同模型行为分布下的表现。**验证(verify)**同样值得注意——候选程序需通过实际执行而非静态打分来筛选,这能避免"看起来合理但运行出错"的程序被采纳,也契合了将 harness 视为可执行程序而非提示模板的核心定位。
实验证据:多数场景下优于固定框架
研究者在多个任务上评估了 ModHarness-RL,覆盖从 1.5B 到 8B 参数规模的模型:
- CodeSearch:作为重点分析任务,进行了深入实验。
- ALFWorld:文本环境中的具身决策任务。
- BIRD SQL:复杂的文本到 SQL 生成基准。
实验结果显示,所提出的压缩机制和引导机制在大多数设置下提升了留出集(held-out)性能,优于固定 harness 的基线方法。这一结果支持了核心假设:智能体 RL 的 harness 可以从任务数据中学习,并随模型一起演化。
论文作者总结道:“这些结果表明,agentic RL 的 harness 可以从任务数据中学习,并与模型一同进化。”
留出集(held-out)性能指在与训练数据分布不同、未参与训练的评测集上的表现,用它衡量 harness 的价值尤为关键:若提升仅出现在训练任务上,可能只是 harness 过拟合了特定轨迹;而在留出集上仍优于固定基线,说明学到的压缩与引导策略具备一定泛化能力。文中 1.5B 至 8B 的模型跨度也有意义——它检验了方法在小模型与大模型上是否同样有效,而非仅对某一规模成立。
行业启示:从固定脚手架到可学习组件
ModHarness-RL 的思路触及了智能体训练中一个常被忽视的层面。当前社区对 RL 算法的改进、奖励模型的设计、环境构建的讨论较多,但对“模型如何感知自身历史”这一问题的关注相对有限。
将 harness 本身视为可学习对象,意味着智能体系统的设计空间从“模型权重 + 固定外围逻辑”扩展为“模型权重 + 可演化外围程序”。这带来几个值得思考的方向:
- 领域自适应:不同任务对上下文压缩和引导的需求差异巨大,可学习 harness 有望减少人工调参成本。
- 训练动态对齐:模型在训练中会经历能力跃迁或行为漂移,固定 harness 容易成为瓶颈,演化式 harness 则能持续匹配模型当前状态。
- 可解释性挑战:当 harness 从手写规则变为学习出的程序,理解模型为何做出特定行为变得更加复杂,可能需要新的分析工具。
目前该方法在 CodeSearch、ALFWorld 和 BIRD SQL 上的验证仍属初步,但其核心洞察——harness 不应是训练中的常量——对智能体 RL 的系统设计具有普遍参考价值。
相关推荐
AI滥用警报:儿童性虐待材料报告两年飙升8400%
Hacker News 报道显示,AI 相关儿童性虐待材料报告两年内增长 8400%。本文分析生成式 AI 如何降低非法内容生产门槛,平台检测与法律监管面临的两难,以及技术对抗的可行方向。

4B小模型专精训练,能否替代大模型?
一位开发者通过训练 Qwen3.5-4B-3D-Coder 与 LFM2.5-350M 发现,专精小模型在 3D 场景生成等任务上表现超出预期。本文解析其关于 epoch 数量、SFT 与 RL 成本对比、以及消费级硬件全量微调的观察。
AI员工工具泛滥,35人创业公司如何选出真正能落地的?
35人创业公司面对众多AI员工工具无从下手?本文提炼社区真实经验,从无人值守能力、集成深度、结果可验证性三个硬标准出发,帮你筛选真正能落地的AI员工工具,避免吃灰。