5.5小时造个实习诈骗侦探:TrustIntern 如何让 AI 解释风险
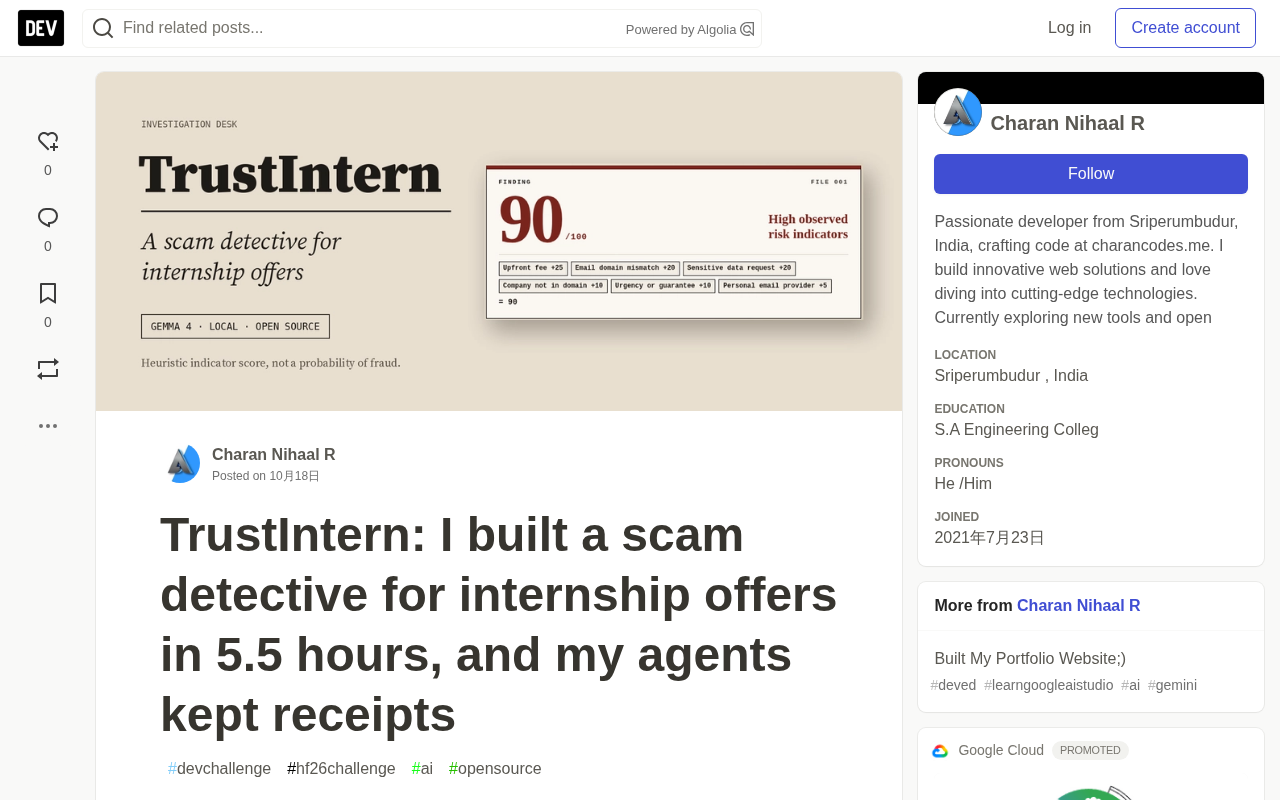
开发者用 5.5 小时造出多智能体反实习诈骗工具,规则计分、AI 只做规划。
TrustIntern 是开发者 charancodes 在黑客松中用 5.5 小时构建的反实习诈骗调查工具,针对印度学生遭遇的假 offer 骗局。其核心设计是把风险打分交给确定性规则代码(预付费用 +25、域名不匹配 +20 等),每个扣分点都绑定触发它的原句,任何人可手工复算;Gemma 4 只负责规划智能体与读取 PDF/截图,永不参与计分。架构上采用白名单约束的规划器,最多 8 个智能体、深度 2 层、约 45 秒,模型不可达时启发式回退。商业模式上学生免费,向高校、招聘平台 API 和事后复盘报告收费。项目还用 Entire 记录构建过程,AI 审稿人意外发现了作者在 Gemma 集成中的真实盲点。
实习季一到,印度学生群里就会冒出这样的消息:「恭喜你被我们公司录取!请支付 1999 卢比注册费确认席位,并分享你的 Aadhaar 和验证码。offer 仅 24 小时有效。」发件人是 Gmail,公司官网是一个月前才建的。它之所以有效,是因为急着给简历添第一行的学生,最不可能停下来核实。
开发者 charancodes 用一个周末 5.5 小时构建了 TrustIntern——一个用多智能体 OSINT 和可解释评分来拆穿这类骗局的「调查台」。这个项目在 Hacktoberfest 第二周的 Side Hustle 赛道中,同时押注 Best Use of Gemma 和 Best Use of Entire。
从「能跑完」到「能赢」:一个关键转折
项目启动时,作者给 Cursor 智能体的提示词简单粗暴:「这个计划必须帮我赢下黑客松,所以给我最好的计划。」智能体的回复改变了整个项目的方向:「当前计划能做完,但赢不了。评委能亲手复算的评分,加上每个扣分点旁边对应的原句,才是其他队伍不会有的东西。」
这句话直接催生了 scoring.py。TrustIntern 的核心不是让大模型「感觉」这个 offer 可疑,而是把风险拆成固定规则:预付费用 +25、邮箱域名不匹配 +20、索取敏感数据 +20、制造紧迫感或保证 +10、使用个人邮箱服务 +5。所有分数相加封顶 100,且每一项都绑定触发它的那句話。
为什么不让 Gemma 打分?
项目里有一条写死在 CONTRACT.md 里的「不可协商的评分边界」:Gemma / OSINT 永远不发明扣分项。gemma_client.py 的文档字符串只有四个词:Never scores。
Gemma 4 负责的是「思考」而非「算账」:它作为规划器,根据固定检查器的结果决定启动哪些研究智能体(公司、招聘者、投诉、域名、文档、追问);它作为多模态读取器,直接读 PDF 或手机截图里的 offer 内容。真正把分数加起来的,是确定性的、任何人都能手工重算的规则代码。
这种设计的取舍很明确:在一个会告诉学生「这个 offer 看起来有风险」的工具里,可审计比聪明更重要。
OSINT(Open-Source Intelligence,公开来源情报)指的是从公开可获取的信息中收集、关联和分析情报的方法。在 TrustIntern 的语境里,OSINT 智能体不是去入侵或访问任何私有系统,而是查询域名注册记录(RDAP)、公司公开信息、招聘者公开资料、投诉平台记录等任何人理论上都能自行查到的数据。传统 OSINT 依赖人工逐项检索,耗时且容易遗漏;多智能体 OSINT 则把「查公司」「查招聘者」「查域名」「查投诉」拆成独立智能体并行执行,再由规划器根据已有发现决定下一步查什么。这一思路的关键优势是可追溯:每个智能体的查询目标与返回结果都能记录在案,形成证据链,而不是一个黑箱给出「可疑」结论。
多智能体如何协作:规划、执行与实时流
TrustIntern 的架构可以拆成四层。
固定检查器先行
在启动任何智能体之前,系统先跑一轮不依赖大模型的检查:招聘邮箱域名与公司是否一致、域名注册时间(通过 RDAP)、网站本身、以及消息文本的措辞。这些结果进入一个「证据账本」。
RDAP(Registration Data Access Protocol,注册数据访问协议)是 WHOIS 的标准化继任者,由 IETF 定义,用于查询域名和 IP 地址的注册信息,返回结构化 JSON 而非 WHOIS 的自由文本。通过 RDAP 可以获取域名的注册日期、注册商、最近变更时间等字段。对反诈骗场景而言,最关键的是域名注册时间:一个声称是知名企业招聘页面、却在一个月前才注册的域名,本身就是强风险信号。文章开头提到的「公司官网是一个月前才建的」正是这类检查器要自动捕捉的特征。相比 WHOIS,RDAP 的 JSON 输出更容易被程序解析和纳入证据账本,也支持更规范的速率限制与认证机制。
Gemma 4 规划有边界的智能体
规划器读取检查器发现,再决定下一步派哪个智能体:出现招聘者名字就查人,出现陌生域名就查域名。关键约束在于 allowlist 白名单——正如 registry.py 所写,「规划器给出的未知类型永远不会被执行」。同时硬性限制最多 8 个智能体、深度不超过 2 层,整体墙钟时间约 45 秒。
如果模型完全不可达,一个启发式规划器会接管,调查仍然能跑完。
混合部署与实时流
本地开发时,作者用 Ollama 在自己的笔记本上跑 gemma4:e2b,速度很快。托管演示无法访问他的笔记本,于是回退到通过 Google Gemini API 提供的 Gemma 4(gemma-4-26b-a4b-it),同属开放权重家族。
调查过程通过 SSE(Server-Sent Events)实时推送到前端:先出现检查器事件,再是派生的智能体,最后是发现。前端用 Vite + React 搭调查台,jsPDF 负责导出 PDF 报告。
SSE(Server-Sent Events)是一种基于 HTTP 的单向服务器推送技术,服务器在一个长连接上持续向浏览器发送 text/event-stream 格式的事件。与 WebSocket 的双向通信不同,SSE 只做服务器到客户端的推送,协议更简单、可自动重连,且能直接复用普通 HTTP 基础设施。TrustIntern 用它把调查过程逐步推给前端:检查器事件、智能体派生、发现结果依次出现,用户看到的是一个「正在调查」的实时过程,而不是等待数十秒后突然弹出结论。这种渐进式呈现对建立信任很重要——用户能亲眼看到每一步查了什么、得到了什么,而不是只面对一个最终分数。
商业逻辑:保护学生免费,向机构收费
TrustIntern 的定价有意避开被诈骗的目标人群。
- 学生免费:被针对的人不应该为保护付费,本地 Gemma 让运行成本几乎为零。
- 高校和就业指导中心付费:批量核验学生 WhatsApp 群里流传的 offer,每份生成可分享的报告。
- 招聘板和实习平台付费 API:在上线前筛查职位和招聘者账号。
- 事后复盘报告一次性收费:给已经受骗的人一份带证据的完整记录,可以附在向学校、平台或网络犯罪门户的投诉中。
最后这个点子不是作者想出来的,而是来自第一位测试者。这位早期用户反馈说:「这能阻止实习诈骗影响到不明真相的人,也能为更清醒的人变成一份复盘报告。」于是「复盘模式」直接进了定价计划。目前尚无付费客户,产品处于免费 beta 阶段。
诚实记录:AI 审稿人抓到 AI 作者的真 bug
这个项目最值得看的部分,是它保留了完整的「收据」——开发者用 DevRelay 存档了智能体会话,用 Entire 把智能体工作绑定到 git 提交上。
13 个提交带有 Entire-Checkpoint: 尾注,仓库里配置了六个 trail runner(Risk、Security、Drift、Confidence、Review、Summary),每次推送 PR 分支都会运行并把分数贴到该 PR 的 trail 上。
有意思的是,一个 AI 审稿人抓到了 AI 作者在 Gemma 集成里的真实盲点。在 backend/app/agents/planner.py:141 上,一条中等级别的发现写道:规划器摘要只设置了 had_pdf,从未报告上传了图片。当 Gemma 作为规划器时,面对纯图片上传它只看到 had_pdf=false,可能因此决定不启动视觉智能体,截图就永远不会被读取。
这正是作者为赢下 Gemma 类别而构建的功能。 作者本人形容这很「打脸」:AI 作者写的代码盲点,被 AI 审稿人在同一个功能里逮到。had_image 修复被排在待办清单最前面。
用 entire search 解释代码为何存在
当作者忘记某段代码为什么是这样时,他不去 grep 代码,而是搜索智能体历史:
$ entire search --json --compact fallback
→ 1821b7f  Add spawn planner with Gemma path and heuristic fallback.

$ entire search --json --compact vision
→ eed6eba  Let Gemma vision read an offer screenshot as well as a PDF.
→ 5c8fe31  Switch Gemma to local Ollama and ship PDF reports on Vercel.
不过作者也坦承踩了坑:他写的捕获钩子是 Windows 专用的 cmd.exe 单行命令,早期设置会话触发后就静默了,13 个检查点的提交链接正确,但里面的转录内容只保留了设置提示。顾问智能体直白地告诉他:「你无法追溯重新注册这些内容单薄的检查点。」所以 DevRelay 会话才是这个项目真正的构建记录,Entire 提供的是骨架。
Trail runner 在这里指的是一组在每次推送 PR 分支时自动运行的检查器,各自从不同维度评估变更并给出分数,结果贴到该 PR 的 trail 上。六个 runner 的分工大致是:Risk 评估变更引入的风险面,Security 检查安全隐患,Drift 检测代码与既定契约或设计意图的偏离,Confidence 衡量变更的可信度或测试覆盖,Review 做类代码审查的质量判断,Summary 生成变更摘要。它们与传统的 CI 测试不同——测试判断「是否通过」,trail runner 更像持续演进的审查记录,把每次变更的判断依据留痕。也正因如此,Review runner 才能在 planner.py:141 上指出规划器摘要遗漏 had_image 这类逻辑盲点,而普通单元测试未必覆盖得到。
开源为什么重要
作者把开放创新的价值归结为四点,每一点都落在具体设计上。
**隐私。**Offer letter 里有姓名、地址,有时还有身份证号。Gemma 4 通过 Ollama 本地运行时,这些文档永远不离开笔记本。
**成本。**学生免费层只有在单次检查成本接近于零时才成立,开放权重模型跑在自己的硬件上让这件事可行。
**模型可替换。**规划器对接的是「一个 Gemma」,不是某家厂商的端点:本地 gemma4:e2b、Gemini API 上的 Gemma 4,或者完全没有模型时的启发式回退。
**可审计评分。**最重要的部分根本不是 AI,而是 scoring.py 里任何人都能读、能重算的确定性规则。
下一步
项目的路线图包括:复盘报告模式(按投诉格式整理事件时间线)、WhatsApp/Telegram 转发器(让学生在 offer 真正到达的地方核验)、面向就业中心的批量核验,以及修复审稿人发现的问题——had_image 排在第一位。
代码以 MIT 协议开源,API 契约(含评分规则)在 backend/CONTRACT.md。这个项目的启示或许不只在反诈骗:当 AI 智能体开始写代码,可复算的规则层和完整的构建留痕,可能比模型本身更能决定一个产品是否值得信任。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。