512GB DDR5内存仅16瓦功耗:本地大模型的想象空间
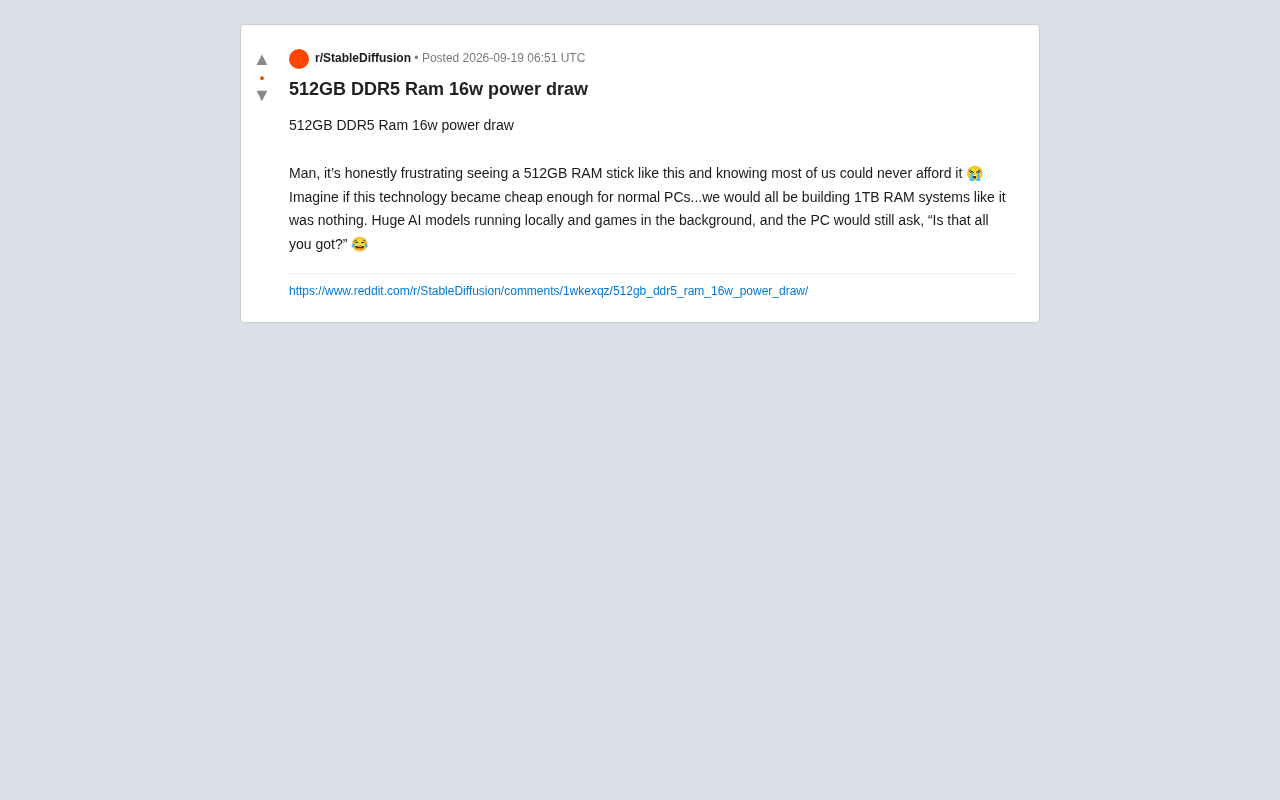
512GB DDR5内存仅16瓦功耗引发热议,价格门槛仍是本地大模型普及的核心障碍。
一张展示512GB DDR5内存、功耗仅16瓦的截图在Reddit引发广泛讨论,折射出AI爱好者对高容量低功耗内存的真实渴望。本地运行大语言模型的核心瓶颈之一是内存容量——即便经过量化压缩,数百亿参数的模型仍需占用数十乃至上百GB空间,而大容量系统内存正是在没有专业显卡的情况下运行大模型的现实路径。16瓦的低功耗使全天候本地AI推理服务器在理论上更具可行性,但此类内存模组面向服务器市场,定价高昂且与消费级平台不兼容。行业规律表明,服务器规格下沉至消费市场需要数年时间,"1TB内存轻松装机"的愿景短期内仍是畅想,而硬件成本的下探将是本地AI能否真正普及的决定性变量。
一根内存条引发的讨论
一张展示512GB DDR5内存、功耗仅16瓦的截图在Reddit上引发热议。发帖者的感慨颇具代表性:这样的硬件规格令人向往,但对大多数普通用户而言价格依然遥不可及。
帖子里那句半开玩笑的设想很能引起共鸣——如果这类技术便宜到能进入普通PC,大家都会像装机时不假思索那样搭建1TB内存的系统,本地跑巨大的AI模型、后台挂着游戏,电脑还嫌不够。这种夸张背后,反映的是当下用户对高容量、低功耗内存的真实渴望。
为什么大容量内存对AI这么重要
本地运行大语言模型的核心瓶颈之一就是内存容量。模型参数需要加载到内存(或显存)中,参数量越大、精度越高,占用的空间就越多。一个数百亿参数的模型即便经过量化,也可能吃掉数十甚至上百GB的空间。
对于没有专业级显卡的用户来说,把模型加载到系统内存、用CPU推理,是运行大模型的一条现实路径。虽然速度不及GPU,但容量优势明显——512GB内存意味着能容纳远超消费级显卡显存所能承载的模型规模。这正是帖子作者畅想"本地跑巨大AI模型"的技术逻辑所在。
量化(Quantization)是目前让大模型在消费级硬件上可用的主流技术手段。它通过降低模型参数的数值精度——例如从32位浮点数(FP32)压缩为8位整数(INT8)甚至4位(INT4)——来大幅减少模型的内存占用和计算量,代价是轻微的精度损失。以一个700亿参数的模型为例,FP16精度下需要约140GB存储空间,经过4位量化后可压缩至约35GB左右,使其在消费级平台上成为可能。llama.cpp等工具正是通过CPU+系统内存的推理路径,配合激进的量化策略,让普通用户得以在没有专业显卡的情况下运行规模可观的本地模型。因此,系统内存容量的上限,直接决定了用户在不牺牲更多精度的前提下能跑多大的模型。
16瓦功耗意味着什么
截图强调的另一个亮点是功耗——512GB容量却只有16瓦的功率消耗。对于需要长时间开机、持续运行推理任务的场景,功耗直接关系到电费成本和散热压力。
低功耗高容量的组合,理论上让"7×24小时本地AI服务器"这类家用部署变得更具可行性。不过需要理性看待:这类高密度、高规格的内存模组通常面向服务器和数据中心市场,其定价、接口和主板兼容性都不是消费级平台能直接对接的。功耗数字虽然诱人,但它服务的场景与普通PC存在本质差异。
DDR5相较于上一代DDR4在能效比上有显著提升,标准工作电压从DDR4的1.2V降至1.1V,这使得在相同容量下功耗有所下降。服务器领域普遍采用的RDIMM(Registered DIMM)和LRDIMM(Load-Reduced DIMM)规格通过在内存条上增加缓冲芯片,支持更高的单条容量(128GB乃至256GB),但这类模组需要搭配支持ECC和注册内存的服务器主板与志强(Xeon)或EPYC等平台处理器,与消费级的Z系或X系主板在物理接口和电气规范上均不兼容。这正是文中提到"接口和主板兼容性"问题的具体所指——即便资金充裕,普通DIY玩家也无法将这类内存直接插入家用电脑。
价格才是真正的门槛
帖子情绪的落点其实很清晰:技术已经存在,卡住普通人的是价格。企业级大容量内存的单价长期居高不下,512GB这样的规格往往对应四位数甚至更高的美元售价,远超主流装机预算。
从行业趋势看,内存容量的普及总是遵循"先服务器、后消费级,先高价、后平价"的路径。今天属于数据中心的规格,若干年后可能下沉到高端桌面平台。但"1TB内存装机毫无压力"的愿景,短期内仍停留在玩笑与畅想的层面。
社区情绪背后的真实需求
这条帖子之所以能引发共鸣,不在于它提供了多少技术细节,而在于它精准戳中了AI爱好者群体的痛点:想在本地掌控自己的大模型,却被硬件成本挡在门外。
随着开源模型越来越多、本地部署工具越来越成熟,普通用户对内存容量的需求正在被真实地激发出来。这类讨论也从侧面说明,硬件成本的下探将是本地AI能否真正普及的关键变量之一。当高容量内存有一天变得触手可及,本地大模型的玩法或许会迎来一次真正的爆发。
本地部署大模型的生态近两年已相当成熟。Ollama、llama.cpp、LM Studio等工具极大降低了技术门槛,用户只需数条命令即可在自己的机器上运行Llama、Mistral、Qwen等开源模型,数据不经过任何云端服务。这种"数据本地化"的诉求不仅来自隐私敏感用户,也来自希望在无网络环境下使用AI、或者希望对模型行为有完全掌控权的开发者和研究者。正是这一群体的持续增长,使得内存容量从一个过去几乎只有专业人士关注的参数,变成了普通装机讨论中越来越常见的话题。
相关推荐
Vibe Coding实战:培养产品思维,用AI把日常需求变成能变现的APP
Vibe Coding系列教程第二篇,讲解独立开发者如何培养产品思维、从模仿与生活痛点中发现需求,并用AI Agent自动化调研流程,快速判断一个APP创意是否值得投入开发与变现。
OpenAI Codex 上手指南:用AI代理构建并部署应用
OpenAI Codex 速成课中文整理:从安装、价格套餐、插件与自动化,到 Plan/Go 命令、技能系统,并实战演示用声控 Flappy Bird 游戏走通构建与部署全流程,帮你真正上手这款自主 AI 编码代理。
ICLR投稿量突破5万:AI顶会为何持续爆炸式增长
ICLR 投稿编号逼近 5.1 万引发 Reddit 热议。本文分析 AI 顶会投稿量爆炸式增长的原因、对评审系统的压力,以及数字背后的行业信号与反思。