5个实战AI项目,打造求职级AI工程师作品集

五个免费AI工程项目助你打造脱颖而出的作品集,强调深度测试与诚实记录。
文章针对AI工程求职者作品集同质化的问题,提出五个免费且能展示真实工程思维的项目:系统评估的RAG系统、本地小模型对比基准、MCP服务器构建、谨慎微调以及成本与延迟仪表盘。每个项目都强调正确测试、记录尝试过程、注明硬件和软件版本,并诚实说明不足。文章指出,两到三个深度构建的项目比五个浅薄项目更有说服力,招聘经理更看重展示决策过程和限制应对的作品集。
为什么你的AI项目作品集总被忽略?
如果你正在尝试进入AI工程领域,可能已经注意到一个现象:大量简历上列出的项目惊人地相似——一个聊天机器人、一个基于RAG的PDF问答工具、一个薄薄的API封装课程项目。据YouTube频道分析,招聘经理已经看过无数次同样的模式,这类项目往往融入背景,而不是脱颖而出。
真正能让你与众不同的,不是项目有多复杂,而是每个项目都推动你做出正确决策、触及真实限制并真正修复它们——就像在实际工作中一样。但需要明确:这些是扎实的学习项目,不是保证录用的公式。它们的价值在于正确测试、记录尝试过程、注明硬件和软件版本,并诚实地说明每个项目的不足。仅这个习惯就能让你领先大多数作品集。
下面五个项目,每个都针对AI工程中的关键能力,且完全免费。
项目一:RAG系统——测试比演示更重要
检索增强生成(RAG)无处不在,所以这不是什么隐藏瑰宝。但一个扎实的RAG项目与复制粘贴教程的区别,在于一个习惯:每次都按相同方式测试,而不是只展示几个好答案。
选择一个真实文档集——公司帮助文章、法律档案或开源项目文档。构建简单流水线:分块、嵌入、检索相关片段、让模型仅基于检索到的上下文生成答案。但这本身不会让人印象深刻。接下来才是关键:自己编写约50个基于文档的问题,并附上已知正确答案,形成固定测试集。注意50题样本仍然较小,如果时间允许,按难度分组或扩展集合,避免一个幸运或不幸的答案大幅摆动分数。
运行基础流水线,看看得分。然后一次只改一个变量:用语义分块替代固定分块;在向量搜索之外加入关键词搜索(嵌入擅长理解语义,但常错过需要逐字匹配的产品代码或法律条款);添加重排序步骤,让最佳片段在到达模型前排在最前。
需要理解的是,RAG系统的准确性不是一个数字。检索是否拉取了正确文档?重排序是否把最佳片段放在首位?最终答案是否正确?答案是否基于检索内容?模型是否自信地编造?这些相关但不同的指标应分开追踪。工具Ragas常用于自动评分忠实度和相关性,但它不是官方行业标准,分数会随评判模型变化。将其视为一个有用信号,再亲自抽查部分答案。
更进一步:将测试集接入脚本,每次代码推送自动运行,分数低于阈值则构建失败。这让你一窥生产团队的工作方式,而这在作品集项目中很少见。适用工具包括Chroma(存储嵌入)、sentence-transformers或Cohere的重排序器、Ragas作为评估起点,全部免费。
项目二:本地小模型对比——真实基准而非感觉
先思考一个问题:当OpenAI和Anthropic的托管API触手可及,为什么有人要在自己的笔记本上运行小模型?许多公司不能将某些数据发送到外部系统——医疗记录、财务数据、法律文件、内部代码,加上数据驻留规则,使外部API根本不可行。延迟和可预测成本也很重要。大多数初级候选人从未认真考虑这些约束,而展示你能考虑它们本身就很有价值。
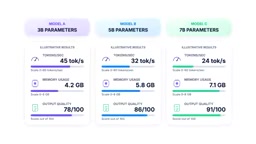
第一步,安装Ollama或LM Studio——在Windows、macOS或Linux上本地运行开源模型的简单方式。选择一个相对小型的模型,例如约32亿到70亿参数,围绕它构建基本界面。但要注意:这个范围不是“小”的严格定义。模型需要多少内存很大程度上取决于量化级别、上下文窗口长度和运行时设置。撰写项目时务必具体:注明确切模型版本、量化格式、上下文窗口、硬件和批次大小。这个细节让基准可信,而不是单纯声称。
真正的项目是对比。选择两到三个该范围内的模型,在相同硬件上运行相同问题。测量每秒token数、内存使用量,然后在相同的30个测试提示上评判输出质量。用对比表写出来。为给定约束选择正确模型是每个AI团队定期面临的决策,用真实数字而非直觉做这件事,正是引人注目的思维方式。
进一步:强制结构化输出。让模型每次返回有效JSON,用Pydantic验证,并为不干净返回构建重试步骤。“约束-验证-重试”模式在真实系统中频繁出现,但在学生个人作品中很少见。
量化(Quantization)是将模型权重从高精度浮点数(如FP16)转换为低精度格式(如INT8、INT4)的过程,能显著减少模型的内存占用和存储需求,通常以轻微的质量损失换取更快的推理速度和更低的硬件门槛。常见的量化方法包括GPTQ、AWQ和GGUF格式,不同量化级别(如Q4_K_M、Q5_K_M)在精度和效率之间提供不同权衡。在本地运行小模型时,量化级别直接影响所需显存、每秒token数以及输出质量,因此撰写基准报告时必须明确记录量化格式和级别,否则不同环境下的结果无法比较。上下文窗口长度同样影响内存分配,因为键值缓存(KV Cache)会随序列长度线性增长,进一步占用显存。
项目三:为你真正使用的工具构建MCP服务器
这个项目被低估,主要因为人们每天使用此类工具却从未构建过。模型上下文协议(MCP)是一种标准,让AI模型调用特定工具与外部系统交互——比如查询数据库或访问GitHub、Notion等登录后的应用。注意:没有MCP并非不可能回答这些问题,你可以写脚本或用GitHub自身API。MCP提供的是标准化、模型可调用的方式来暴露这些工具,让AI自行决定何时及如何使用,而不是你在每个工作流中硬编码。
选择你实际使用的东西。比如你有15个仓库,想用自然语言问“所有仓库中有多少未解决问题”。构建MCP服务器,给模型这些特定工具:列出仓库、获取问题、也许发表评论。从只读开始。任何可能更改或删除数据的操作都应放在明确确认步骤之后,符合通用MCP安全指南——验证输入、控制访问、限流、清理输出、记录活动。
基础工作后,认真测试。构思约50个真实请求,跟踪模型选对工具的频率、选错的频率、调用彻底失败的频率。如果想深入,检查参数正确性、如何处理认证和通信失败、对检索数据中隐藏的提示注入的抵抗力,以及是否跨用户或仓库泄露信息。然后写下发现和修复措施。这个项目告诉招聘经理:你真正理解聊天界面之下的层,而不仅仅是写好提示。
提示注入(Prompt Injection)是一种针对LLM应用的攻击方式:攻击者将恶意指令隐藏在模型会读取的文本中(如用户输入、检索到的文档或工具返回的数据),诱导模型偏离原始任务,执行非预期的操作,例如泄露敏感信息或调用危险工具。在MCP服务器场景中,风险尤为突出,因为模型可以主动调用工具访问外部系统。防御措施包括:对工具返回的内容进行清理和转义,限制工具权限(如只读),在执行敏感操作前要求用户确认,以及对模型输出进行结构化验证。测试时应有意识地构造包含隐藏指令的文档或用户输入,观察模型是否会执行这些指令,并记录修复措施。
项目四:谨慎微调——只在值得的地方
需要坦诚:微调主要改变模型在特定狭窄任务上的行为。它可以编码新信息,但通常不是频繁变化或引用敏感知识的最佳选择——检索或数据库通常更合适。它不会让模型在一般意义上更聪明。粗心操作可能因过拟合或让模型忘记以前擅长的事情而变得更糟。
所以,在碰训练脚本之前,证明差距存在。选择一个狭窄任务,比如从杂乱文本中提取结构化字段,或提高模型选择正确工具并填写正确参数的可靠性。用最佳提示测试基础模型,准确记录不足。然后整理干净训练集。需要多少示例取决于任务:狭窄任务可能几百个好示例就有实际提升,而更广泛的任务可能需要数千或更多。没有单一魔法数字,所以先关注标签质量和一致性。
使用LoRA或QLoRA进行实际微调。两者只更新少量附加参数而非整个模型,相比全量微调显著降低内存和存储需求。但硬件声明要小心:LoRA或QLoRA可以让合适大小的模型在单张消费级GPU上微调变得现实,但这取决于模型大小、量化、序列长度、批次大小和可用VRAM。较小模型可能在普通GPU上舒适微调,较大模型可能需要更多内存或较慢的GPU卸载设置。
在保留测试集上用具体指标评估——提取任务用精确匹配或字段级准确率,JSON有效性率,或模型选择正确工具和参数的准确率。并排展示前后对比。附有真实数字的对比是工程成熟度最清晰的信号之一。
进一步:可以添加小型偏好调优阶段,使用DPO(直接偏好优化),向模型展示成对响应并教它哪个更受偏好。当前工具包括支持将DPO与LoRA结合的Hugging Face库。这不是必需的,但显示你对当前领域积极使用的技术有认知。
LoRA(低秩适应)通过在原始模型权重旁注入小型低秩矩阵来微调模型,训练时只更新这些新增参数,从而大幅减少可训练参数量和内存需求。QLoRA在LoRA基础上进一步将基础模型量化为4位,使得在单张消费级GPU上微调较大模型成为可能,同时保持接近全量微调的性能。关键参数包括秩(rank)、alpha、目标模块和 dropout,它们影响微调效果和资源消耗。DPO(直接偏好优化)是一种对齐方法,使用成对的偏好数据(一个被选中的回答和一个被拒绝的回答)直接优化模型,无需训练奖励模型,比传统的RLHF更简单稳定。将DPO与LoRA结合,可以在有限资源下进行偏好调优。
项目五:成本与延迟仪表盘——几乎没人做但最有说服力
这是几乎没人构建的项目,却往往最能说明你的思维方式。拿上面四个项目中的任何一个,在其上添加监控层。首先理解心态转变:构建系统只是工作的一部分,其余是知道它是否在工作、为什么坏了、多快能发现。
对通过流水线的每个请求进行埋点,这样对于任何单个查询,你能看到检索了什么、发送了什么提示、执行了什么、用了多少token。随时间正确跟踪。使用P50、P90、P95等百分位测量延迟,而不仅仅是平均值——平均值隐藏最坏时刻。如果可能,进一步分解为检索时间与生成时间加首token时间,因为这些指向不同瓶颈。同时跟踪错误率和超时率以及token计数。
成本方面,框架要小心。对于OpenAI或Anthropic的托管API,你可以根据提供商当前定价按token相当精确地计算真实成本;但对于本地运行的模型,没有干净的单请求美元数字,因此估算电力和硬件成本,并明确标记为估算而非精确值。
目标很简单:如果有人问“上周二出了什么问题”,你应该能调出仪表盘,指出事情开始退化的确切时刻,然后解释原因。这与只说“演示能跑”是截然不同的故事,也是那种在面试中引发真正有趣后续问题的项目——因为它表明你在思考整个系统,而不仅仅是中间的模型。
百分位延迟(如P50、P90、P95)是衡量系统响应时间分布的统计指标。P50(中位数)表示50%的请求延迟低于该值;P90表示90%的请求延迟低于该值,以此类推。与平均值相比,百分位能更好地揭示长尾延迟,即少数极慢请求对用户体验的影响。在AI系统中,检索和生成阶段可能具有不同的延迟分布,因此分解测量(如检索时间、生成时间、首token时间)有助于定位瓶颈。首token时间(Time to First Token)是流式生成场景的关键指标,直接影响用户感知的响应速度。跟踪错误率和超时率同样重要,它们与延迟共同构成系统可靠性的完整视图。
结语:深度胜过数量
五个项目分别是:针对真实固定评估集测试的RAG系统;有实际基准和清晰硬件细节的本地模型对比;针对真实工具调用场景测试的MCP服务器;有恰当证明差距和诚实硬件预期的微调项目;以及叠加在任何一个项目上的成本与延迟仪表盘。
你不需要同时做全部五个。两到三个以真正深度构建、诚实测试并清晰记录的项目,比五个浅薄项目产生更强印象。最重要的不是项目是否完美运行,而是你能否解释为什么做出那些选择、过程中实际坏了什么、你的数字到底意味着什么。构建真实的东西,正确测试,然后诚实面对发现。如果深入做其中任何一个,你的作品集会比其他人更耀眼。
据该YouTube频道观点,这些项目之所以有效,是因为它们模拟了真实工作中的决策和限制,而非为了复杂而复杂。多个独立来源的分析也指出,招聘经理更看重展示工程思维过程的作品集,而非表面光鲜的演示。
相关推荐
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。