5亿token实测:DeepSeek-V4.1动画能力叫板GPT-6

DeepSeek-V4.1-flash实测编程超闭源旗舰,5亿token仅28元。
DeepSeek 悄然更新 v4.1 版本(flash-1017),B站 UP 主“花叔”投入 5 亿 token 进行多任务实测。结果显示,该模型在真实世界编程能力指标上超过 Claude Opus 5、GPT 5.6 Sol 等闭源模型,并在性能与费用上实现帕累托最优。在 Skill 加持下,模型可完成 30 秒动画、3D 游戏场景与知识解说视频,单个任务成本仅 2.4 至 3 元,但审美精细度与长程编程仍落后于顶级闭源模型。5 亿 token 总花费仅 28 元,主要归功于输入激活 8B、输出激活 16B 的非对称参数设计,以及低至 0.02 元/百万 token 的缓存命中价格。官方演示经过 Harness 优化,裸跑效果偏弱,开发者需合理预期。
近期,DeepSeek 悄然更新了 v4.1 版本(flash-1017),并在海内外技术社区引发热议。B站 UP 主“花叔”投入 5 亿 token 进行多任务实测,结论颇具冲击力:在动画生成与特定编程任务上,该模型已具备对标甚至超越 GPT-6、Claude Opus 5 等顶级闭源模型的实力,而成本却低至令人咋舌的 28 元。
性能跃迁:真实编程能力超越头部闭源模型
据 UP 主实测及社区反馈,DeepSeek广告-V4.1-flash 在衡量真实世界编程能力的核心指标上,已经超过了 Claude Opus 5、GPT 5.6 Sol 以及一众国产开源模型。在多个 Harness 评估环境下,该模型实现了性能与费用的“帕累托最优”——即相比其他所有模型,它都做到了更便宜且性能更强。
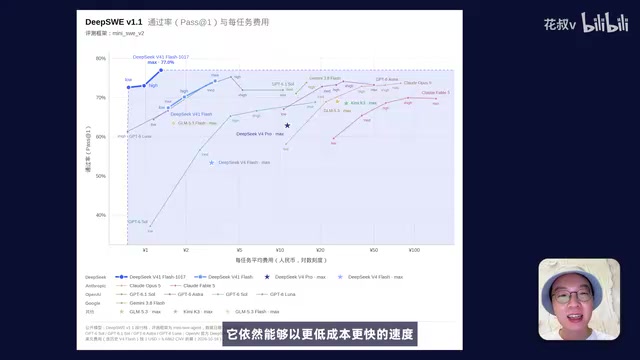
这种提升并非单纯堆砌算力。模型在缩短任务运行时间和输出长度的同时,依然保持了更低的成本与更快的速度。UP 主在视频中将其形容为“大模型的斩杀线”,意指其在性价比维度上对竞品形成了降维打击。不过他也客观指出,在更偏审美级的能力以及长程编程任务上,DeepSeek-V4.1 相比 GPT-6、Astral 以及 Opus 5.5 仍存在一定差距。
Harness 是模型评测中的“承托框架”,指围绕被测模型搭建的提示词、工具调用、代码执行环境、评分脚本等一整套脚手架。同一模型在不同 Harness 下表现可能相差很大,因为工具定义方式、上下文组织、重试策略都会影响最终得分。文中所说的“多个 Harness 评估环境”,意味着评测并非只看单一榜单,而是在多种脚手架配置下交叉验证,结论相对更稳健。这也解释了为何官方演示与开发者裸跑会有落差:演示效果部分来自 Harness 层的专门调优。
帕累托最优 是经济学与多目标优化中的概念:当不存在另一种方案能在不让任何一项指标变差的前提下改善至少一项指标时,当前方案即处于帕累托前沿。放到模型选型中,就是“没有别的模型能同时做到更便宜且更强”。文中用它来描述 DeepSeek-V4.1-flash 在性能—成本二维空间中的位置,强调的是相对竞争优势,而非绝对性能第一。
动画与3D生成实测:Skill加持下效果惊艳
本次测试的核心场景之一是动画与 3D 内容生成。UP 主使用 Claude Code 接入 DeepSeek API,完成了包括 PPT 生成、30 秒动画短片、3D 游戏场景、知识解说视频以及《千里江山图》动画在内的十余个任务。
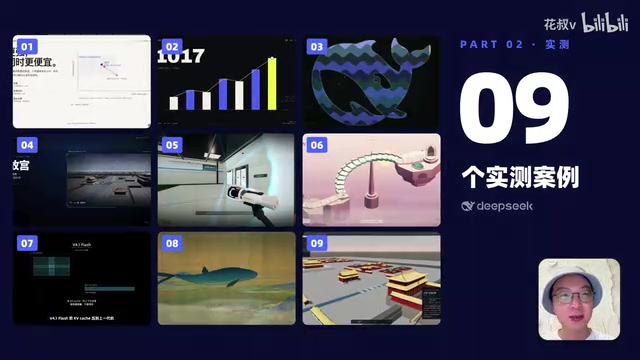
在带 Skill(如花书 Design Skill)的条件下,模型能够产出完成度相当高的动效与音效内容。例如,一个 30 秒的动画仅花费 2.4 元,且中间反复沟通极少,绝大多数请求命中缓存。另一个《千里江山图》动画总花费仅 3 元。对比测试中,虽然 Opus 5.5 在视觉审美与动画精细度上仍更胜一筹,但 DeepSeek-V4.1 在良好 Skill 的扶持下,已经能做出“非常不错”的成果。
有意思的是,官方演示案例在 Harness 层面做了专门优化,因此实际无 Skill 裸跑的效果会明显弱于官方展示。UP 主提醒开发者对此需有合理预期。
Skill 在这里指可插拔的能力包或技能模块,通常由提示词模板、示例、工具函数、设计规范等组成,用于把通用模型约束到特定任务的工作流中。它不改变模型权重,而是在推理阶段注入领域知识与操作步骤,相当于给模型配了一套“作业指导书”。文中的“花书 Design Skill”就是针对视觉设计场景定制的技能包。这也解释了为何带 Skill 与裸跑效果差距明显:Skill 补足了模型在审美规范、版式结构、动效节奏上的先验,使输出更稳定、更接近专业交付物。对开发者而言,Skill 体系是低成本弥补模型短板的主要手段。
成本解密:5亿token仅28元,缓存机制成关键
视频结尾揭晓了最令人震惊的数据:5 亿 token 的实测总花费仅为 28 元,对应 2000 多次 API 调用。这一极低成本主要归功于两项设计。
其一是非对称激活参数特性:输入时仅激活 8B 参数,输出时激活 16B 参数,同时在 KV Cache 和内存占用上相比前代明显减少。其二是缓存命中价格的极致下调——命中缓存时的输入价格低至 0.02 元/百万 token,而空闲时段输入价格为 1 元、输出为 4 元,与之前保持一致。
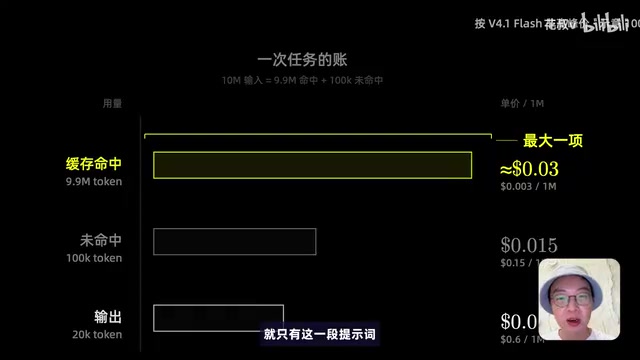
这意味着在长上下文、多轮调用的 Agent 工作流中,绝大部分 token 可以复用缓存,成本被压缩到“未命中价的五十分之一”。对于需要反复读取十万 token 级别的复杂任务,这一机制带来的经济性优势是决定性的。
KV Cache(键值缓存) 是 Transformer 推理中的核心优化:自回归生成时,已处理过的 token 对应的注意力键值向量会被保存复用,避免每生成一个新 token 都重算整段上下文。在长上下文、多轮对话的 Agent 场景中,系统提示词、工具定义、历史对话往往被反复读取,缓存命中率因此很高。厂商通常对“命中缓存的输入 token”单独定价,价格远低于未命中输入。文中 0.02 元/百万 token 的缓存价与 1 元/百万 token 的常规输入价相差约五十倍,正是这一机制带来的经济性来源。
非对称激活参数 指模型在输入(预填充)与输出(解码)阶段激活不同规模的参数子集。输入阶段需要并行处理整段上下文,激活参数较少可降低算力与显存压力;输出阶段逐 token 生成,激活更多参数以保障生成质量。文中“输入 8B、输出 16B”即属此类设计,配合更小的 KV Cache 占用,使长上下文任务的单位成本进一步下降。
生态适配与使用建议
DeepSeek 已重点适配并接入了 CodeBuddy、WorkBuddy广告 等平台,用户可通过 API、官网或第三方编程工具调用。API 接入时默认自带搜索能力,接入 Claude Code 或 Codex 时可免费使用,后续按 5 元/千次计费,成本依然很低。模型权重也已在开源平台提供下载,延续了 DeepSeek 一贯的开源策略。
对于想要复现 UP 主效果的开发者,建议充分利用 Skill 体系来弥补模型在审美与精细化控制上的短板。在 Claude Code + DeepSeek 的组合下,配合合适的 Skill,V4.1-flash 目前可能是除 Claude Code 与 Codex 原生模型外,价格最低且效果最好的选择之一。
Claude Code / Codex 是面向终端的 Agent 式编程工具,它们本身不绑定单一模型,而是通过 API 接入不同后端。把 DeepSeek 这类低成本模型接入后,工具层负责文件读写、命令执行、任务拆解,模型层负责推理与生成,二者组合能显著压低 Agent 工作流的调用成本。需要注意的是,这类工具的效果高度依赖后端模型的指令遵循与工具调用稳定性,接入前建议先用小规模任务验证兼容性,再逐步扩展到长程编程场景。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。