64G内存笔记本跑大模型,实际可用仅46.7G

华硕ProArt创16标称64G内存跑模型实仅46.7G,9000元差价买的是模型规模上限。
B站UP主「AIPC预森」实测华硕ProArt创16发现,标称64G内存的笔记本跑本地大模型时实际可用仅46.7G,约七成三,差额被Windows系统、后台程序和显卡预留切走。64G与128G版本差价9000元,对应官方模型参数上限从实测270亿提升至1200亿,但只有明确需要千亿级模型时这笔溢价才值得。拔电跑270亿参数模型放电功率约86瓦,续航仅一小时出头,定位是移动工作站而非全天候便携设备。UP主给出三步自查法:任务管理器看可用内存、核对模型文件大小、装不下就换小模型或上云,并强调标称参数是营销语言,可用内存才是工程现实。
买笔记本跑本地大模型,包装上的内存数字往往不是你能用的全部。B站UP主「AIPC预森」对华硕ProArt创16的实测给出了一个反直觉的结论:标称64G内存的新机,真正能分给模型的只有46.7G。少的17G去了哪里?这笔账值得每个打算入手AI PC的人算清楚。
标称内存不等于模型可用内存
一台刚开售的华硕ProArt创16,64G内存版本定价28999元,128G版本37999元,两者差价9000元恰好对应多出的64G,折合每G约141元。媒体实测显示,64G版本在跑模型时可用内存为46.7G,约为标称值的七成三。
这不是内存坏了,也不是被隐藏占用,而是Windows系统、后台程序、显卡预留等从统一内存池中先切走了一部分。统一内存的好处是CPU和GPU共用一整块,模型和系统不用来回搬运数据;代价是总量固定,系统先注多少,模型才能用剩下的。UP主特别强调,这个比例不是通用公式,每台机器切多少取决于系统、驱动和使用方式,不存在「打七折」的万能口诀,自己那台打开任务管理器就能看到真实可用数。
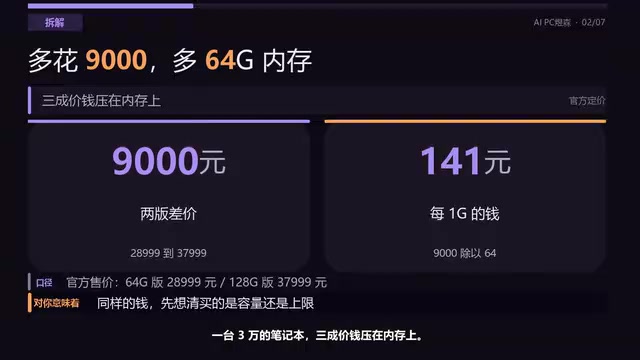
统一内存架构(Unified Memory Architecture,UMA)是理解这台机器内存分配逻辑的前提。传统笔记本中,CPU使用系统内存(DDR),独立显卡使用自己的显存(GDDR/HBM),两者物理隔离,模型跑在GPU上就必须把权重完整拷贝进显存,显存不够直接报错。而统一内存让CPU和GPU共享同一块高带宽内存池,GPU可以直接寻址系统内存,省去了数据搬运开销,也允许模型占用远超传统显存的容量。苹果M系列芯片、AMD的APU以及部分高通PC芯片都采用这一设计。代价是内存总量固定且被所有子系统瓜分:操作系统内核、驱动、集成显卡的显存预留(framebuffer)、后台服务都从同一池子中先划走一块,留给模型的只是剩余部分。因此标称容量与模型可用容量之间的差额,本质上是统一内存架构的固有开销,而非厂商缩水。
9000元差价买的是模型规模上限
媒体在64G版本上实测跑通了千问3.8的270亿参数模型,而官方给128G版本标注的上限是1200亿参数,后者是前者的四倍多。UP主把口径说得很清楚:270亿是实测跑通的结果,1200亿是官方标称上限,两者不能混为一谈。
这意味着9000元买的不是「更多G」,而是能否触到1200亿参数这道门。如果日常只折腾300亿以内的模型,64G版本完全够用;只有明确需要1000亿以上规模,这笔溢价才有意义。
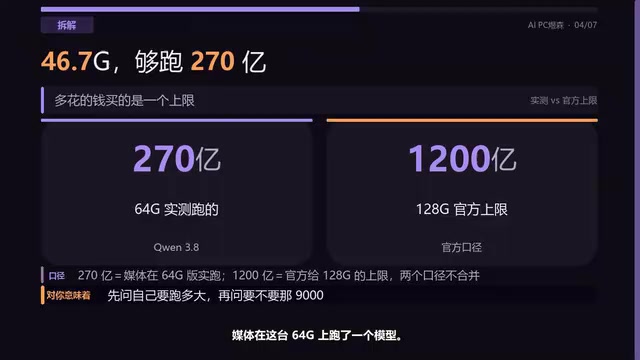
文中反复出现的“270亿参数”“1200亿参数”,指的是大语言模型的参数量(parameters),即模型神经网络中可学习权重的数量,通常以B(billion,十亿)为单位。参数量决定模型的能力上限,也直接决定加载所需的内存:在常见的FP16(半精度)格式下,每个参数占2字节,270亿参数约需54GB,1200亿参数约需240GB;若采用INT4量化(每参数约0.5字节),同样模型的占用可压缩至四分之一左右。这就是为什么同一台64G机器能跑270亿模型,却远够不到1200亿——后者即使重度量化也超出可用内存。需要区分的是,参数规模不等于实际能力,小模型在特定任务上可能优于大模型,选型应以任务需求而非参数数字为准。
移动工作站的续航真相
这台机器的电池为99.9瓦时,接近民航可携带上限。拔掉电源跑270亿参数模型时,放电功率约86瓦,99.9除以86,续航仅一小时出头。UP主的判断很直接:它是一台能移动的工作站,不是能带着跑一天的机器。账面数字好看的前提是插座一直插着,离开电源,算力和时间同时打折。相比之下,没有电池的迷你主机插电即满血,表现始终一致。
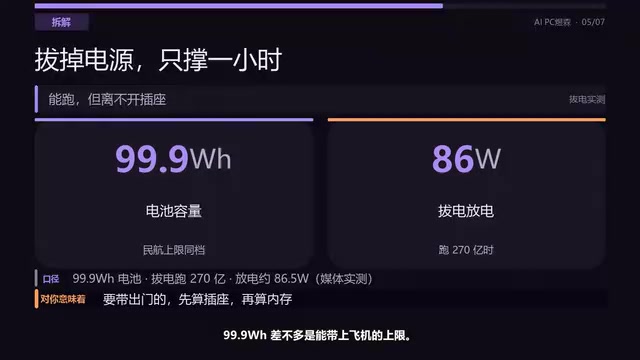
瓦时(Wh) 是电池能量的单位,数值越大代表电池储存的电能越多。民航规定随身携带的锂电池不得超过100Wh(需航空公司批准可放宽至160Wh),这台机器99.9Wh正是贴着这一上限设计的,目的是在合规前提下塞进最大的电池。但电池容量只决定“能存多少电”,实际续航还取决于放电功率:跑大模型时CPU/GPU满载,功耗远高于浏览网页等轻负载场景。文中86瓦的放电功率意味着电池以接近满负荷的速度输出,99.9Wh÷86W≈1.16小时,这是物理定律决定的硬上限,与厂商优化无关。对比之下,迷你主机没有电池限制,插电即可持续输出满血算力,这也解释了为何同配置下台式形态在持续推理场景中体验更稳定。
三步查清自己机器的真实上限
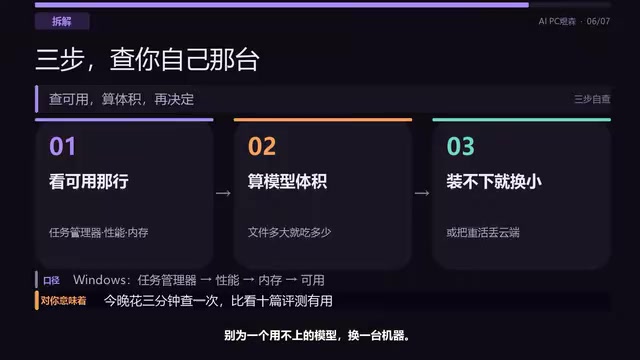
UP主给出了一套可操作的自查方法:第一步,打开任务管理器性能页,点内存,看「可用」那一行,这才是能给模型的真实数字,而非包装上印的标称值;第二步,核对模型文件大小,文件多大装进去就占多大,还要额外留出上下文所需空间;第三步,装不下就换小模型,或把重活交给云端,本地只保留私密任务,别为一个用不上的模型换整台机器。
谁该买,谁不必看
UP主的结论分三种情况:跑300亿参数以内,64G版本够用;需要1000亿以上,才值得为128G多付9000元;而最常见的是第三种——压根不需要这么大的模型,那这台机器连看都不用看。先查清自己设备的可用内存,再谈买什么,顺序不能反。这套逻辑对任何打算用笔记本跑本地大模型的用户都成立:标称参数是营销语言,可用内存才是工程现实。
相关推荐
用Claude+MCP打造Jarvis:零硬件改造接入智能家居
一位创作者用Claude Code生成MCP Server,通过涂鸦Smart Life平台API直连智能灯泡,绕开Alexa和Google Home,实现语音控制灯的Jarvis式体验。本文拆解四步搭建流程、技术原理与方案局限。

REA:用AI Agent逆向工程任何软件
REA(Reverse Engineer Anything)是一款专为AI编程代理设计的MCP服务器和技能包,支持Cloud Code、Cursor等工具,可逆向分析JavaScript、Electron、二进制、Android应用和固件。本文详解其工作流程、支持平台、本地分析优势与能力边界,并提醒合法使用。
AI代理五个权限等级:从ChatGPT问答到全自动Agent
把AI代理权限拆成五个等级:从ChatGPT纯对话、项目文档、MCP连接器、Computer Use自动点击到无人值守代理,逐级分析能力边界、提示注入风险与审批疲劳,并给出默认只读、不可逆操作人工确认、按项目隔离三条实操规则。