65个AI观众围攻Claude玩家:一场AI主播实验

65个AI观众围观AI玩家打游戏,暴露多智能体系统的真实水位。
一位开发者让Claude Opus扮演玩家,65个Sonnet驱动的AI观众在Twitch聊天室围观吐槽。实验采用三层结构:三个Sonnet智能体分别管理黑子、乐子人和混沌乐子人阵营,每个观众有独立人格和记忆文件,每轮从备选台词中挑一句发出。AI观众自发形成了"who asked"等内部梗,说明人格涌现依赖记忆累积和群体互动而非单次提示。最值得警惕的是Moderator角色:1060条聊天中只拦截3条,还漏掉了假链接和真实人名。实验表明,多智能体的表演效果已足以以假乱真,但审核兜底和系统可靠性仍需人工介入,演出效果与可靠性必须分开评估。
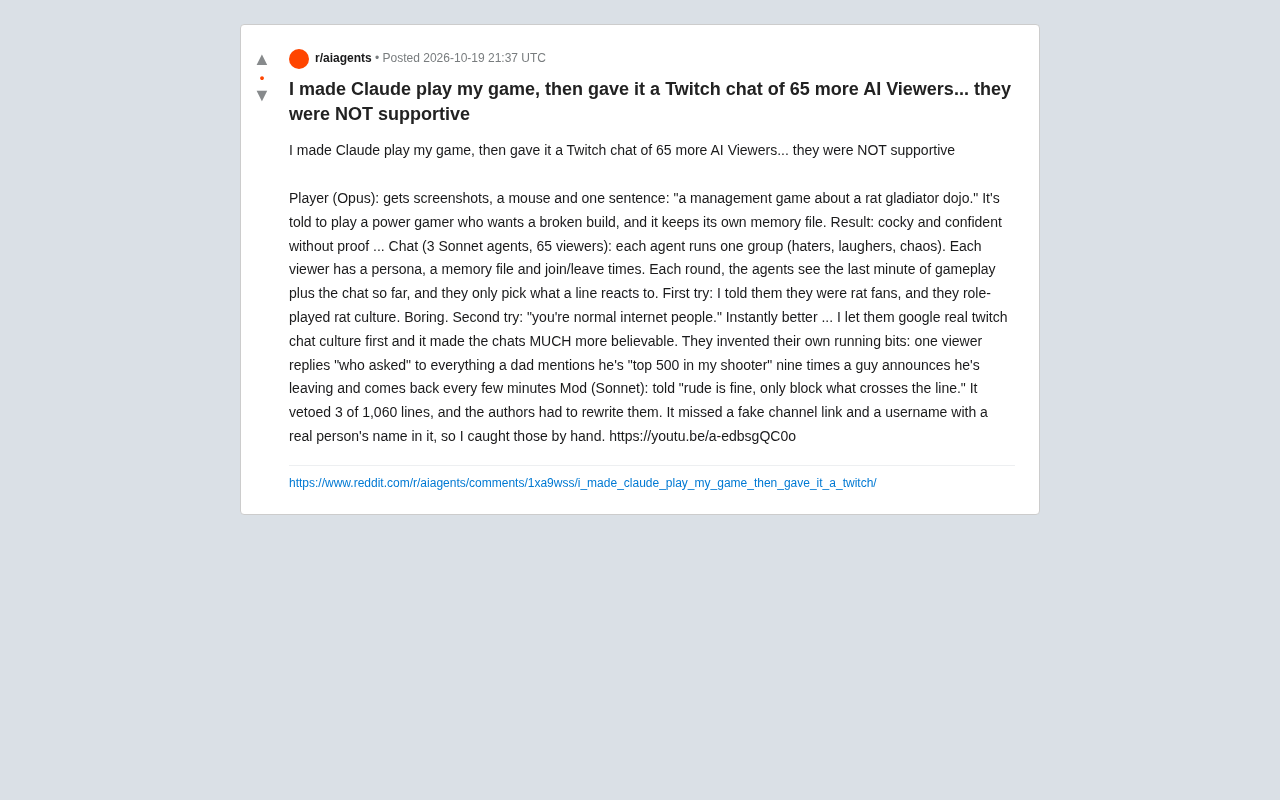
一位开发者把Claude Opus变成玩家,又把65个由Sonnet驱动的AI观众塞进Twitch聊天室,让它们围观并吐槽这位AI玩家的游戏过程。这场实验的结果,比任何单一AI的评测都更能说明当前多智能体系统的真实水位——它们能演得像模像样,但离"可信"还差着几个量级的工程细节。
实验架构:一个玩家,三个聊天军团,六十五张面孔
玩家端只有Claude Opus,输入极简:游戏截图、一个鼠标操作接口,以及一句话的设定——"一个关于老鼠角斗士道馆的经营游戏"。它被要求扮演追求"破坏性build"的硬核玩家,并维护自己的记忆文件。表现如何?原文给的评价很直白:"cocky and confident without proof"——自信满满,毫无根据。
聊天端则是三层结构。三个Sonnet智能体分别统领三个阵营:黑子、乐子人、混沌乐子人。每个观众拥有独立人格、记忆文件和进出场时间。每一轮,三个智能体只能看到最近一分钟的游戏画面和已有聊天记录,然后从备选台词中挑选一句发出。这种"只选不写"的设计压缩了生成自由度,也让聊天节奏更接近真实直播。
你可能没注意到,第一版设定是"你们是老鼠粉丝",结果AI们一本正经地角色扮演老鼠文化,效果无聊透顶。改成"你们就是普通网民"之后,质量立刻起飞。开发者还让它们先搜索真实的Twitch聊天文化,聊天可信度大幅提升。
为什么用"只选不写"的台词选择机制
让LLM直接自由生成聊天台词,会带来两个问题:一是生成延迟高,65个观众每轮都写一句话,成本和时间都难以承受;二是风格容易飘,模型倾向于写出完整、礼貌、信息量过高的句子,不像真实弹幕。开发者改为让每个观众从预置的备选台词池中"挑一句",本质上是把生成任务降级为分类/排序任务。这样做的好处是:单次调用只需输出一个选择,延迟和token消耗大幅下降;同时备选台词由人工或更强模型预先打磨,保证了聊天风格的下限。代价是多样性受限于台词池规模,观众的"即兴发挥"空间被压缩,涌现行为更多体现在"何时选哪句"而非"说什么"。这也解释了为什么内部梗能形成——同一句台词被反复选中,本身就是一种强化机制。
AI观众自己长出了"梗"
真正有意思的部分,是这些AI观众自发形成了内部梗。有个观众对任何提到"我射击游戏排名前500"的爸爸发言都回一句"who asked"(谁问你了),这句话被用了九次。另一个观众每隔几分钟就宣布"我走了",然后马上回来。这些行为没有在提示词里写死,是多个智能体在记忆文件和上下文交互中涌现出来的。
这指向一个被低估的事实:多智能体系统的"人格"不是靠单次提示塑造的,而是靠记忆累积和群体互动长出来的。单个AI很难维持长期一致性,但当每个观众都有记忆文件、又互相看得到聊天记录时,重复行为会自我强化,形成类似真实社区的风格。
不过原文没有给出这些涌现梗的稳定性数据——它们在不同会话中能否复现,目前仍是未知数。
审核AI的局限:1060条里只拦了3条
整个实验最值得警惕的发现来自Moderator角色。开发者给它的指令是"粗鲁可以,只拦截越线内容"。在1060条聊天中,它只否决了3条,原作者被迫重写。但更关键的是漏网之鱼:一个假的频道链接,以及一个包含真实人名的用户名,Moderator都没拦住,最后靠人工发现。
这个结果和业界对LLM内容审核的普遍认知一致——模型对显性脏话敏感,对伪装链接、人肉信息这类需要外部知识比对的违规类型则力不从心。开发者自己的结论也承认,人工兜底不可省略。
从工程角度看,这场实验的价值不在于证明AI能当主播或观众,而在于它把多智能体协作里最容易被忽略的环节——记忆管理、群体人格涌现、审核兜底——全部暴露在了一个可控的沙盒里。65个AI观众的表演已经足够以假乱真,但Moderator漏掉的那两条,提醒着所有人:演出效果和系统可靠性,是两件需要分开评估的事。
完整实验视频见原文链接。
LLM内容审核的能力边界
用LLM做内容审核,本质上是把它当成一个零样本分类器:给定规则描述和待审文本,判断是否违规。这类方法在语义层面的违规(仇恨言论、骚扰、显性脏话)上表现尚可,因为预训练语料让模型对这些模式敏感。但审核任务中真正危险的是"需要外部事实核查"的类别:伪装成正常文本的钓鱼链接、拼接变形的人名和联系方式、以及依赖平台黑名单才能识别的已知违规账号。这些内容在语义上完全无害,模型没有理由拦截,除非接入URL信誉库、PII检测器或规则引擎做二次校验。业界常见的做法是"LLM初审+规则/黑名单硬拦截+人工抽检"三层流水线,单靠一个Moderator角色本质上只是第一层。1060条只拦3条,既可能是规则过松,也可能是模型把"粗鲁可以"过度泛化为"几乎都放行"。
多智能体系统中的记忆文件
每个AI观众维护独立记忆文件,是这场实验能产生长期一致行为的关键设计。LLM本身是无状态的,上下文窗口有限,若每次都把全部历史塞进提示,成本和噪声都会失控。记忆文件的常见做法是把历史交互压缩成结构化条目(如"该用户曾说过X""该用户讨厌Y"),在每轮生成前检索相关片段注入提示。这让智能体能够在数十轮之后仍记得"我上次说过我走了",从而复现同一行为。但记忆也带来风险:错误记忆会被反复强化,形成难以纠正的偏见;多智能体共享的聊天记录还会造成"回声室",让某个梗在群体中自我放大。原文提到的内部梗涌现,正是记忆累积与群体可见性共同作用的结果,但目前缺乏跨会话复现的稳定性数据。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。