66道题胜过一篇Nature?TerminalBench成前沿实验室新标尺
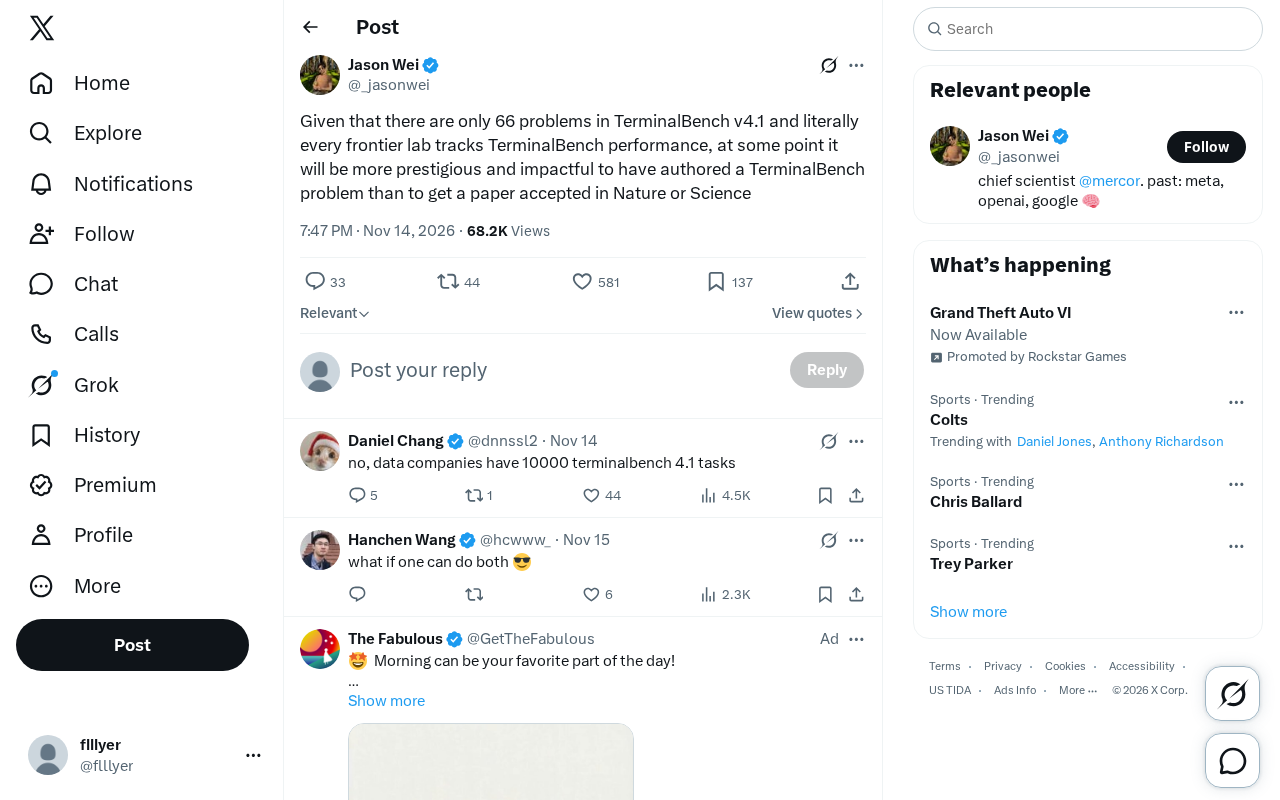
TerminalBench仅66题却被所有前沿实验室追踪,出题影响力或超顶刊论文。
文章从一条社交平台观察切入:TerminalBench v4.1 仅有 66 道题,却几乎被所有前沿实验室追踪,发布者据此认为设计一道基准题的影响力可能超过在 Nature 或 Science 发表论文。文章分析其底层逻辑是稀缺性决定价值——题目越少,单题信号权重越大,出题者获得隐性的议程设置权。TerminalBench 评测智能体在真实终端环境中的多步任务执行能力,贴近 AI 编程落地场景,因此在传统基准饱和后成为区分度更高的战场。文章同时指出小样本基准的隐忧:统计噪声大、易被训练数据污染,影响力与脆弱性并存,参与基准建设正成为可见度极高的贡献方式。
当基准测试题成为稀缺资源
一条来自社交平台的观察引发了AI研究圈的讨论:TerminalBench v4.1 目前仅有 66 道题目,而几乎所有前沿实验室都在追踪这一基准的表现。发布者由此抛出一个略带挑衅的论断——在某个节点上,主导设计一道 TerminalBench 题目所带来的声望与影响力,可能会超过在 Nature 或 Science 上发表一篇论文。
这个判断的底层逻辑并不复杂:稀缺性决定价值。66 道题是一个极小的集合,意味着每一道题都承载着巨大的信号权重。当全球顶尖实验室的模型迭代都绕不开这几十道题时,出题者实际上掌握了一种隐性的议程设置权。
TerminalBench 为何被前沿实验室紧盯
TerminalBench 的定位是评估智能体在真实终端环境中的任务执行能力。与静态问答类基准不同,它要求模型在命令行环境中完成多步骤操作,涉及文件系统、脚本编写、错误排查等复合技能。这类能力直接对应 AI 编程与自动化落地的核心场景,因此实验室有强烈动机追踪其分数变化。
据发布者在原帖中的表述,"literally every frontier lab"都在关注这一基准。这一说法虽属定性判断,但反映了行业现状:当模型能力在传统评测上趋于饱和,贴近真实工作流的终端任务基准就成了区分度更高的战场。66 道题的规模使得榜单波动更敏感,单题表现变化都可能影响整体排名,这进一步放大了出题行为的影响力。
基准测试(Benchmark) 是 AI 领域用于量化评估模型能力的标准化任务集合,通常包含固定题目、评分脚本和统一运行环境。其作用类似于学术界的“可复现实验”:不同实验室在相同条件下跑分,结果可直接横向比较。基准的“区分度”指其能否把不同能力水平的模型拉开差距——当模型在旧基准上普遍接近满分(即“饱和”)时,该基准便失去鉴别力,社区会转向更难、更贴近真实场景的新基准。TerminalBench 属于“智能体基准”子类,与 MMLU、GSM8K 等静态问答基准不同,它评测的是模型调用工具、操作环境、多步规划的综合能力,因而更接近产品落地时的真实表现。
出题影响力与论文发表的价值错位
将"出一道基准题"与"发一篇 Nature/Science"放在同一坐标系比较,触及的是学术评价体系与工程实践评价体系之间的张力。顶刊论文代表的是经过同行评审的理论贡献,其声望建立在长期的学术共同体共识之上;而基准题目影响的是一线研发的即时方向,反馈周期短、传播路径直接。
这种比较未必严谨,却点出了一个真实趋势:在 AI 领域,评测基础设施的构建者正在获得超出传统学术渠道的话语权。一道设计精巧、区分度高的题目,会被反复引用、反复测试,其"被使用"的频率可能远超一篇高影响因子论文的"被引用"频率。
Nature 与 Science 是综合性顶级学术期刊,其论文录用依赖严格的同行评审,评审周期常达数月甚至一年,强调理论新颖性与广泛科学意义。而 AI 基准题目 的“发表”门槛极低——通常以开源仓库或数据集形式发布,无需同行评审,但会被全球实验室在数周内实际使用。两种渠道的声望机制不同:顶刊声望来自学术共同体的长期共识与引用积累,基准声望来自“被使用”的即时频率与榜单曝光。这也解释了为何在快速迭代的 AI 领域,评测基础设施构建者能在短时间内获得远超传统学术路径的可见度——其贡献直接嵌入他人研发流程,而非停留在文献层面。
小样本基准的隐忧
66 道题的规模也带来明显风险。样本量小意味着统计噪声大,模型在个别题目上的偶然表现可能显著扭曲总分;同时,基准题目一旦公开,存在被训练数据污染的可能,出题者需要持续维护题目的有效性。发布者的观点更多是一种对影响力的感叹,而非对基准质量的背书。
从行业实践看,小规模高质量基准与大规模多样化基准各有用途。TerminalBench 的价值在于锚定终端智能体的能力边界,而它的稀缺性恰恰是影响力来源,也是需要警惕的脆弱点。对研究者而言,参与这类基准的建设,确实正在成为一种可见度极高的贡献方式。
数据污染(Data Contamination) 指基准题目或其近似变体被意外或故意纳入模型训练数据,导致模型“背题”而非真正推理,从而使分数虚高、基准失效。小样本基准尤其脆弱:66 道题一旦公开,很容易被爬取进预训练语料。业界常见的缓解手段包括:定期轮换题目、保留私有测试集、对题目做动态参数化改写,以及用“训练数据截止时间”过滤。统计噪声 则指小样本下置信区间宽,单题得失可能让总分波动数个百分点,因此严谨的基准报告应给出多次运行的方差或置信区间,而非仅报单次均值。
常见问题
TerminalBench 是什么? 一个评估 AI 智能体在终端环境中执行任务能力的基准测试,当前版本 v4.1 包含 66 道题目。
为什么题目数量少反而影响力大? 因为前沿实验室普遍追踪该基准,题目稀缺使得每道题都承载较高信号权重,出题者因此获得议程设置层面的影响力。
相关推荐

胰腺癌口服药被誉数十年来最大突破
胰腺癌口服药被评价为数十年来最大突破,引发Hacker News热议。本文从剂型优势、临床验证阶段和技术社区审慎态度三个角度,分析这一突破的真实含金量与距离临床可及的距离。
DevWorkflow 5.0:用AI五步法从想法到上线
DevWorkflow 5.0 是 Claude Code 插件,用五步流程让 AI 辅助开发从想法到上线。每个决定先问你,避免 AI 擅自加表加字段、文档代码不一致、测试未写就合并。支持多平台多语言,个人开发者和小团队适用。
Hermes Agent的.md文件如何工作?核心机制解析
解析 Hermes Agent 的 .hermes 目录机制:user.md 存个人信息、memory.md 记录值得记住的细节、soul.md 定义 Agent 性格。了解这套纯 Markdown 文件如何让 Agent 跨会话保持一致行为。