7000美元本地AI全套配置揭秘:硬件、模型与提速技巧
7000美元本地AI盒子完整方案:大内存硬件+对的推理引擎+三层软件优化,让千亿参数模型跑出云端速度。
一位博主分享了耗资约7000美元搭建本地AI的完整方案,核心硬件是搭载Grace Blackwell架构、128GB统一内存的专用盒子,以"大内存换可行性"替代RTX 4090的"高速度但显存瓶颈"路线。推理引擎层面,以llama.cpp+llama-swap为主力、Ollama负责快速调用、vLLM服务超大模型,并通过YAML配置实现多模型动态调度。软件优化是最大亮点:Q6量化将1200亿参数模型压缩到64GB、推测解码(MTP)让吞吐量接近翻倍、量化KV缓存+Flash Attention进一步节省内存并扩大上下文窗口,三者叠加令Nemotron Super从16.6 Token/s提升至27.2 Token/s,提速约64%。专家混合(MoE)架构则是模型选型的核心逻辑:大参数保智能,小激活参数保速度。网络层通过Tailscale构建私有VPN,客户端覆盖VSCode、命令行和Discord后台Agent,实现"像调用云服务一样用自己的盒子"。
本地AI的能力常被低估,很多人尝试后觉得速度慢、体验差,往往不是硬件不行,而是配置方式出了问题。一位B站UP主分享了自己耗资约7000美元搭建的完整本地AI方案,从硬件选型到推理引擎,再到软件层面的一系列提速优化,几乎覆盖了自托管本地大模型的全部关键环节。本文对其配置思路做系统梳理,供想搭建本地AI的读者参考。
核心硬件:为什么选择大内存而非纯算力
整套方案的核心是一台配备NVIDIA GB系列(Grace Blackwell架构)超级芯片的设备,UP主称之为"Dell Pro Max"。它的关键规格不在于极致的推理速度,而在于128GB统一内存、20核ARM CPU以及4TB存储——大内存意味着可以加载超大模型,大存储则能容纳动辄几百GB的模型文件。整机体积小、极其安静,可以直接放在桌面上,价格约7000美元。
为了说明选型逻辑,UP主拿手里的RTX 4090做了对比。消费级旗舰显卡(4090/5090)推理速度确实更快,但只有24GB显存,成了硬性瓶颈:真正强大的模型根本装不进显存,更别提同时运行多个模型。而且一旦显卡被AI占满,显示器会卡顿、无法录屏、无法游戏。相比之下,一台独立、无头(headless)运行的AI盒子可以通过SSH随时连接,即使人不在家也能像用云服务一样调用——只不过它完全是自托管的。
他也点评了Mac的路线:现代Mac统一内存更大,能跑更大的模型,但速度更慢、可靠性也不如这类专用盒子。结论是——大内存换来的是"可行性",代价是内存带宽略低于顶级显卡。
实际运行的模型清单
UP主分享了经过实测、表现最好的一批模型,均以本地形式运行:
- Qwen3系列(约350亿参数,30亿激活参数):速度极快,是他最常用的编程模型。
- NVIDIA Nemotron 3.5 Lightning(300亿参数):作为通用型全能Agent表现出色,用来驱动他的Hermes Agent。
- GPT-OSS:中等体量,速度不错。
- Nemotron Super(约1200亿参数级):体量大、速度较慢,但在高级规划和推理任务上更强,需要时才切换。
- Qwen大模型(约1200亿参数):用于超复杂编码和深度工作,速度视配置和并发而定。
专家混合(MoE)是速度的关键
列表中不少模型标注了"A3B"这类后缀,意味着虽然总参数量很大,但每个Token只激活约30亿参数。这正是专家混合(MoE)架构的价值所在:既保留了大模型的智能,又获得了小模型级别的推理速度,实现"鱼和熊掌兼得"。UP主强调,这是很多人谈本地AI时容易忽略的一点。
专家混合(Mixture of Experts,MoE)架构的基本原理是:模型由多个"专家"子网络组成,每次推理时由一个轻量级的"路由器"(Router)动态选择其中少数几个专家参与计算,而非激活全部参数。以Qwen3 235B A22B为例,总参数量2350亿,但每个Token只激活约220亿参数,推理计算量与同等激活参数量的稠密模型(Dense Model)相近,内存占用却远低于同等"智能水平"的稠密模型。这种设计的代价是需要将所有专家的权重同时保留在内存中(因为不同Token可能路由到不同专家),所以MoE模型对内存容量要求更高,但对内存带宽和算力的要求相对宽松——这正好契合大内存、中等算力的本地AI硬件定位。理解这一点,就能明白为什么128GB统一内存配合MoE模型是性价比极高的组合。
推理引擎:模型只是文件,服务方式决定速度
一个常被忽视的事实是——模型本身只是硬盘上的一个文件,真正决定每秒Token数的是推理引擎。用对引擎,吞吐量可以翻倍甚至三倍,尤其在并行处理时差异明显。UP主的组合是:
- llama.cpp + llama-swap:主力方案,界面直观,可查看完整日志、TPS和硬件状态,实测能达到每秒75–80个Token,比Ollama更快更好用。
- Ollama:用于需要快速调用模型的场景,比如从代码或Hermes Daily访问,内置连接器很方便。
- vLLM:数据中心级推理引擎,专门用于超大模型,支持并行请求和批处理。
llama-swap的内存调度逻辑
llama-swap的机制与Ollama类似:收到请求时若模型未加载到显存/统一内存,就临时加载(约10–60秒,取决于模型大小);若模型闲置超过一小时则自动卸载。这样一来,多个小模型可以共享内存空间,随时切换;而运行1200亿参数级的大模型时,则通过一个YAML配置文件把它设为"独占",加载时自动踢掉其他模型,避免内存耗尽——这个配置文件他直接让Claude Code帮忙生成。
几个主流推理引擎的定位差异值得区分:llama.cpp是用纯C/C++实现的跨平台推理框架,支持CPU与各类加速器,对GGUF格式模型有极好的优化,适合消费级和边缘设备;llama-swap是架设在其上的轻量级HTTP代理,负责多模型的动态加载与卸载调度,解决了单机内存无法同时驻留多个大模型的问题。Ollama则是面向易用性设计的一体化工具,内置模型管理、API服务和常见客户端连接器,上手门槛极低,但底层同样调用llama.cpp,在某些高级参数调优上不如直接使用llama.cpp灵活。vLLM则是针对数据中心GPU集群设计的高吞吐推理服务框架,核心优势在于PagedAttention技术对KV缓存的精细管理,以及对并发请求的连续批处理(Continuous Batching),适合需要同时响应多个请求的场景,但部署复杂度较高,在单张消费级GPU上收益有限。
软件层面的提速优化
这套方案最有价值的部分,是纯软件层面的一系列优化,让原本跑不动的1200亿参数大模型达到每秒46个Token。
量化:用精度换空间
量化是模型侧最大的优化手段,本质是用更低精度存储权重。UP主内存余量充足,因此选用Q6量化而非Q4,精度更高;空间紧张的用户则可以退到Q4 GGUF格式。此外,他还把大模型权重压缩成"INT4 + FP8"格式,让1200亿参数模型从约120GB降到64GB,从而能装进128GB内存——否则超过100GB就加载不了。
量化的核心思路是降低存储模型权重所需的数值精度。原始模型通常以FP16(16位浮点)或BF16格式训练,每个参数占2字节;Q8量化将其压缩至1字节,Q6约0.75字节,Q4仅0.5字节,模型文件体积和内存占用随之线性下降。GGUF格式是llama.cpp生态的标准模型格式,统一了不同量化级别的打包方式,方便在推理引擎中直接加载。精度损失方面,Q6与Q4相比对模型能力影响较小,Q4以下则可能出现明显的输出质量退化,因此内存充裕时优先选择Q6。文中提到的"INT4 + FP8"混合格式是另一种策略:对模型中对精度更敏感的层(如注意力层)保留FP8,其余权重压缩为INT4,在压缩率与质量之间取得更精细的平衡,这也是部分模型厂商发布的官方量化版本所采用的方案。
三个"免费"提速技巧
- 推测解码(Speculative Decoding):使用模型的MTP版本,通过一个小型草稿模型每轮预猜约7个Token,大模型只需校验,正确就采用、错误才重算。这一招让每秒Token数几乎翻倍,设置也简单。
- 量化KV缓存 + Flash Attention:KV缓存会随上下文增长占用大量空间,甚至超过模型本身。以8位精度存储KV缓存后,既省内存又能支撑更大的上下文窗口。
- 手动调高上下文窗口:Ollama默认会限制输入Token,需要手动修改。UP主日常使用13万到26万的上下文长度。
实测效果很直观:运行Nemotron Super(约1200亿参数)时,未优化约每秒16.6个Token,启用MTP、Flash Attention和KV缓存后提升到27.2个Token(17000上下文长度下),提速约64%。
推测解码(Speculative Decoding)的工作机制值得进一步说明。大语言模型的推理是自回归的——每次只能生成一个Token,新Token依赖上一个Token才能继续,导致GPU/NPU的并行计算能力大量闲置。推测解码通过引入一个参数量极小的"草稿模型"(Draft Model)来打破这一瓶颈:草稿模型极快地连续预测若干个Token(通常4–8个),再由主模型一次性并行验证这批Token是否符合自身分布——验证过程的计算代价远低于逐个生成。如果草稿正确,直接采用;错误则从出错位置重新生成。由于草稿模型与主模型通常来自同一家族(即文中提到的"MTP版本",Multi-Token Prediction),命中率较高,实践中可显著提升有效吞吐量,而输出质量与单独运行主模型完全一致。这是一种"零质量损耗"的提速手段。
各模型实测速度参考
UP主给出了自己测得的部分数据:Qwen3系列约72–87 Token/s;Nemotron Lightning(300亿)约57 Token/s;Qwen3 Coder约67–81 Token/s;GPT-OSS约40 Token/s;Qwen大模型(1200亿级)约46 Token/s。
网络与客户端:像用云一样用自己的盒子
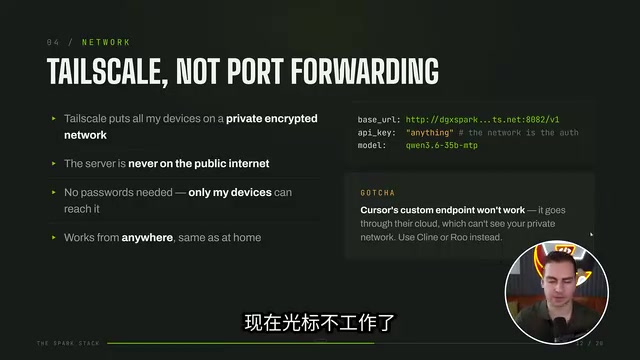
网络层面,UP主使用Tailscale搭建私有VPN隧道,连接盒子与笔记本、手机、PC等各类设备。好处是自动处理SSH密钥和认证,无需手动配置密钥或API Key,直接用Tailscale IP即可连接——不过他也提到使用中存在一些"坑"。
客户端方面相当丰富:桌面用VSCode + Cline扩展(他认为这是使用本地模型最好的扩展之一),命令行用PI,后台则让Hermes Agent常驻在一个Discord服务器里全天候运行。演示中,连接带MTP和推测解码的Qwen3模型后,重构代码库这类请求响应极快,约每秒70–80个Token,比阅读速度还快,甚至快过不少云端模型。得益于两个推理引擎同时工作,他可以一边在编辑器里写代码,一边让Hermes Agent在后台自动跑任务。
本地并非全部:混合使用才是现实
UP主坦言自己并非只用本地模型。对于需要隐私保护、或需要智能体长时间连续编码的场景(用云端会很贵),他倾向本地;而遇到真正困难、上下文极其复杂的编码任务,他会同时试用Claude Code、Cursor、Grok等云端模型,混合使用。不过整体趋势是——随着本地模型越来越强,他正越来越多地转向本地方案。
这套配置的启示在于:本地AI"慢"往往是配置问题而非能力问题。选对大内存硬件、用对推理引擎、叠加量化与推测解码等软件优化,普通桌面设备也能获得接近云端的体验,且数据完全掌握在自己手里。
相关推荐

气态巨行星上的浮空城市:为什么人类终将移居木星云端
SFIA 主持人 Isaac Arthur 重新定义气态巨行星浮空城市:它们不是等待聚变的燃料站,而是散装氢、氦、氮的"质量城市"。本文解析其工程原理、供电方案与从工业前哨到文明家园的演化逻辑。

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。