74B大模型塞进24GB显存:一张4090本地免费跑

740亿参数模型靠稀疏MoE与2比特量化感知训练压进24GB显存并全开源。
文章介绍了一个名为"爱今天开源Demo灯3.5 74B"的项目,尝试解决本地大模型"聪明装不下、装得下不聪明"的矛盾。它通过稀疏混合专家架构(总参74B、每次仅激活约9B)叠加二比特量化感知训练,把权重体积压到24GB以内,恰好适配一张RTX 4090或3090,并同时公开权重、训练数据和训练方案。文章也强调冷静:24GB只是权重下限,上下文与KV缓存仍需额外显存;目前没有第三方独立评测,性能对比均为团队自评;开源的价值在于免费、隐私可控和可微调,而非全面超越闭源前沿模型。适合隐私敏感工作者、智能体实验者、已有24GB显卡者和想学微调的人。
当740亿参数遇上24GB显存
本地跑大模型长期卡在一个尴尬的矛盾里:够聪明的模型动辄需要100GB以上显存,普通电脑根本装不下;装得下的小模型又不够聪明,做不了真正的智能体任务。
据B站科技UP主发布的视频介绍,一个名为"爱今天开源Demo灯3.5 74B"的项目试图打破这个僵局——把740亿参数压进24GB显存,恰好是一张RTX 4090或3090的容量。更关键的是,这次不只放权重,训练数据和训练方案也一起公开。
UP主在视频中也做了冷静提醒:目前还没有第三方独立评测,所谓"比同类模型更聪明"是该团队自评的说法。
74B怎么进24GB?两个技术叠加
核心思路可以概括为一句话:存74B的知识,算9B的算力。
稀疏混合专家架构
740亿参数并非每个token都激活,每次生成只激活约90亿参数。这意味着算力开销向9B模型看齐,而知识容量向74B模型看齐。这种稀疏激活策略是MoE(混合专家)架构的典型玩法,但要做到74B总量、9B激活的比例,需要在专家路由设计上做精细平衡。
MoE(Mixture of Experts,混合专家)的核心在于把一个大模型拆成多个"专家"子网络,每个token经过一个路由网络(router/gating network)后,只被分配给其中少数几个专家计算。这样一来,总参数量可以做得很大(知识容量大),但每个token的实际计算量只与激活的专家数量相关(算力开销小)。
关键难点在路由设计:路由如果过度集中到少数专家,会导致其他专家训练不足(专家塌缩);如果分配过于均匀,又浪费了稀疏化的意义。常见的平衡手段包括负载均衡损失(auxiliary load-balancing loss)和专家容量上限(capacity factor)。74B总量、9B激活的比例,意味着每次大约只激活总量的12%左右,属于比较激进的稀疏度。
二比特量化感知训练
常规做法是训练完再压缩,但2比特的粗暴压缩通常会严重损害推理能力。该项目的做法是在训练过程中就模拟低精度环境,让模型从训练早期就适应2比特工作条件。
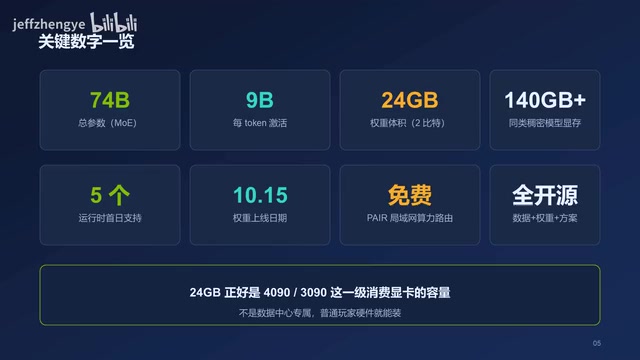
两个技术叠加之后,全重体积控制在24GB以内。作为参照,同类稠密模型通常需要140GB以上显存。
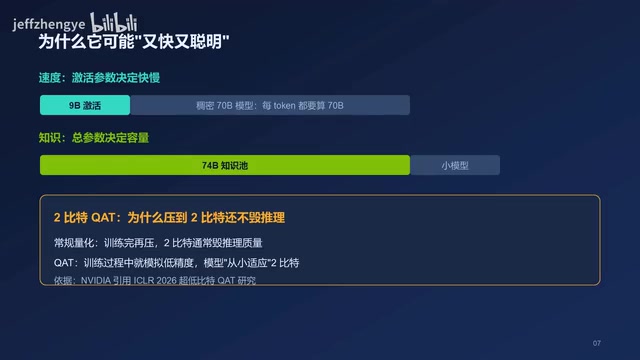
量化是用更低比特数表示权重以节省显存和带宽的技术。2比特意味着每个权重只有4个可能取值,压缩率极高,但代价是精度损失严重,尤其是对推理、长链思考这类任务,粗暴的事后量化(post-training quantization)常常让模型"变傻"。
量化感知训练(Quantization-Aware Training, QAT)的思路是在训练阶段就插入模拟量化的操作(伪量化节点),让前向传播用低精度、反向传播仍用高精度梯度更新,使模型参数主动去适应量化误差。这样训练完成后直接以2比特部署,性能损失远小于事后量化。代价是训练流程更复杂、对超参更敏感。它和MoE叠加时还需注意:专家路由对数值精度尤其敏感,低比特可能放大路由错误,因此二者结合是工程难点。
硬件现实:24GB是下限不是舒适值
这里需要泼一盆冷水。24GB是权重文件的下限,不是舒适运行值。上下文长度、KV缓存、运行时开销都要额外吃显存。
按显卡分级来看:24GB的4090或3090,全重刚好装下,但上下文余量有限;12GB显卡则需要更激进的量化方案或大幅缩短上下文。
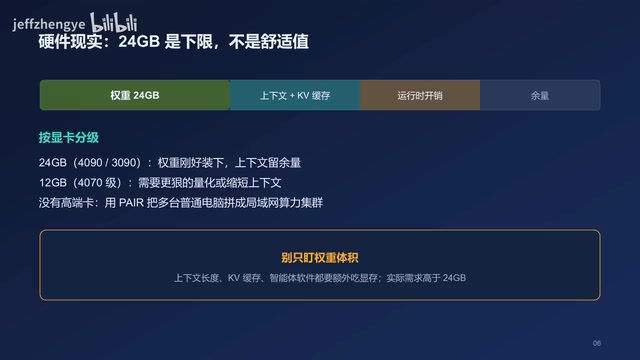
对没有高端显卡的用户,据视频介绍,同一天转正的还有免费在线版本可供体验。
KV缓存(Key-Value Cache)是大模型推理显存占用的另一大头。生成每个token时,模型需要复用之前所有token的Key和Value向量,为避免重复计算,这些向量被缓存下来。缓存大小大致与"层数 × 注意力头维度 × 序列长度 × 批大小"成正比,上下文越长、对话越长,占用越大。
举例来说,一个74B级模型在长上下文(如32K tokens)下,KV缓存本身就可能吃掉数GB到十几GB显存,再加上激活值、CUDA运行时和框架开销,24GB显卡跑满长上下文会非常吃力。常见的缓解手段包括KV缓存量化、分组查询注意力(GQA)、滑动窗口注意力等,但都会在效果或实现复杂度上做取舍。
上手路径与时间节点
前提是一张24GB显存的显卡。最简单的路径是Ollama,一条命令拉模型;不想碰命令行的话,用图形界面搜索下载即可直接聊天。
五个主流运行时在首日提供支持,权重在10月15日当天上线。UP主提到发布前几小时在HuggingFace上还搜不到,想尝鲜的话当天晚些时候下载比较稳妥。
两条路线的对撞
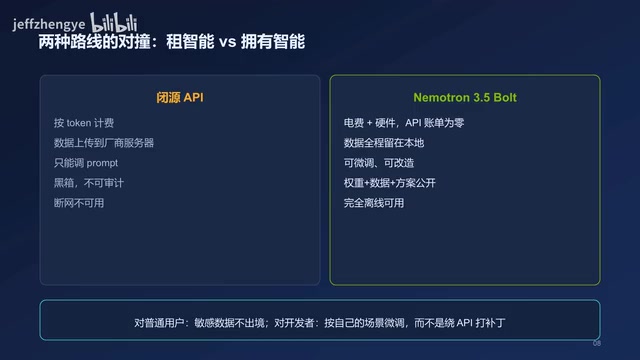
闭源API方案按token收费,数据上传到厂商服务器,用户只能调参,黑箱不可审计,断网不可用。而这个开源项目的路线是:电费加硬件,API账单为零,数据全程留在本地,可以微调、可以改造,权重、数据、方案全部公开,完全离线可用。
真正被击穿的是门槛——不是模型本身变强了多少,而是聪明的模型第一次装进了普通人的显卡。
据该团队官方口径,本地大模型下载量已经达到去年全年的5倍,Qwen3、Llama等本地模型的能力已经赶上几个月前的前沿云端模型。
冷静看待:三个必须注意的问题
第一,没有第三方评测。 "快于多数稠密模型、聪明于同显存模型"是该团队自评结论,独立benchmark尚未出炉。
第二,24GB只是权重下限。 上下文、缓存、运行时开销都要额外显存,实际需求高于24GB。
第三,开源不等于对等。 闭源前沿模型在独立评测上仍然领先,开源方案的价值在于免费和隐私可控,不在于全面超越。
适合谁用?
隐私敏感工作者——医疗、法律、财务领域数据不能离开本地,本地部署是刚需。
智能体实验者——想让AI助手帮忙写代码、监控任务、调用工具,24GB显存能装下目前较大的聪明模型。
已有24GB显卡的人——不用额外投入就能跑起来。
想学习微调的人——训练数据和方案全部公开,复现门槛大幅降低。
不适合期待它立刻超越顶级闭源模型的人。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。