7个Agent构建AI舆情监测平台:LangGraph全栈实战解析

项目概览:贴近生产环境的AI舆情监测系统
随着大模型技术在企业场景中加速落地,由AI Agent(智能体)驱动的自动化应用正成为求职市场的热门方向。所谓AI Agent,是指能够感知环境、自主规划并执行任务的智能程序——与传统的单次问答式大模型调用不同,Agent具备「感知-推理-行动」的闭环能力,可以调用外部工具(如搜索引擎、数据库、API)、分解复杂任务并迭代执行。多Agent系统则进一步将任务拆分给不同职能的智能体,通过协作完成单一Agent难以胜任的复杂工作流。B站UP主花菜近期分享了一个完整的AI自动化舆情监测分析平台项目,系统集成了7个协同工作的智能体,覆盖数据采集、情感分析、话题聚类、预警推送到报告生成的完整链路,是一个值得开发者深入研究的全栈AI工程案例。
这个项目并非简单的Demo,而是一套架构清晰、贴近真实业务场景的舆情分析系统。它以关键词监测为入口,通过爬虫自动抓取全网相关内容,再借助大模型进行语义分析与洞察总结,最终输出可视化大屏与自动化预警。对于正在寻找AI应用开发岗、Agent开发岗实习或正式岗位的开发者而言,这类项目具备较强的简历竞争力。
核心功能模块拆解
系统主要由以下几个功能模块构成:
- 总览大屏:数据统计、Agent实时状态监控、舆情热度趋势、情感倾向分布饼图、平台分布等
- 话题分析:活跃话题、聚类覆盖度、上升趋势话题、话题网络关系图
- 舆情检索:按正面/中性/负面情感筛选爬取到的新闻,可跳转原文链接
- 预警中心:自定义预警规则,触发时自动发送邮件
- 报告管理:一键生成日报/周报,支持Markdown与PDF导出
- 系统设置:自定义监测关键词
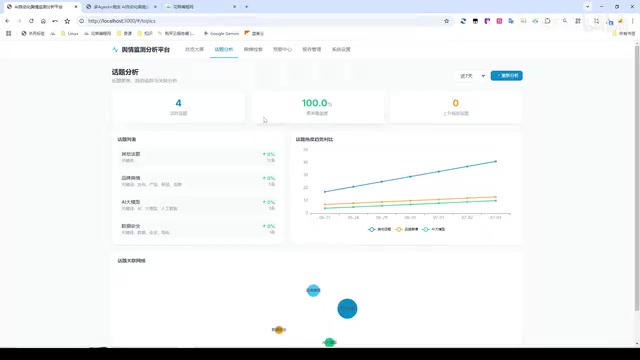
关键技术栈:LangGraph + LangChain + Elasticsearch
这个项目最值得关注的是其技术选型,覆盖了当下AI应用开发的主流工具链。
存储层的三层分工设计
系统采用多种存储方案协同工作,针对不同数据类型进行了合理拆分:
- MySQL:负责结构化数据的持久化存储
- Elasticsearch(ES):同时承担全文索引与向量数据库职责,支撑语义检索能力
- Redis:负责缓存与消息队列,保障任务调度性能
这种"结构化存储 + 全文/向量检索 + 缓存队列"的三层架构是舆情类系统的典型设计。值得注意的是,Elasticsearch自8.x版本起已原生支持向量字段(dense_vector)和基于HNSW算法的近似最近邻(ANN)检索,这使其能同时承担传统关键词全文检索(BM25算法)和向量语义检索(cosine相似度)两种职责。用ES同时处理全文索引和向量存储,无需额外引入Pinecone、Milvus等专用向量数据库,在减少组件依赖的前提下,兼顾关键词检索与语义相似度检索两种需求,是值得借鉴的工程取舍。
AI编排层:LangGraph与LangChain的分工
在多智能体协作方面,项目使用LangGraph构建AI工作流(Agent Workflow),负责7个智能体之间的流程编排与状态通信;同时用LangChain集成大模型能力,处理情感分析、语义提取、报告总结等自然语言任务。
LangGraph是LangChain团队推出的有状态多Agent编排框架,基于有向图(支持DAG及循环图)结构定义工作流——每个节点代表一个Agent或处理步骤,边代表状态流转路径。相比传统链式调用或LangChain原生的AgentExecutor,LangGraph的核心优势在于能够更精细地控制多步骤任务中的状态持久化、错误重试和人机交互介入点,天然支持条件分支、循环与多Agent协作,非常适合舆情监测这类需要多步骤、多角色配合的复杂场景。
自动化采集与预警机制
定时采集与手动触发双模式
系统数据采集支持两种模式:定时自动采集默认每20至30分钟执行一次(间隔可自定义配置);手动采集与分析则方便用户按需立即拉取最新舆情。
采集范围完全由用户在系统设置中配置的监测关键词决定。演示中预设了"自动驾驶、固态电池、大模型、新能源、碳中和"等关键词,并现场展示了新增"特斯拉"关键词后系统立即纳入采集范围的效果,灵活性表现较好。
邮件预警的工程实现
预警中心是这套系统最贴近实际业务价值的模块。用户可自定义预警规则,当出现符合条件的舆情事件时,系统自动向用户发送邮件通知。

演示中使用QQ邮箱服务实现邮件推送,成功收到了包含"高危:固态电池出现负面舆情""碳中和话题热度上升"等预警内容的邮件汇总。值得一提的是,系统内置了重复采集自动合并逻辑,避免同一事件被多次重复推送——这体现了对**幂等性(Idempotency)**设计的考量。幂等性是分布式系统中的核心原则,指同一操作执行多次与执行一次产生的效果相同。在定时任务场景中,网络抖动或任务重叠可能导致同一数据被重复采集,通过对数据源URL或内容哈希值建立唯一索引,系统可在写入时自动检测并合并重复条目,从而避免用户收到重复预警或报告数据失真等问题。这是工程细节上的加分项。
智能报告自动生成
报告管理模块支持一键生成日报和周报。由于报告生成需要调用大模型进行语义提取和内容总结,过程需要短暂等待。

生成的报告结构完整,涵盖日期、采集总量、舆情概览、热点话题、平台分布、预警摘要、趋势洞察及报告总结等内容,并支持导出为Markdown和PDF两种格式,兼顾二次编辑与正式发布的不同场景需求。
"数据采集 → 大模型分析 → 自动生成结构化报告"这一模式,正是AI在企业办公场景中最具落地价值的方向之一,能将原本需要人工数小时整理的舆情汇报工作自动化完成。
作为AI求职简历项目的价值
作者特别强调,这个项目非常适合放进求职简历,并配套提供了完整的支持资料。

配套资料包括:
- 面试问题合集:整理了30个高频面试问题及参考答案
- 简历模板:涵盖后端开发、AI应用、爬虫与数据采集等技术能力的写法示范
- 技术难点与解决方案:如"情感分析结果未写回数据库"等真实工程问题的排查思路
- 系统功能架构设计书:篇幅超过3000行,提供Xmind思维导图版与Markdown版两种形式
对于Agent岗和AI应用开发岗的求职者来说,面试官往往会追问"你在项目中遇到了哪些技术难点",而数据管线调试、层间状态通信、向量检索优化等真实工程问题,正是展示技术深度的好素材。
总结:从架构取舍中提炼真正的能力
这套AI舆情监测平台呈现了当下大模型应用开发的完整技术图景:从LangGraph的多Agent编排、LangChain的模型集成,到ES向量检索、MySQL持久化、Redis缓存队列的分层存储架构,再到自动化采集、邮件预警和智能报告的业务闭环。
值得关注的是,作者提到整个项目"完全由AI编程工具辅助开发",这本身也印证了一个趋势——AI编程工具已经能够帮助开发者快速构建较高复杂度的全栈应用。
对于学习者而言,比功能演示更有价值的是深入理解架构背后的设计取舍:为什么选择ES做向量存储而非Pinecone、Milvus等专用向量库——核心原因在于ES的混合检索能力可以同时满足关键词匹配与语义相似度两种场景,减少运维组件数量?如何设计Agent之间的状态流转,使得LangGraph中各节点的中间状态能被持久化并支持断点恢复?如何通过重复采集合并保证定时任务的幂等性,防止预警风暴?这些问题的答案,才是能够真正转化为个人技术能力的核心所在。
核心要点
相关推荐
98%家庭不付费AI:消费级AI到底是机会还是幻觉?
a16z最新报告显示全美仅2.2%家庭为AI付费,顶级1%用户支出相当于后50%总和。本文深度解析消费级AI应用榜单、大模型格局、企业采购变化,以及"消费者永不付费"的核心辩论与破局路径。

用Codex做生产监控:Grafana、K8s与安全全链路自动排障
基于 OpenAI Codex 的实战演示,拆解如何用 agentic 工作流处理 Grafana 指标异常、Kubernetes 级联故障和安全资源耗尽三类生产故障,把排障时间从一小时压缩到几分钟,并探讨从人在回路到全自动闭环的落地路径。

Cornerstone OnDemand如何用Amazon Bedrock将数据库诊断效率提升78%
Cornerstone OnDemand基于Amazon Bedrock和Strands Agents构建多智能体系统Orion AI,仅用三人团队在六个月内将数据库诊断时间缩短78%,从45分钟降至10分钟。本文解析其架构设计与可复用经验。