8B智能体用隐空间推理在GAIA击败GPT-5.6 Luna,HLE却惨败

HybridAgent用隐空间步骤省token降成本,在检索任务上超越前沿模型,却在知识推理与可审计性上暴露短板。
斯坦福、UIUC 与 Together AI 联合发布的 HybridAgent,让 8B 模型在部分推理步骤中跳过文本生成,经约千万参数的 HybridLink 适配器把最后一层隐藏状态直接回灌为下一步输入嵌入,从而在隐空间完成思考。论文数据显示,跨 3 个模型规模、11 个基准平均提升 10.4%,token 用量减少 35.5% 至 54.7%,成本降低 2.7 至 3.7 倍。但成绩单高度分化:GAIA 得 43.7 分超过 GPT-5.6 Luna 的 37.9 分,HLE 却仅 14.4 分,不到 Luna 的一半。更关键的是,纯文本 8B 智能体 ARPO 在 GAIA 已达 38.8 分,隐空间模式的真实增量有限。此外隐空间步骤无法直接文本记录,伪文本投影只能作粗略线索,给智能体审计带来新挑战;模型还需专用代码栈运行,训练需 32 块 GPU。
斯坦福、UIUC与Together AI联合发布HybridAgent,让80亿参数模型在部分推理步骤中跳过文本生成,直接在隐空间完成计算。据论文Table 1,该模型在GAIA基准上以43.7分超过GPT-5.6 Luna的37.9分,但在HLE知识推理考试上仅得14.4分,不到Luna 29.0分的一半。这种"偏科"表现揭示了隐空间推理的真实边界。
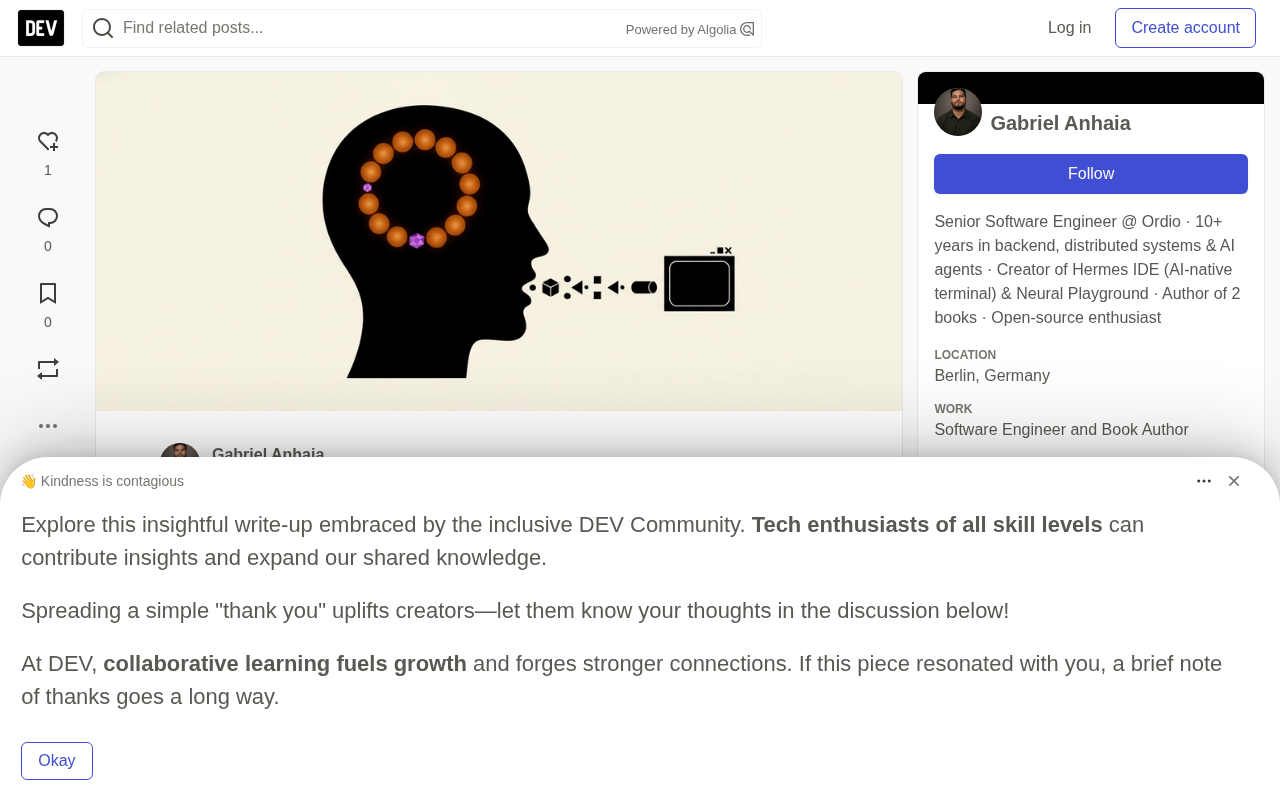
隐空间推理如何运作
传统智能体的每一步思考都输出为文本token——可计费、可记录、可审计。HybridAgent在检测到特殊<latent> token后停止解码,将最后一层隐藏状态经约1000万参数的HybridLink适配器直接回灌为下一步输入嵌入(论文Eq.4)。隐空间段的终止条件由模型自主判断:当输出最接近</latent> token嵌入时退出。
随后模型恢复文本模式执行工具调用或给出答案。跨轮次时保留完整KV缓存(含隐空间步骤),避免将轨迹重新编码为token。HybridRL训练阶段负责教会模型何时静默思考、何时落笔输出。
这一机制的直接收益体现在论文摘要数据中:跨3个模型规模和11个基准平均提升10.4%,token用量减少35.5%至54.7%,推理速度提升1.8至2.6倍,成本降低2.7至3.7倍。
KV 缓存(Key-Value Cache) 是 Transformer 自回归生成中的一项核心优化。在逐 token 生成文本时,模型每步都要对历史序列重新计算注意力,代价随序列长度平方增长;KV 缓存把先前各层已算出的键(Key)和值(Value)矩阵留存下来,后续步骤只需计算新 token 的键值并与之拼接,从而把每步计算降到线性复杂度。跨轮次保留完整 KV 缓存(含隐空间步骤)意味着智能体在多轮交互中不必把先前轨迹重新编码为 token,这正是隐空间模式节省成本的重要来源之一;但缓存需要常驻显存,上下文越长,显存占用越高。
隐藏状态(hidden state) 指模型某一层(通常是最后一层)在特定位置输出的稠密向量,维度即模型的隐藏维度。它汇聚了该位置此前上下文的内部表示,通常在通过输出层投影到词表后用于预测下一个 token。HybridAgent 的做法是跳过这步投影与采样,直接把最后一层隐藏状态经适配器回灌为下一步的输入嵌入,因此在语义空间中延续计算,而不经过离散的文本瓶颈。
成绩单需要逐行阅读
平均10.4%的改善掩盖了基准间的巨大分化。从论文Table 1可以看到:
| 基准 | HybridAgent 8B | HybridAgent 14B | GPT-5.6 Luna | Kimi K3 |
|---|---|---|---|---|
| GAIA | 43.7 | 52.4 | 37.9 | 41.7 |
| WebWalker | 42.5 | 49.5 | 11.0 | 10.0 |
| HLE | 14.4 | 16.0 | 29.0 | 31.4 |
| DeepSearchQA (acc) | 20.0 | 21.7 | 23.3 | 21.7 |
小模型在网页导航和多跳搜索任务上大幅领先,但HLE这类高难度知识推理考试中前沿模型得分接近翻倍。DeepSearchQA上Luna仍然占优。如果你的工作负载接近HLE类型,平均数字并不适用于你。
GAIA、WebWalker、HLE 与 DeepSearchQA 评测的是不同能力。 GAIA 面向通用 AI 助手,题目多为需要网页浏览、文件解析与多步工具调用的现实任务,考察的是智能体的规划与工具使用链路。WebWalker 专注网页导航与多跳信息检索,衡量智能体在站点间跳转、逐层定位信息的能力。HLE(Humanity's Last Exam)是覆盖数学、物理、人文等学科的高难度闭卷知识推理考试,更依赖模型内部存储的学科知识与深度推理,而非检索或工具操作。DeepSearchQA 则评测多跳深度检索问答的准确率。理解这四者的差异,才能解释为何小模型能在 GAIA、WebWalker 上领先,却在 HLE 上落后近一半——前者奖励检索与工具编排,后者奖励知识与推理深度,而隐空间模式优化的恰是前者所依赖的思考步骤成本。
击败Luna的不只是隐空间
同一张表里有一条关键对照:ARPO——一个纯文本、无隐空间模式的8B智能体——在GAIA上已得38.8分,WebWalker得32.0分,两项均略高于Luna。
这意味着8B模型在GAIA上超过Luna并非隐空间模式的独有功劳。隐空间模式真正贡献的是增量:GAIA从38.8提升至43.7,WebWalker从32.0跃升至42.5。这部分提升才是HybridLink机制的价值所在。
成本数字同样需要审慎解读。Table 9估算的是计算成本而非API账单:按每H100小时2.50美元、峰值BF16吞吐10%利用率计算,每个隐空间步骤按一次完整前向传播计费——思考不写token并不免费。估算还排除了prompt预填充、上下文相关注意力和外部工具执行。在这个口径下,8B智能体每百万问题的成本从439美元降至121美元,你的搜索API账单和预填充开销需另行叠加。
不可记录之思:可观测性代价
当前智能体可观测性体系几乎完全依赖文本:推理链、工具调用、最终答案。隐空间段没有文本可供读取。Hacker News讨论串中有评论者直接提出疑问:"可监控性和安全性怎么办?这会导致文本推理轨迹数量减少或准确性下降吧?"
作者提供了一扇窗口:每个隐空间步骤可映射到最近的token嵌入,生成所谓"伪文本",可读性分数取词汇表上最佳余弦匹配均值(论文附录F)。仓库附带的检查器能将隐空间段输出为HTML报告。
但最近token解码只能告诉你隐藏状态指向哪个词,无法证明该词就是该步骤实际计算的内容。论文附录B.1还描述了小误差在长隐空间段中逐步累积、"逐渐侵蚀隐空间轨迹的语义连贯性"的问题。如果你的审查流程依赖阅读智能体推理过程,隐空间智能体给你的更少——你读不到的步骤,恰恰是节省token的那些步骤。
ReAct 风格的文本推理轨迹 是当前智能体可观测性的基石:模型把“思考—行动—观察”逐步写成自然语言,人类审查者、日志系统与安全过滤器都直接读取这些文本。隐空间步骤绕过了这一层,等价于把部分思维过程移出日志。业界常用的审计手段,包括推理链回放、基于文本的越狱与有害行为检测、以及失败归因分析,都高度依赖可读的中间文本;这类步骤减少后,检测覆盖率会随之下降,需要以隐藏状态探针、激活监控等替代手段补位,而这些手段目前尚不成熟。余弦相似度最近邻解码 是论文伪文本窗口的实现方式:把隐空间向量与词表中各 token 的嵌入逐一计算余弦相似度,取最接近者作为“该步在说什么”的近似。它本质上是一种投影式解释,反映的是向量在嵌入空间中的方位,而非模型在该步真正编码或运算的语义内容,因此只能作为粗略线索,不能当作推理证据。
上手门槛与早期反馈
仓库以MIT协议开放权重、训练数据和代码。两个模型HybridAgent-8B-Agentic和HybridAgent-14B-Agentic均基于Qwen3底座,可调用Python解释器和网页搜索工具(需Tavily API密钥)。
需要正视的限制条件:模型卡明确说明仅用transformers加载得到的是纯文本模型,隐空间模式和工具调用必须经由HybridAgent代码栈。目前没有推理服务商托管该模型。作者还指出verl和vLLM"不直接支持多轮混合生成",因此扩展了自己的技术栈。训练侧更重:README建议HybridRL使用32块GPU。
HN讨论串中一位评论者报告运行14B模型时"在相同段落的变体上循环了五分钟直到耗尽轮次预算",怀疑与llama.cpp不兼容。结合模型卡警告,在HybridAgent引擎之外运行根本没有测试到混合推理部分。
取舍判断
对于搜索密集型任务——你只检查答案而不审查路径——更便宜的隐空间智能体有吸引力。对于任何需要审计的场景,可读的文本推理链仍然不可替代。HybridAgent的GAIA和WebWalker优势提醒我们:智能体检索到的内容仍然决定答案的大部分质量,而隐空间模式省下的是思考过程的成本,不是知识本身的成本。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。