8GB显卡跑出48t/s:CachyOS+STRATA让本地大模型提速5倍
换用CachyOS发行版并配合STRATA方案,8GB显存本地推理从9t/s飙升至最高48t/s。
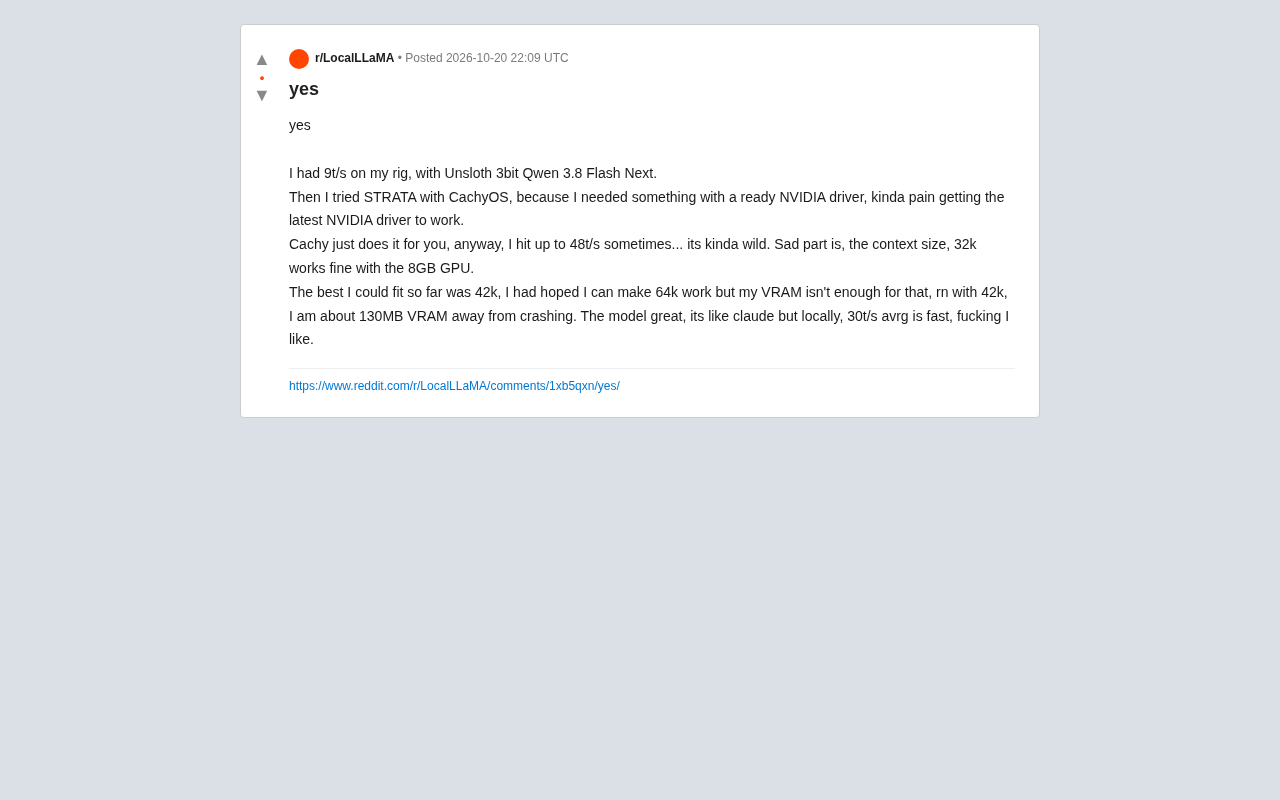
一位 Reddit 用户分享称,在同一台 8GB 显存机器上运行 Unsloth 3bit 量化的 Qwen 3.8 Flash Next 模型,原本推理速度约 9 tokens/秒,换用基于 Arch 的 CachyOS 发行版并尝试 STRATA 方案后,速度最高达 48t/s,日常平均约 30t/s。CachyOS 还解决了手动安装最新 NVIDIA 驱动的痛点。显存方面,32k 上下文运行稳定,推到 42k 时距显存崩溃仅剩约 130MB,64k 则明显不够,说明 8GB 显存的稳定甜点区在 32k 左右。用户评价该模型体验"像本地的 Claude"。文章认为,这一案例揭示了软件栈匹配度对本地推理体验的决定性作用,但 STRATA 的具体实现未披露,复现需谨慎。
本地大模型玩家常被两件事折磨:驱动配置和推理速度。最近Reddit上一位用户的分享给出了一个反直觉的解法——换一个发行版,速度直接翻了五倍。
从9t/s到48t/s:一个发行版带来的质变
这位用户原本的配置是:Unsloth 3bit量化的Qwen 3.8 Flash Next,在同一台机器上跑出约9 tokens/秒。后来他换用CachyOS——一个基于Arch的Linux发行版——并尝试了STRATA方案(推测为某种推理加速框架或配置),速度飙升到最高48t/s,日常平均也有30t/s。
他自己形容"有点疯狂"。更关键的是,CachyOS解决了NVIDIA驱动的安装难题。原话是手动装最新NVIDIA驱动"挺痛苦",而CachyOS"直接帮你搞定"。
这个案例的价值不在于具体数字,而在于揭示了本地推理性能的一个常见盲区:软件栈的匹配度,往往比硬件本身更决定实际体验。
CachyOS 是一个基于 Arch Linux 的滚动更新发行版,主打性能优化。它默认采用针对现代 CPU 指令集(如 x86-64-v3/v4)编译的内核与软件包,并集成了 BORE 调度器、UKSMD 等面向桌面响应和游戏性能的调优项。对本地 AI 用户而言,最实际的便利是它提供开箱即用的 NVIDIA 专有驱动安装脚本(通过 cachyos-hello 或 chwd 工具),能自动处理内核模块签名、DKMS 构建与驱动版本匹配,省去手动编译和解决依赖冲突的麻烦。Arch 系的软件仓库更新快,也更容易获得较新的 CUDA 工具链,这对推理框架的兼容性有直接帮助。
8GB显存的极限拉扯:42k上下文与130MB的生死线
速度提升之外,显存管理是另一个看点。用户的GPU只有8GB,在32k上下文下运行稳定,但他把上下文推到了42k——此时距离显存崩溃只剩约130MB余量。他原本想上64k,但显存明显不够。
这说明两件事。其一,8GB显存跑32k上下文是当前比较稳妥的甜点区;其二,小显存设备上,上下文长度与稳定性之间需要精细权衡。130MB的余量意味着任何后台进程波动都可能导致OOM,这种"走钢丝"状态并不适合日常使用。
用户对模型本身的评价颇高:"像本地的Claude"。30t/s的平均速度让他觉得"快,我喜欢"。这个类比值得玩味——本地小模型在特定量化方案下,体验正在逼近云端闭源模型。
KV Cache(键值缓存) 是大模型推理中随上下文长度线性增长的显存开销来源。生成每个 token 时,模型需要缓存此前所有 token 的 Key 和 Value 张量以避免重复计算,其大小约等于 2 × 层数 × 注意力头维度 × 序列长度 × 精度字节数。在 8GB 显存上,模型权重(3bit 量化后仍占数 GB)与 KV Cache 争夺空间,上下文从 32k 推到 42k 时,KV Cache 可能增加数百 MB 至 1GB 以上,这正是剩余显存被迅速吃掉的直接原因。采用 GQA(分组查询注意力)或 MLA(多头潜在注意力)的模型能显著压缩 KV Cache,这也是小显存跑长上下文的关键架构前提。
STRATA+CachyOS组合的启示
这位用户的配置组合有几个值得关注的点:
发行版选择被低估了。 大多数人讨论本地推理时聚焦于GPU型号和量化方案,但操作系统层面的驱动适配、内核调度策略同样影响吞吐。CachyOS面向性能优化,加上开箱即用的NVIDIA驱动,降低了入门门槛。
3bit量化是8GB显存的关键。 Unsloth的3bit Qwen方案能在有限显存下塞进更大上下文,这是42k能跑起来的前提。
STRATA的角色尚不明确。 原文未详细说明STRATA是推理框架、内核补丁还是某种配置方案,但它是速度跃升的关键变量。这一点需要更多信息才能判断可复现性。
Unsloth 是一个专注于高效微调与推理优化的开源项目,其核心手段包括手写 Triton 内核、动态 4bit/3bit 量化(如 unsloth_bnb_4bit 系列)以及减少显存峰值的梯度检查点策略。所谓 3bit 量化并非标准 bitsandbytes 配置,通常指 Unsloth 自研的非对称量化方案,在保留模型质量的同时将权重压到约 3bit/参数,使 7B 级模型权重降至 3GB 左右,从而为长上下文留出显存。需要说明的是,量化位宽越低,对校准数据和内核实现的要求越高,不同硬件上的实际加速比差异较大,这也是该案例数字难以直接复现的原因之一。
结论
如果你手上有8GB显存的机器,并且被驱动和速度问题困扰,这个案例提供了一个可尝试的方向:换一个对NVIDIA友好的发行版,配合3bit量化模型,32k上下文是安全线,42k是极限操作。速度上的提升可能远超预期。
当然,单一用户的体验不能代表普遍结果。STRATA的具体实现、模型版本、硬件细节都未完整披露,复现时需谨慎。但从9t/s到30t/s的日常提升,足以让人重新审视软件栈的优化空间。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。