8G显存本地跑通MiniMax H3:ComfyUI整合包实测
8G显存本地免费跑MiniMax H3视频生成模型,秋叶整合包+4步Lora让消费级显卡也能用。
本文介绍了一套基于 MiniMax H3(海螺开源视频模型)的消费级本地部署方案。借助秋叶 ComfyUI 整合包和 4 步 Lora 加速,8G 显存的普通显卡即可免费、无排队地在本地生成带音画同步的 AI 视频。部署分四步:准备场景与人物素材、下载四类模型文件(主模型约 19G)、将模型归位并启动 ComfyUI、加载社区验证工作流。关键参数组合(15 秒时长、0.4→0.8 二次采样、Multiple=32、英文提示词)是低显存下跑通的核心。当前成品本质仍是预生成视频,真正的想象空间在于进化为能实时语音交互的 3D 数字角色,但那需要串联 ASR、LLM、TTS 与实时渲染的完整链路,硬件门槛大幅提升。
开源视频生成模型 MiniMax H3(海螺开源版)近期在本地部署圈引发关注。一位 B站 UP主给出了完整的 8G 显存本地部署方案,借助秋叶 ComfyUI 整合包和 4 步 Lora 加速,让原本吃硬件的视频生成模型在消费级显卡上也能跑起来。本文梳理其部署流程、关键参数与实际效果,并探讨这类「AI桌面女友」玩法背后的技术走向。
MiniMax H3 本地部署为什么值得关注
MiniMax H3 是海螺(Hailuo)开源的视频生成模型,最大的吸引力在于三点:本地运行完全免费、不需要积分和排队、自带音画同步输出。相比在线服务受限于配额和审核,本地部署给了创作者更高的自由度——人物形象、背景场景、服装动作乃至角色说话内容和语气,都可以通过提示词自行调整。
过去 ComfyUI 最大的门槛不在模型本身,而在环境配置。CUDA、依赖库、报错回滚,劝退了大量非技术用户。这次方案采用秋叶整合包的思路,把安装环节压缩成「一键解压即用」,全中文界面,理论上降低了上手成本,这也是它能快速传播的核心原因。
部署流程拆解:四类模型 + 整合包
整套流程可以拆成四步,逻辑并不复杂,关键是文件归位要准确。
第一步:准备素材
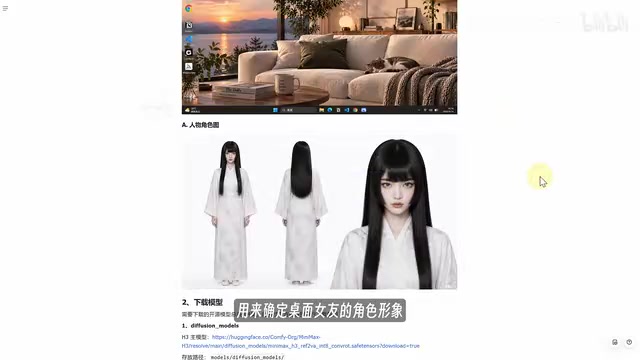
需要两张图片——一张沙发场景图作为视频背景,一张人物参考图确定角色形象。人物图约束不严,三视图或单张角色图都可以,后续想换人物也不受影响。
第二步:下载四类模型文件
- Diffusion Models:主模型,体积最大,约 19G;
- 文本编码器(Text Encoder):按页面提示下载即可;
- Lora 模型:UP主特别强调下载「4步 Lora」,这是提速的关键。加上它后生成速度明显更快,画质会略有损失但影响不大,综合体验值得;
- VAE 模型:共两个,全部下载。
这四类模型文件在视频生成流程中各司其职。Diffusion Model(扩散模型)是核心,负责在潜在空间中通过逐步去噪生成视频帧内容,体积最大因为它承载了视频的运动、外观和时序知识。文本编码器(通常为 CLIP 或 T5 系列)负责将提示词转化为模型可理解的向量表示,引导扩散过程的生成方向。VAE(变分自编码器)则承担像素空间与潜在空间之间的转换——编码时将输入图像压缩为低维潜在表示以节省显存,解码时再将生成的潜在向量还原为可视化的视频像素。Lora(Low-Rank Adaptation)是一种轻量级微调模块,通过在原模型权重上叠加低秩矩阵来改变模型行为,此处「4步 Lora」专门用于将推理步数从默认的数十步压缩至 4 步,从而大幅缩短生成时间,代价是轻微的画质损失。
第三步:安装 ComfyUI 整合包
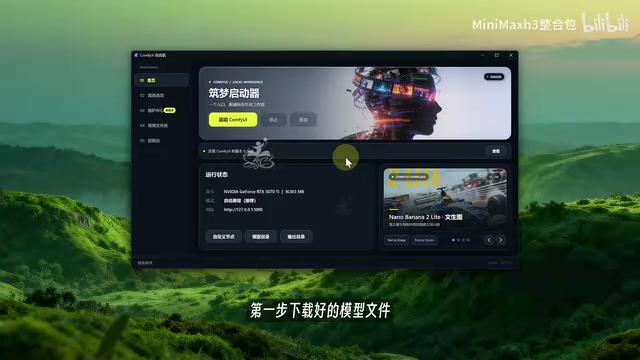
下载整合包后先别急着运行。要先把四类模型按类别放进 ComfyUI 对应目录——Diffusion Models 进 diffusion_models 文件夹,Lora 进 loras 文件夹,其余同理各归其位。模型放好后再启动 ComfyUI。
第四步:加载工作流
把配套工作流文件拖进 ComfyUI 界面即可加载。左侧两个上传位分别放场景图和角色图,再把文档里的提示词粘贴进去。这套工作流经过社区多人验证,属于「拿来就能用」的成熟方案。
ComfyUI 是一款基于节点式工作流的图形界面,最初用于 Stable Diffusion 图像生成,现已扩展支持视频生成模型。它的核心设计是将模型推理过程拆解为可视化节点图:每个节点代表一个处理步骤(如加载模型、编码文本、去噪采样、解码输出),节点之间的连线代表数据流向。用户可以通过拖拽和连接节点自由组合推理流程,而无需修改代码。「工作流」文件(通常为 .json 格式)则是这套节点图的保存与复用形式——将别人验证好的工作流拖入界面,即可直接复现其完整推理配置,这也是社区协作传播技术方案的主要方式。秋叶整合包在此基础上进一步预装了 Python 运行环境、CUDA 依赖和常用插件,省去了手动配置环境的步骤。
关键参数:8G 显存的平衡点
这部分是全流程的技术核心,也是能否跑通的分水岭。
- 提示词语言:实测英文提示词效果普遍优于中文,追求稳定输出建议优先用英文;
- 视频时长:默认 15 秒最稳妥。8G 显存跑 15 秒已属勉强但可接受,个人建议不超过 30 秒;
- 分辨率比例:横屏视频选 16:9;
- 百万像素参数:设 0.4。工作流内部实际带了二次采样——第一次 0.4 百万像素,第二次 0.8 百万像素,这样速度与效果更平衡;
- Multiple 参数:保持默认 32。H3 模型训练时本身按 32 的倍数分辨率处理,无需改动。
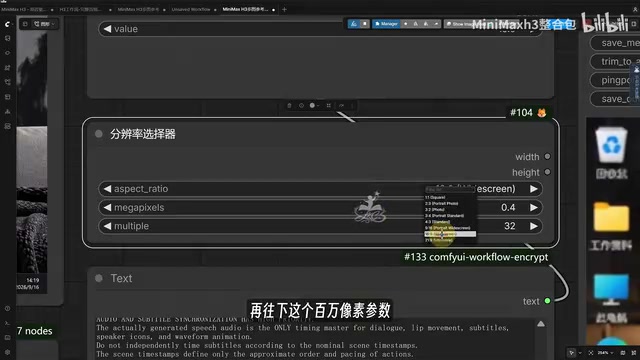
UP主反复提醒:本地部署最忌一上来就拉高分辨率和时长。显存不够时轻则龟速,重则直接爆显存。稳妥做法是先按上述参数跑通,确认无误后再根据显卡性能逐步上调。这也是 8G 显存能「确实可用」的前提——参数克制换来了可运行性。
「百万像素」参数与「二次采样」设计涉及视频生成中常见的分辨率-显存权衡策略。以 0.4 百万像素(约 640×625)进行第一次扩散采样,可以让整个去噪过程在显存有限的条件下完成,因为潜在空间的尺寸与目标分辨率直接挂钩。完成后再以 0.8 百万像素进行第二次采样(类似图像超分或高分辨率修复),在已有低分辨率结果作为引导的前提下,用较少的步数补充细节,显存峰值压力远低于直接在 0.8 百万像素下全程采样。Multiple 参数保持 32 则与模型的训练设置对齐——H3 在训练时将分辨率统一对齐到 32 的整数倍,推理时保持一致可避免因尺寸不匹配导致的伪影或性能下降。
效果与局限:本质仍是预生成视频
从演示看,成片可以实现角色从画外走进来、坐上沙发、换装、开口对话等连贯动作,整体效果不错,音画同步也到位。工作流自由度高,人物、场景、服装、动作、台词、声音语气都能自定义。
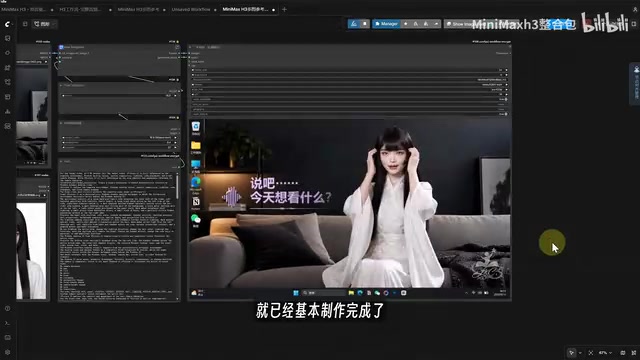
但需要清醒认识:现在做出来的「AI桌面女友」本质仍是一段提前生成好的 AI 视频。所有动作和对话内容,都是事先通过提示词设计好的,并非实时交互。
从预生成视频到实时数字角色
UP主在结尾抛出了更值得思考的方向:如果把它做成实时运行的 3D AI 角色,性质就完全不同了。届时它不再是预渲染视频,而是能实时听懂语音、经大模型理解后即时回复,甚至读取电脑状态做出反应——工作太久提醒休息、打开某软件跑来互动、不同对话触发不同表情动画。
这条路的技术复杂度陡增,需要串起本地语音识别、AI 大模型、语音合成、3D 渲染、角色动画和实时交互一整套链条,对 CPU、GPU 和显存的要求远高于当前的视频生成方案。从「一段视频」到「一个活的数字角色」,是量级上的跨越,也是本地 AI 应用值得期待的下一站。
实时数字角色方案在技术架构上通常被称为「具身对话代理」或「虚拟数字人」。其完整链路包括:本地语音识别(ASR)将用户语音转为文字,大语言模型(LLM)理解语义并生成回复文本,文本转语音(TTS)合成带情感的语音,再驱动 3D 角色完成口型同步与表情动画,最终通过实时渲染引擎(如 Unity 或 Unreal)输出画面。每个环节均有延迟要求,整体端到端延迟需控制在数百毫秒内才能保证交互流畅。与视频生成方案的「离线批处理」不同,这条链路要求各组件并行运行且持续占用资源,对 CPU 调度、GPU 并发和内存带宽的综合要求显著更高。目前已有 Live2D 驱动方案、基于 Gaussian Splatting 的实时重建以及商用数字人中间件等不同技术路径在探索这一方向。
小结
这份方案的价值不在于模型本身有多先进,而在于它把 MiniMax H3 的部署门槛压到了消费级硬件可承受的范围:8G 显存、免费、中文界面、一键整合包。4步 Lora 提速和二次采样的参数设计,是它能在低显存下跑通的关键。对想入门本地视频生成的用户来说,这是一个门槛友好的起点;而真正的想象空间,在于把预生成视频进化为实时交互的数字角色。
相关推荐
Vibe Coding 深度解读:从写代码到指挥AI的一人公司实战路径
Vibe Coding 是什么?本文解读从「人写代码」到「人指挥AI」的开发新范式,涵盖Claude Code、Codex、Cursor等工具协同、全链路闭环、多端开发与AI自动化运营,剖析一人公司与超级个体的机会与误区。
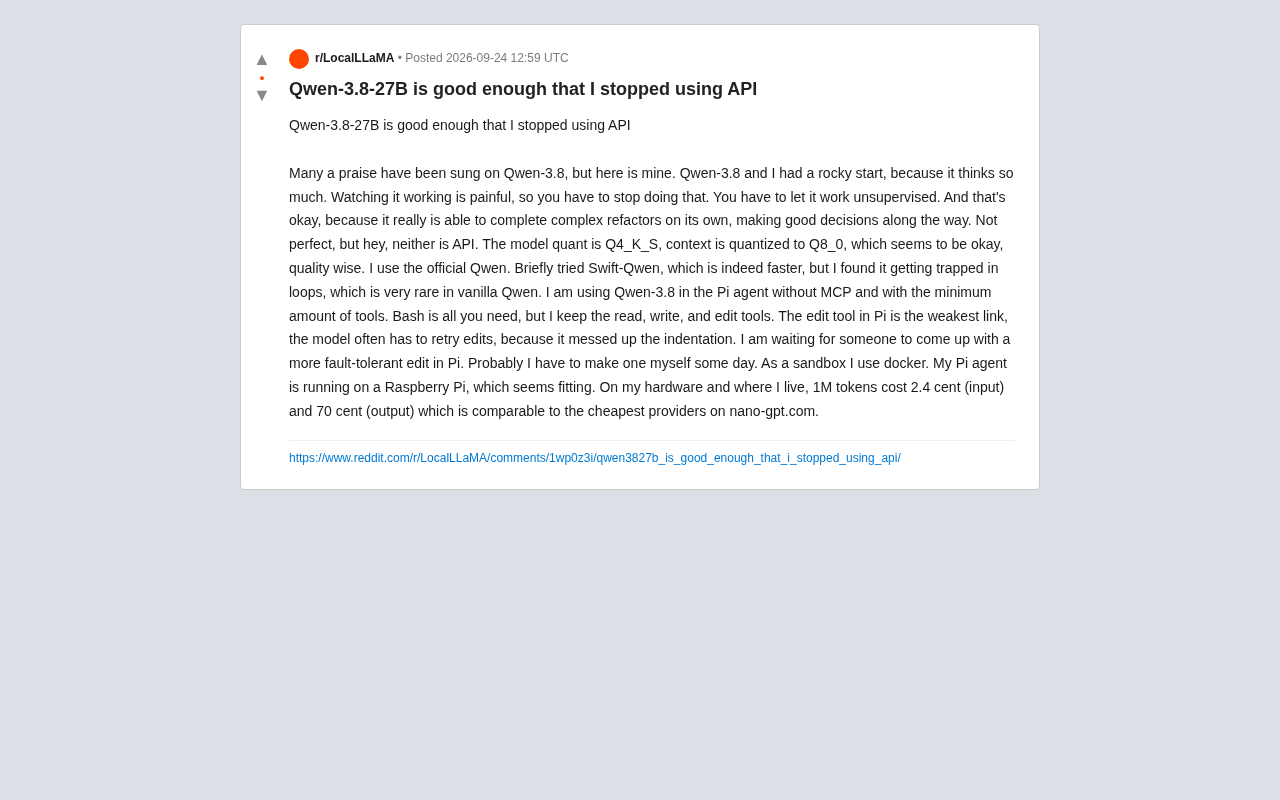
本地跑 Qwen-3.8-27B 替代 API:一位开发者的实战体验
一位 Reddit 开发者分享用本地 Qwen-3.8-27B 完全替代云端 API 的实战经验,涵盖 Q4_K_S 量化、Pi agent 极简工具链、树莓派部署与详细成本核算,探讨开源大模型「够用」的临界点。
生产环境中如何验证AI Agent的行为?运行时校验实战指南
AI Agent在生产环境代表用户执行操作时如何验证其行为?本文从非确定性输出、不可逆副作用等挑战出发,梳理策略护栏、人在回路、运行时追踪、LLM评判等验证方法,帮助团队构建分层防御体系。