本地跑 Qwen-3.8-27B 替代 API:一位开发者的实战体验
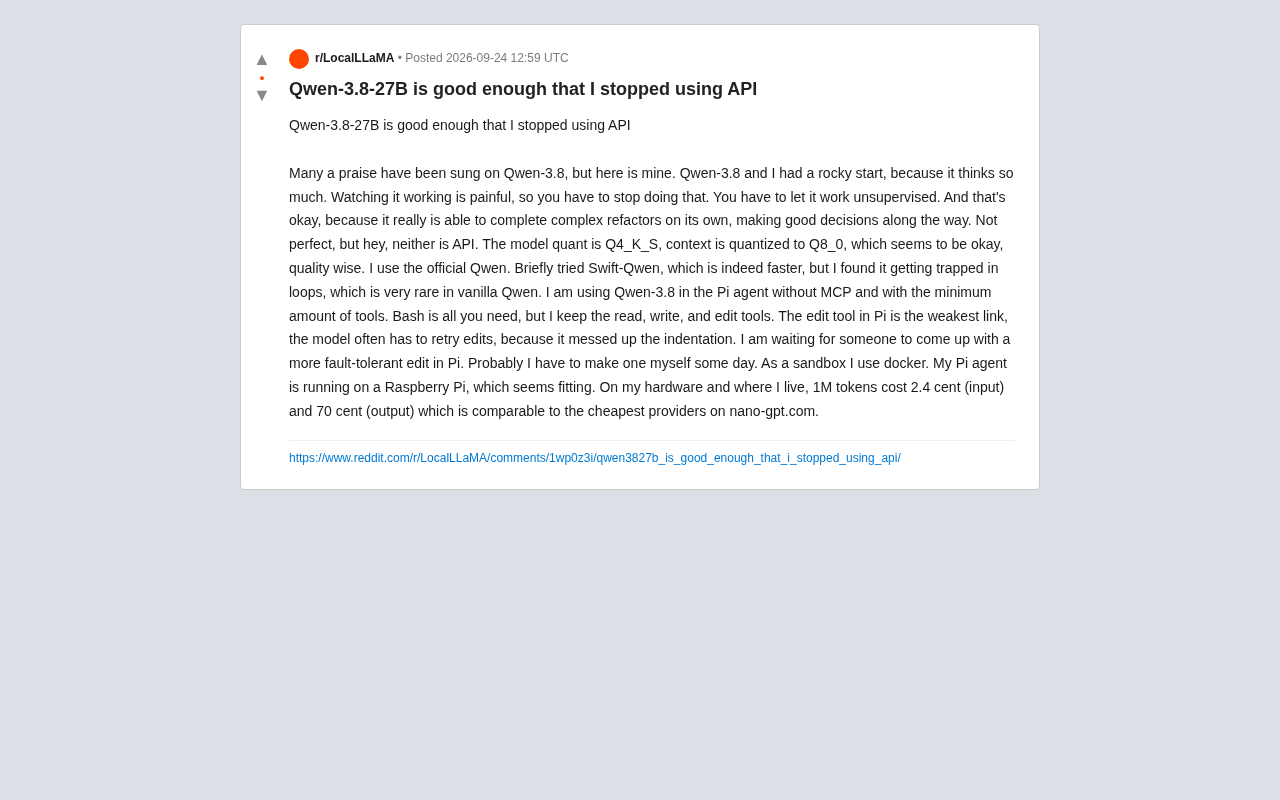
本地部署 Qwen-3.8-27B 量化模型配合极简工具链,已能以接近云端 API 的质量和成本完成真实编程重构任务。
一位开发者分享了用本地部署的 Qwen-3.8-27B(Q4_K_S 量化)完全替代商业 API 的实践经验。核心发现包括:推理型模型需要「放手让其无监督工作」的使用心态,强行观察其冗长思考链反而适得其反;工具链应极简化,Bash 加三个基础工具足以覆盖大多数编程任务,工具越少本地模型完成率越高;稳定性优先于速度,Swift-Qwen 虽更快却易陷入推理循环,不适合长时间无监督运行的 Agent 场景。成本方面,每百万 token 约 2.4 美分(输入)/70 美分(输出),与最便宜的云端服务商持平,同时附带数据隐私和无速率限制等额外价值。这个案例表明,27B 级别的开源模型经过量化和精心的工具链设计,已从「玩具」级别升级为可用于真实生产任务的「工具」。
开源大模型的能力边界正在快速逼近商业 API。一位 Reddit 开发者分享了自己用本地部署的 Qwen-3.8-27B 完全替代云端 API 的经历,这个案例值得关注:它不仅涉及模型能力本身,更牵扯到量化方案、Agent 工具链和成本核算等实操细节。
从「痛苦」到「放手」的磨合期
这位开发者坦言,与 Qwen-3.8 的合作有一个「艰难的开始」——因为它「想得太多」。观察模型的推理过程是一种折磨,长时间的思考链让人忍不住想介入。他给出的解法是:干脆别看,让它无监督地工作。
这背后其实反映了一个使用推理型模型的关键心态转变。推理模型(reasoning model)的价值恰恰在于它愿意花更多计算完成复杂任务,而人类如果习惯了传统模型的即时响应,反而会因为等待和冗长的思考过程产生焦虑。他发现,一旦放手,Qwen-3.8 确实能独立完成复杂的代码重构,并在过程中做出合理的决策。
他也没有过度美化:模型「不完美,但 API 也不完美」。这种务实的对比,恰恰是判断本地模型是否够用的正确标尺——不是追求完美,而是看它能否达到与付费方案相当的实用水平。
量化方案与模型版本的取舍
技术细节上,他选择的量化配置是权重 Q4_K_S、上下文量化到 Q8_0,实测在质量上「看起来没问题」。这是在消费级或边缘硬件上运行大模型的常见平衡点——用可接受的精度损失换取显存占用的大幅下降。
值得一提的是他对模型分支的对比。他短暂尝试过 Swift-Qwen,速度确实更快,但发现它容易「陷入循环」(getting trapped in loops),而这种情况在原版 Qwen 中非常罕见。这提醒我们,加速优化过的模型变体虽然性能诱人,却可能在稳定性上付出代价。对于需要长时间无监督运行的 Agent 场景,稳定性往往比速度更重要。
Q4_K_S 与 Q8_0 是 GGUF 格式中常见的量化精度标识,由 llama.cpp 生态推广。数字代表每个权重使用的比特数:Q4 表示 4-bit 量化,Q8 表示 8-bit 量化;K 表示使用了"k-quant"算法,它通过对不同层分配不同精度来提升质量;S/M/L 则对应 Small/Medium/Large,代表同一比特数下的压缩激进程度。以 27B 参数模型为例,全精度(FP16)需要约 54GB 显存,而 Q4_K_S 可将其压缩至约 15-16GB,代价是轻微的精度损失。上下文量化选择 Q8_0 则意味着在 KV Cache(键值缓存,用于存储注意力机制的中间状态)上保留了更高精度,这对推理质量的影响往往比权重量化更显著,是在显存有限时优先保证输出质量的常见策略。
Bash 就够了:极简工具链哲学
在 Agent 架构上,这位开发者的做法相当克制。他在 Pi agent 中使用 Qwen-3.8,没有接入 MCP(Model Context Protocol),只保留最少量的工具。他的原则是「Bash is all you need」——一个 Bash 工具几乎能覆盖大部分操作需求,此外只保留了 read、write 和 edit 三个工具。
这种极简主义并非偷懒。工具越多,模型的决策空间越大,出错和分心的概率也越高。对能力有限的本地模型来说,收窄工具集反而能提升任务完成率。
他指出的痛点是 Pi 的 edit 工具是「最薄弱的一环」,模型经常需要重试编辑,原因是搞错了缩进。他期待社区能做出更容错的 edit 实现,甚至考虑自己动手。这个细节很真实:本地 Agent 的瓶颈往往不在模型本身,而在工具的鲁棒性上。缩进、格式这类细节错误,会显著拖累整体效率。
MCP(Model Context Protocol)是 Anthropic 于 2024 年底推出的开放协议,旨在为 AI 模型提供标准化的工具和数据源接入方式,类似于为 Agent 定义一套「USB 接口规范」,让模型能以统一方式调用文件系统、数据库、Web 搜索等外部能力。这位开发者主动放弃 MCP 的决定,体现了一种对本地中等规模模型的清醒认知:MCP 生态的丰富工具集更适合能力更强的模型(如 Claude 3.5/GPT-4 级别),它们有足够的上下文理解和规划能力来驾驭复杂的工具组合。对 27B 量化模型而言,工具数量本身就是认知负担,精简到「够用的最小集合」反而能让模型将有限的推理容量集中在核心任务上。
在树莓派上跑 Agent 与成本核算
最有趣的部署细节是:他的 Pi agent 运行在一台 Raspberry Pi(树莓派)上,并调侃这「很搭」(Pi agent on a Pi)。沙箱环境则用 Docker 隔离,保证代码执行的安全性。
成本方面,他给出了具体数字:在他的硬件和所在地区,每 100 万 token 的成本约为 2.4 美分(输入)和 70 美分(输出)。他强调这与 nano-gpt.com 上最便宜的服务商价格相当。
这个数字是整个案例的说服力所在。本地部署的电费成本已经能与最廉价的云端 API 掰手腕,同时还带来了数据隐私、无速率限制、无网络依赖等附加价值。当然,这个测算高度依赖当地电价和硬件折旧,未必适用于所有人,但它至少证明了本地方案在经济性上已经不再是天方夜谭。
这里的「Pi agent」双关指两层含义:一是运行在 Raspberry Pi(树莓派单板计算机)上的轻量调度进程,负责向本地运行大模型的主机发送请求;二是 Agent 框架本身的名称。树莓派在此充当的是任务调度器和接口层,而非模型推理的算力来源——27B 量化模型的实际运算发生在另一台配备足够 VRAM 的机器上。Docker 沙箱的作用则是隔离模型生成代码的执行环境,防止 Agent 在自动运行时意外修改宿主系统文件或执行危险命令,这是本地无监督 Agent 的基本安全实践。成本测算中的「输入远低于输出」现象也符合实际:推理型模型在生成回复时会产生大量思考链 token,输出 token 数往往是输入的数倍,因此输出成本占主导。
这个案例说明了什么
单一开发者的体验当然有其局限——它是主观的、依赖特定硬件和地区的,且缺乏严格的基准测试。但它折射出一个正在发生的趋势:中等规模的开源模型(27B 级别)在量化后,配合精心设计的 Agent 工具链,已经能够胜任真实的编程重构任务。
对于关注成本、数据隐私或单纯喜欢折腾本地部署的开发者来说,「够用就好」的临界点正在到来。API 依然有它的优势——更强的峰值能力、免运维、更大的上下文窗口,但对相当一部分日常任务而言,本地方案已经从「玩具」变成了「工具」。
真正的门槛不再是模型能不能用,而是你愿不愿意投入时间去调优量化配置、精简工具集,并容忍一些不完美。
相关推荐
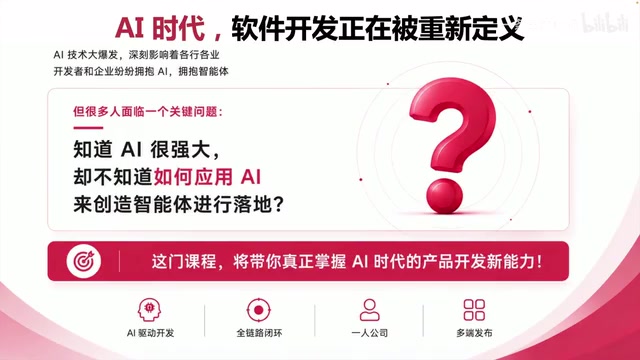
Vibe Coding 深度解读:从写代码到指挥AI的一人公司实战路径
Vibe Coding 是什么?本文解读从「人写代码」到「人指挥AI」的开发新范式,涵盖Claude Code、Codex、Cursor等工具协同、全链路闭环、多端开发与AI自动化运营,剖析一人公司与超级个体的机会与误区。
生产环境中如何验证AI Agent的行为?运行时校验实战指南
AI Agent在生产环境代表用户执行操作时如何验证其行为?本文从非确定性输出、不可逆副作用等挑战出发,梳理策略护栏、人在回路、运行时追踪、LLM评判等验证方法,帮助团队构建分层防御体系。
TechCrunch Disrupt 2026 门票优惠倒计时:省200美元的最后机会
TechCrunch Disrupt 2026 早鸟门票优惠进入倒计时,最高可省 200 美元,9 月 25 日截止,第二位嘉宾享 5 折。官方重点强调参会理由之一:获取务实、可落地的行业答案。