95%准确的Agent为何50步任务成功率仅7.7%?

单步准确率95%的Agent在50步任务中成功率仅7.7%,长任务可靠性需系统思维。
文章从Reddit热门讨论出发,揭示单步准确率与端到端任务成功率之间的巨大鸿沟:在独立假设下,n步任务成功率为p的n次方,95%单步准确率的Agent完成50步任务仅7.7%,即使99%也仅60.5%。要达成95%端到端成功率,20步任务需单步准确率99.74%,50步需99.90%,意味着错误率降低10倍,往往需要架构性改变。文章进一步指出减少步骤与提升单步准确率效果相当且成本更低,并建议引入弃权与升级机制阻断错误级联。现实中的错误还会因上下文污染而叠加,实际成功率可能低于理论值。作者呼吁团队在实际任务长度上跟踪端到端完成率。
引言:为什么演示很美好,生产很残酷?
许多团队在评估AI Agent时,习惯性地引用单步准确率(per-step accuracy),因为这是评测脚本最容易打印出来的数字。然而,用户真正关心的是Agent能否完整地完成整个任务。Reddit上的一篇热门讨论指出:一个单步准确率高达95%的Agent,在完成50步任务时,成功率仅有7.7%。这个数字揭示了Agent从演示走向生产环境时面临的核心挑战。
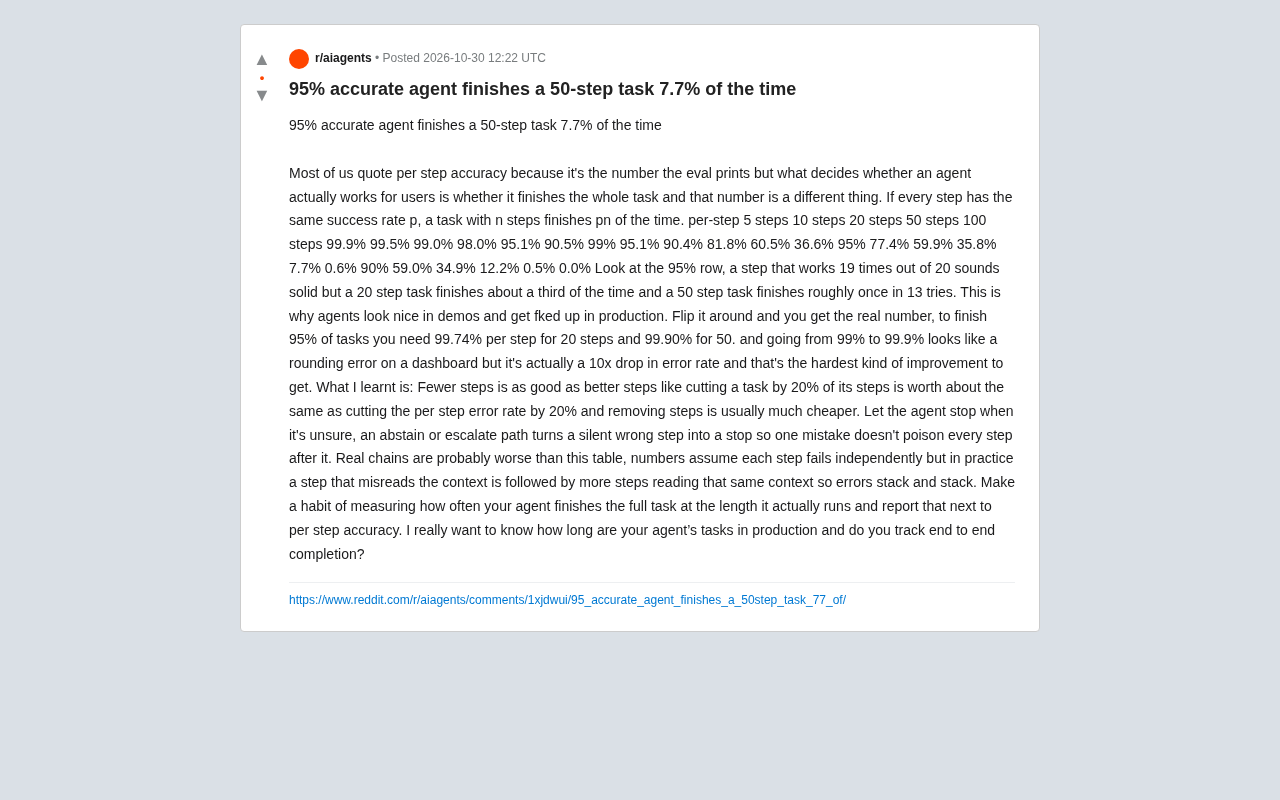
单步准确率的幻觉:概率乘法下的真相
如果每个步骤的成功率都是独立的p,那么一个n步任务的成功率就是p的n次方。根据原帖提供的表格,我们可以清晰地看到这种指数衰减的威力:
- 单步准确率95%的Agent,在5步任务中成功率为77.4%,10步为59.9%,20步降至35.8%,50步时仅剩7.7%,100步时几乎归零(0.6%)。
- 即使是单步准确率**99%**的Agent,在50步任务中成功率也只有60.5%,100步时降至36.6%。
- 而单步准确率**99.9%**的Agent,在50步任务中成功率可达95.1%,但到了100步也跌至90.5%。
原帖作者指出,95%的单步准确率意味着“每20次执行中有19次成功”,听起来很可靠,但一个20步的任务只有大约三分之一的机会能完整跑完,50步任务更是大约每13次尝试才能成功一次。这解释了为什么Agent在演示中看起来不错,但在生产环境中却频繁出错。
独立同分布假设是上述概率乘法模型成立的前提:每一步的成功概率均为 p,且各步之间互不影响。在数学上,n 步任务全部成功的概率即为 p^n。这一假设在步骤彼此隔离、上下文不累积的场景下近似成立,但真实 Agent 链条中,前序步骤的输出往往作为后续步骤的输入,步骤间存在依赖关系,因此独立假设只是一种理想化的上界。理解这一点,有助于判断表中数字应被视为乐观估计还是精确预测。
反向推导:要达成目标,需要多高的单步准确率?
如果我们希望一个任务有95%的概率被完整完成,那么对单步准确率的要求会变得非常苛刻。根据原帖的计算:
- 对于20步的任务,需要单步准确率达到99.74%。
- 对于50步的任务,需要单步准确率达到99.90%。
从99%提升到99.9%,在仪表盘上看起来只是“四舍五入的误差”,但实际上这意味着错误率降低了10倍,而这是最难实现的改进类型。原帖强调,这种量级的提升往往需要架构性的改变,而非简单的参数调优。
关键洞察:减少步骤与提升单步准确率同等重要
原帖作者从数据中提炼出一个容易被忽视的结论:减少步骤数量与提升单步准确率同样有效。将任务步骤减少20%,其效果大约相当于将单步错误率降低20%,而删除步骤通常成本更低。
这一观点挑战了“唯准确率论”的思维定式。在实际工程中,通过任务分解优化、流程简化或合并冗余步骤,往往能以更低的成本获得显著的端到端成功率提升。
端到端成功率(end-to-end success rate) 衡量的是 Agent 从接收任务到最终交付结果的全过程中,无需人工介入即完整达成目标的频率。与之相对,单步准确率只统计单个动作或单次模型调用的正确比例。两者的关键区别在于:端到端指标将步骤间的依赖、上下文传递和错误累积全部纳入考量,因而更贴近用户体验。在评估体系设计中,端到端成功率通常需要借助任务级测试集和完整执行轨迹来测量,成本高于单步统计,但能揭示长任务中的系统性风险。
让Agent学会“停下来”:弃权与升级机制
原帖提出的另一个重要建议是:让Agent在不确定时停止。通过引入弃权(abstain)或升级(escalate)路径,可以将一个沉默的错误步骤转化为一次明确的停止,从而避免单个错误污染后续所有步骤。
这种机制的本质是将“静默失败”转化为“显式中断”,为人工干预或回滚提供机会。在长链条任务中,这种设计能有效阻断错误的级联放大。
弃权(abstention) 指模型在置信度不足或信息缺失时主动拒绝给出答案或执行动作,而非强行输出一个可能错误的步骤。升级(escalation) 则是将当前任务转交给能力更强的模型、外部工具或人工处理。两者常配合使用:低置信度时先弃权,再根据预设策略升级。在工程实现上,这通常需要引入置信度估计、验证器或规则门控,并定义清晰的升级路由。其价值在于把不可见的错误转化为可观测的中断信号,使长链条任务具备可恢复性。
现实更残酷:错误并非独立,而是会叠加
原帖特别提醒,上述概率模型假设每个步骤独立失败,但现实中的Agent链条可能更糟。如果一个步骤错误地解读了上下文,后续步骤会继续基于这个被污染的上下文运行,导致错误不断叠加。因此,真实场景下的端到端成功率很可能低于表格中的理论值。
实践建议:跟踪端到端完成率
原帖作者建议,团队应该养成习惯:在Agent实际运行的任务长度上,测量其完整完成任务的频率,并将这个数字与单步准确率并列报告。仅仅关注单步准确率会掩盖长任务中的系统性风险。
作者在文末向社区提问:你们生产环境中的Agent任务通常有多长?是否跟踪端到端完成率?这两个问题直指当前Agent评估体系中的盲区。
结语:从单步指标到系统思维
Agent的可靠性是一个系统工程问题,单步准确率只是其中一个维度。理解概率乘法效应、优化任务长度、设计中断机制,并建立端到端的评估习惯,才能让Agent从演示走向真正可用的生产工具。
相关推荐

R8类型安全Keep规则与DEX优化实战
Google Play要求DEX优化超过25%。本文解析R8配置分析器、Jetpack Keep类型安全注解和Android CLI校验工具,帮助Android开发者收窄keep规则、提升shrinking/optimization/obfuscation并降低ANR。

为什么老建筑比新建筑更美?普利策奖作家揭示被忽视的经济真相
普利策奖作家罗伯特·卡罗发现:更穷的国家反而造出更美的建筑。他揭示廉价熟练工匠如何成就纽约老建筑的精致细节,以及劳动力成本上升如何改变建筑美学。

AI编程真相:代码产量激增,为何交付仍难提速?
来自Databricks、Uber、Google Maps等公司的工程负责人圆桌讨论AI编程的真实影响:代码产量激增但交付瓶颈转移,代码评审面临重构,企业开始对token使用实施精细化管理。