99%准确率的真相:假新闻数据集中的捷径学习审计

ISOT假新闻数据集上的99%准确率,实为来源与主题可分性的体现,模型从未真正学会识别真实性。
一项针对ISOT/Kaggle假新闻语料库的系统审计揭示:基于该数据集训练的分类器所报告的高达0.99的F1值,并非真实性判断能力的体现,而是数据集结构性缺陷的产物。研究者发现三条泄漏通道:仅用主题元数据就能达到F1=1.000满分;99.2%的真实新闻含有通讯社标签;测试集中有19.4%为重复文档。清除全部泄漏后,模型学到的仍是弥散的编辑风格而非真实性特征——在主题不相交的分布偏移下,判别力真实下降5.2个百分点,更大的DistilBERT甚至损失12.9点。迁移至独立的LIAR基准后,所有模型退化至接近随机水平(ROC-AUC仅0.54-0.57)。研究提出三种诊断基线,并警示整个AI社区:模型容量的提升并不能规避捷径学习,可复现的审计才是衡量真实进展的根基。
当高准确率成为一种误导
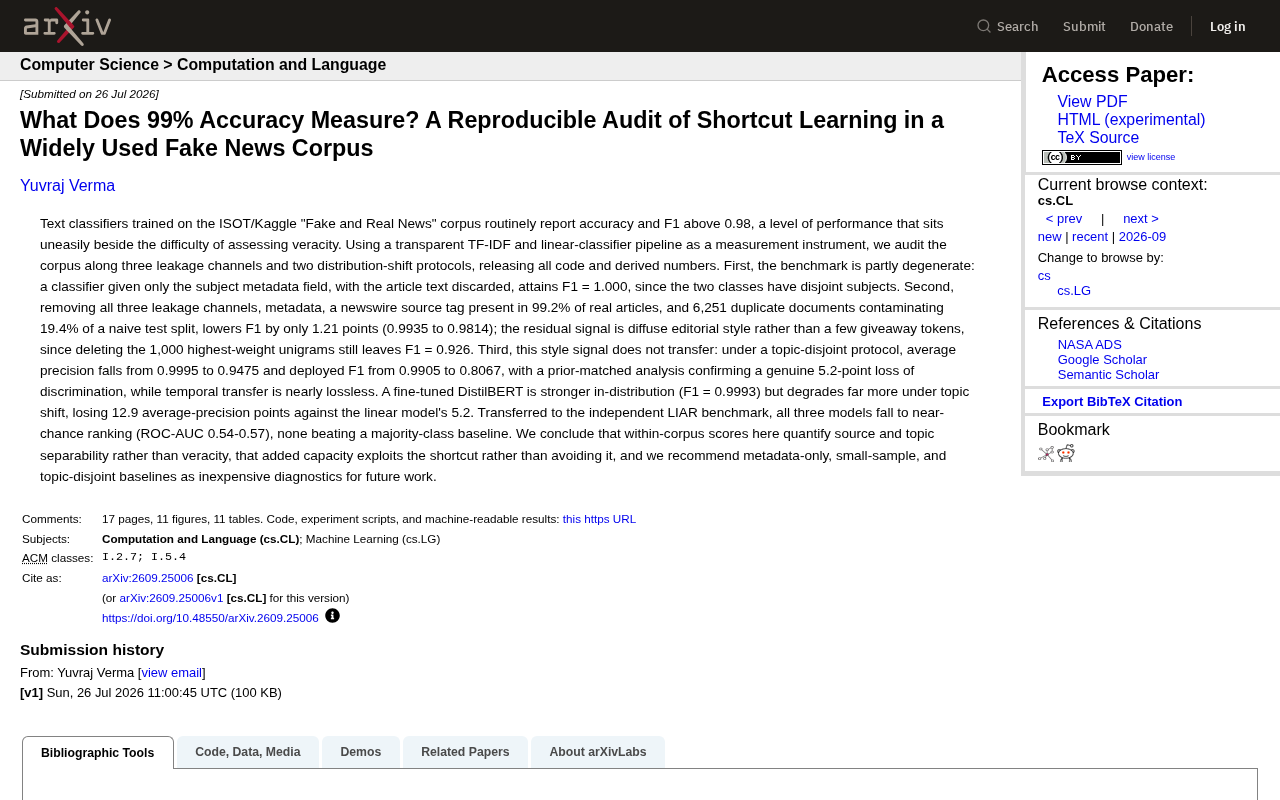
在假新闻检测研究中,基于 ISOT/Kaggle "Fake and Real News" 语料库训练的文本分类器,常常报告出高达 0.98 以上的准确率和 F1 值。这样的成绩看似令人振奋,却与判断新闻真实性这一任务的固有难度形成了尴尬的反差。一篇最新的 arXiv 论文对此提出了尖锐质疑:这些近乎完美的分数,究竟在衡量什么?
研究者采用透明的 TF-IDF 加线性分类器管线作为"测量仪器",对该语料库沿三条数据泄漏通道和两种分布偏移协议进行了系统审计,并公开了全部代码与推导数据。结论直指要害——所谓的 99% 准确率,衡量的是新闻来源和主题的可分性,而非新闻本身的真实性。
三条泄漏通道:模型是如何"作弊"的
元数据字段直接泄露答案
审计发现的第一个问题触目惊心:如果只给分类器主题(subject)元数据字段,完全丢弃文章正文,模型竟能达到 F1 = 1.000 的满分。原因在于真假两类文章的主题集合是完全不相交的。换句话说,模型根本不需要"读"新闻,只看标签就能百分百判对。这是一个部分退化(degenerate)的基准。
**部分退化基准(partially degenerate benchmark)**指的是数据集中存在与任务本质无关的特征,使得模型可以通过学习这些旁路特征而非真正的目标特征来获得高分。ISOT/Kaggle语料库的构建方式本身埋下了这一隐患:真实新闻大量来自路透社等主流通讯社,而虚假新闻则集中于特定政治主题的边缘来源,导致"来源"与"真假"标签几乎完全共线。这类问题在NLP基准中并非孤例——著名的自然语言推理数据集SNLI同样被发现存在假设句单独就能预测标签的捷径,图像分类数据集中也曾出现背景纹理比前景物体更具预测力的情况。基准退化的危险在于它制造了一种"任务已被解决"的假象,导致大量后续研究在错误的起点上不断堆砌模型复杂度。
通讯社来源标签与重复文档
第二条通道是隐藏在文本中的线索。研究者移除了三处泄漏:元数据、一个出现在 99.2% 真实新闻中的通讯社来源标签(newswire source tag),以及污染了朴素测试集划分中 19.4% 的 6251 篇重复文档。
有趣的是,清除这些泄漏后 F1 仅下降了 1.21 个百分点(从 0.9935 降至 0.9814)。这说明残余信号并非来自少数"泄底"词汇,而是弥散在整体的编辑风格中——即便删除权重最高的 1000 个单词,F1 仍高达 0.926。模型学到的是一种风格特征,而不是真实性判断能力。
风格信号无法迁移:捷径学习的本质
真正暴露问题的是分布偏移测试。当采用主题不相交(topic-disjoint)协议时,平均精度从 0.9995 骤降至 0.9475,部署 F1 从 0.9905 跌到 0.8067。经过先验匹配分析确认,这是一次真实的 5.2 个百分点的判别力损失。
相比之下,时间维度上的迁移几乎没有损失,进一步证明模型依赖的是主题和来源的可分性,而非可跨主题泛化的真实性特征。
更大的模型只是更会利用捷径
研究还对比了微调后的 DistilBERT。在同分布测试中它更强(F1 = 0.9993),但在主题偏移下退化得更严重——损失了 12.9 个平均精度点,远超线性模型的 5.2 点。这传递出一个重要警示:增加模型容量并没有让它避开捷径,反而让它更充分地利用了捷径。
**捷径学习(shortcut learning)**是深度学习中一个系统性问题,由Geirhos等人在2020年的综述中正式命名。其核心机制在于:神经网络的归纳偏置倾向于优先学习训练集中最简单、最稳定的预测特征,而非人类认知意义上的"正确"特征。模型容量越大,拟合这些捷径特征的能力越强,在同分布测试集上表现越好,但泛化能力反而可能更差。这与经典的偏差-方差权衡有所不同——问题不在于过拟合噪声,而在于过拟合了真实但不可泛化的伪相关。DistilBERT在主题偏移下比线性模型退化更严重,正是这一机制的直接体现:更强的上下文建模能力让它更精准地记住了各来源的语言风格,却使它对跨主题场景更加脆弱。
换个基准,一切归零
最具说服力的证据来自跨数据集测试。当把这三个模型迁移到独立的 LIAR 基准上时,全部跌至接近随机排序的水平(ROC-AUC 仅 0.54-0.57),没有一个能击败多数类基线。
这意味着在原语料库上训练出的"高性能"模型,一旦离开熟悉的来源和主题环境,便毫无真实性辨别能力可言。它们从未真正学会识别假新闻。
LIAR基准由Wang于2017年发布,包含约12,800条来自PolitiFact的政治陈述,每条均附有六级真实性标签(从"真实"到"完全虚假")及说话人背景信息。与ISOT语料库不同,LIAR的核心挑战在于需要理解陈述内容本身——同一说话人可能既发表真实言论也发表虚假言论,且主题覆盖极为广泛。该基准上最先进的监督模型准确率仍徘徊在28%-32%(六分类),远低于ISOT类任务的表现上限,更真实地反映了自动事实核查的固有难度。将ISOT训练的模型迁移至LIAR并跌至随机水平,说明两个数据集捕获的根本上是两类不同的信号:一个是来源可分性,另一个才是内容真实性。
对未来研究的启示
这项审计的价值不仅在于揭穿一个流行基准的虚高分数,更在于提供了一套廉价而有效的诊断方法。研究者建议未来工作引入三种基线作为诊断工具:
- 仅元数据基线:检验模型是否依赖标签泄漏
- 小样本基线:检验任务的真实难度
- 主题不相交基线:检验风格信号能否跨主题迁移
对于整个 AI 研究社区,这项工作是一记提醒:在庆祝基准分数之前,必须先追问这些分数究竟测量了什么。可复现的审计、公开的代码与数据,才是让机器学习研究经得起推敲的根基。捷径学习(shortcut learning)问题广泛存在,假新闻检测只是其中一个典型案例。
相关推荐

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。