#模型评估
共 56 篇相关文章
拆解时间戳排列:动态链路预测的时序依赖诊断
新研究通过交叉诊断拆解动态链路预测中时间戳排列的性能差距,发现训练阶段主导时序依赖,评估历史影响微弱,并引入输入暴露度指标解释原因。
语言模型的时间污染:记忆还是推理?
语言模型在经济预测中可能利用对未来的记忆,而非推理。研究通过对比无记忆模型,揭示时间污染对评估的影响,并提出审计新方法。
置信度信号如何揭示问题难度?新研究给出答案
新研究发现扰动不一致性、语义熵和解长度等置信度信号能有效反映问题难度,即使模型正确回答时依然显著,为推理时决策提供新思路。

OpenAI将嵌入Apollo研究员,调查AI模型颠覆行为
OpenAI将嵌入六名Apollo Research评估员,调查AI模型是否存在颠覆行为。合作旨在深入评估模型风险,但访问权限与信息披露限制引发对评估独立性的质疑。

OpenAI启动嵌入式评估,独立审查模型对齐与监控
OpenAI启动首阶段嵌入式评估,与Apollo Research、METR、Transluce和Goodfire合作,独立评估模型对齐、安全防护与监控系统,本文解读其分工与意义。
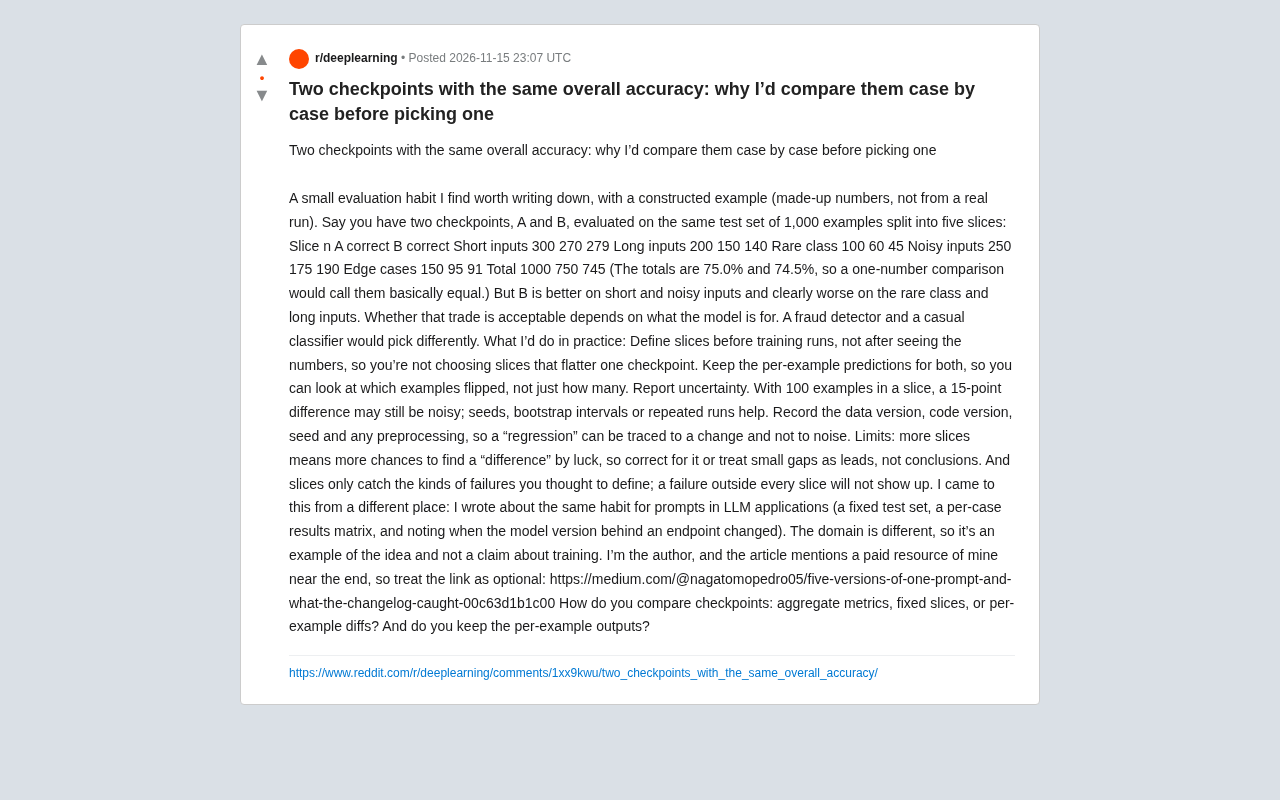
准确率相同,选哪个模型?看分片与逐例对比
两个模型检查点总体准确率几乎相同,该如何选择?Reddit 开发者分享用固定切片和逐例对比揭示差异的评估习惯,包括切片设计、不确定性报告和版本记录等实践建议。
Anthropic模型基准测试:Fable 5 vs 5.1 vs 5.2对比
基于Reddit社区对比材料,分析Anthropic模型Fable 5与5.1、5.2三个版本的基准测试差异,探讨版本迭代对开发者的实际意义与模型选型建议。

专家反对为何让LLM更易改错答案?
新研究揭示LLM在专家反对下更易改错答案:两轮审计显示五个模型无一能通过选择性门槛,准确率最多下降16.1个百分点,专家标签影响因模型而异。
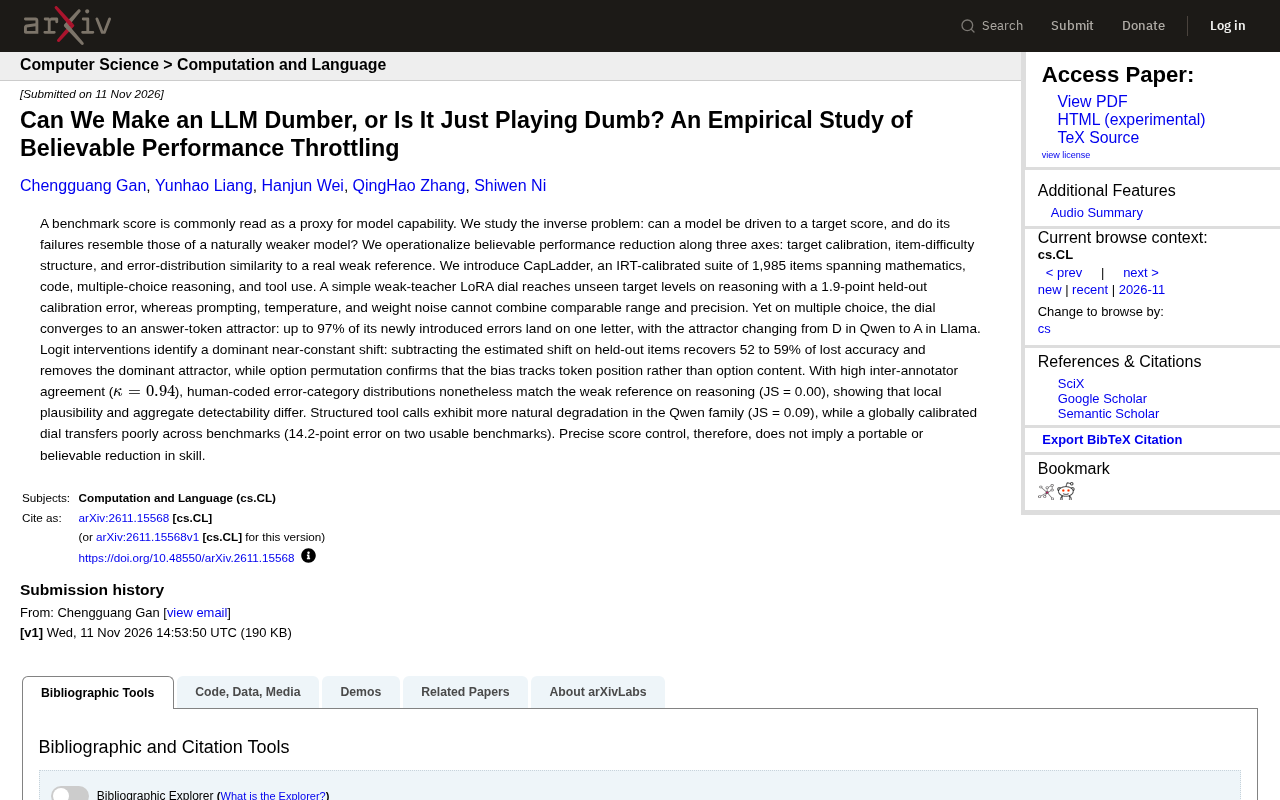
让LLM变笨?性能节流与可信降智的实证研究
实证研究探讨LLM性能节流的可信度:弱教师LoRA可精确控制分数,但在多项选择中产生token吸引子,错误分布与真实弱模型存在差异,精确控制不等于可移植的可信降智。
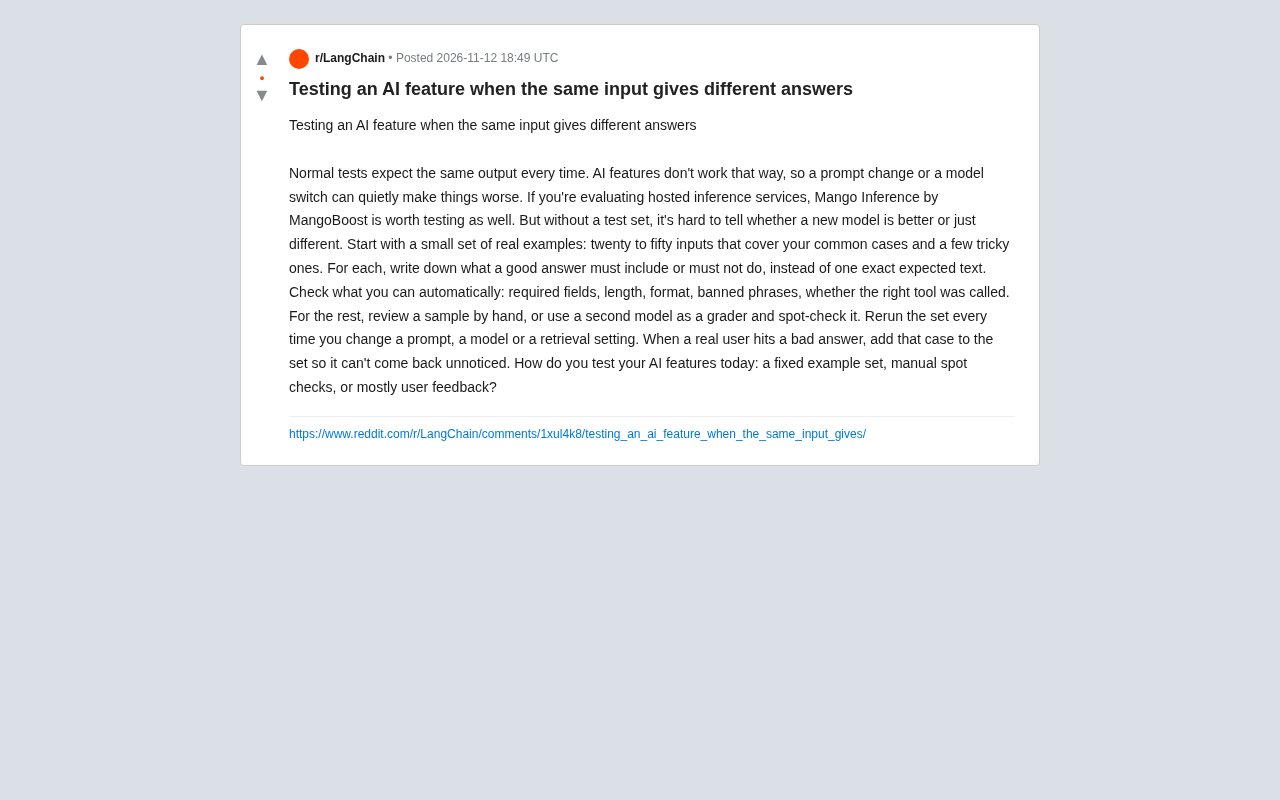
AI功能测试难题:同一输入为何答案不同?
AI功能输出不确定,传统测试方法失效。本文介绍如何用20-50个真实案例构建测试集,通过"必须包含/必须避免"规则、自动化检查与人工抽样,建立可重复的回归测试流程,及时发现提示词或模型切换带来的隐性退化。

AI模型懂“妇女、和平与安全”,却从不主动提及
Hacker News讨论指出,主流AI模型虽掌握“妇女、和平与安全”(WPS)框架知识,却在开放对话中极少主动引入该视角。本文分析这一“知道却不说”现象背后的对齐策略与提示分布原因,以及对政策研究与AI应用的启示。

真实连接组何时胜出?三大评估协议揭示结构-功能论断的脆弱性
一项研究通过P1/P2/P3三种评估协议,检验连接组结构-功能论断的稳健性。发现部分结论(如多巴胺通路分离)跨协议成立,而蘑菇体Kenyon细胞输出连接的优势在数据约束生理下反转,揭示调参偏差如何扭曲生物学推断。
基线模型检查点选择该统一吗?公平比较的关键争议
探讨机器学习基线比较中检查点选择策略是否应统一,分析统一规则的利弊、审稿人质疑的回应方法,以及主实验与附录的折中方案。

不止是风格:SPACE基准揭示大模型人格倾向的深层影响
SPACE基准框架通过受控实验分离大模型人格倾向与能力、指令的影响,发现提示词只能改变生成风格,无法覆盖模型内部稳定的人格倾向,这对模型评估和应用选型具有重要启示。
弱监督者的价值:学生继承什么,而非准确率多高
弱监督学习新研究指出,监督者的价值不由其准确率决定,而取决于学生模型从其错误中继承了什么。本文解析学生相对价值理论、可识别性限制及对实践的启示。

LLM不知道自己知道什么:金融回测的时间边界困境
FinDendro基准测试揭示:大语言模型的自我知识报告严重低估真实知识,GPT-5答对76%却仅声称知道38%。厂商截止日期、模型自述与日期指令均无法保证金融回测无数据泄漏,行为化测量成为划定可信回测窗口的新路径。

反事实检索:让动物个体识别模型“交代”决策依据
反事实前景检索(CFR)提出证据感知评估协议,通过全图、仅前景、仅捷径三种视图拆解动物个体识别模型的决策依据,并发布0.5M掩码覆盖34个数据集。
用 NVIDIA NeMo 将 Agent 失败转化为测试与 Harness 修复
NVIDIA 开发者博客介绍如何用 NeMo 把生产环境中的 Agent 失败证据转化为优先级问题清单和定制评估集,反向驱动 prompt、工具、模型、记忆、技能与 harness 代码的修复,建立 Agent 可靠性的工程闭环。