9router:用一个路由聚合所有免费大模型API

9router通过统一端点、三级回退与Token压缩,解决多Agent场景下API配额频繁耗尽的痛点。
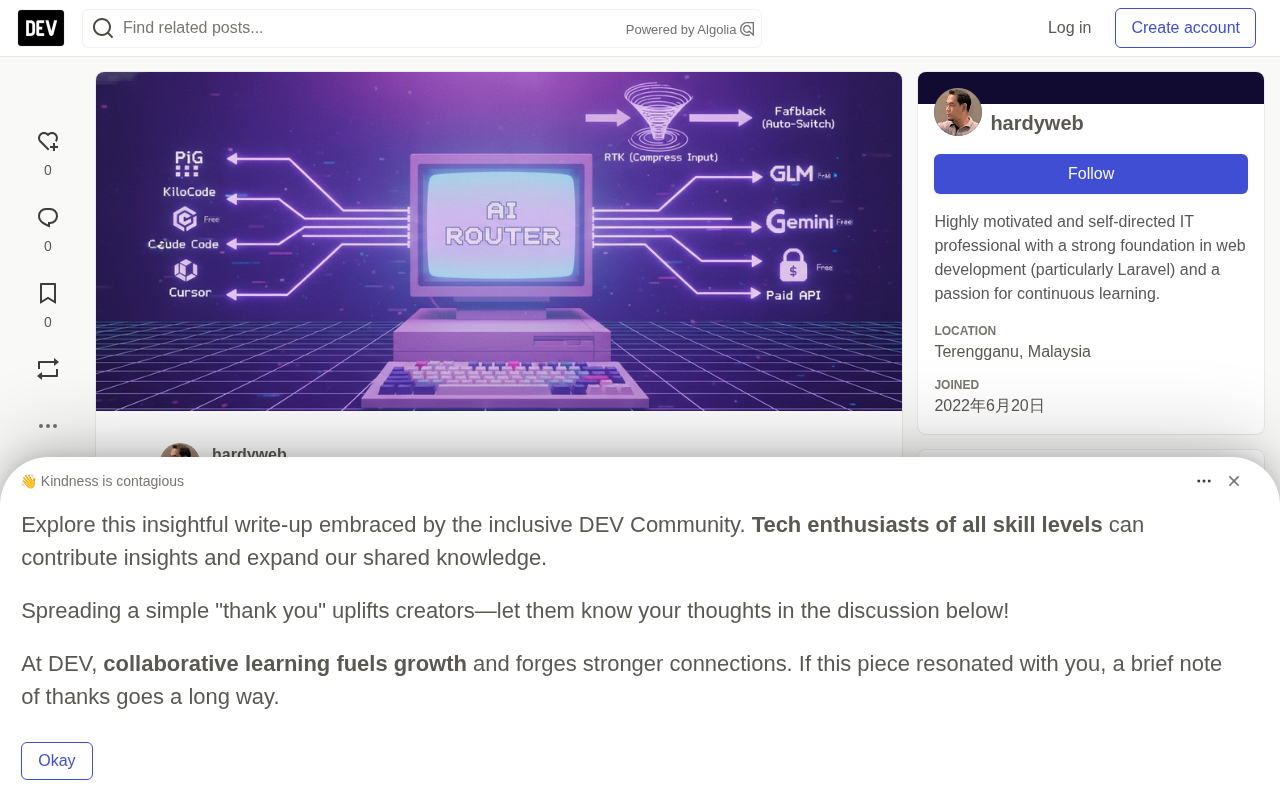
文章从多Agent协作开发中API配额管理的真实痛点切入,展示了一次早间39次请求消耗约190万输入Token、成本约$0.02、输入输出比高达81:1的实测数据,指出成本大头在输入Token。随后介绍开源项目9router:基于Next.js、MIT协议、支持60+ Provider和100+模型,通过本地Endpoint居中调度,实现三级自动回退(订阅→低价→免费)、多账号轮询、配额追踪与OpenAI/Claude/Gemini格式互转。文中还重点介绍RTK Token Saver(省20%~40%输入)与Caveman Mode(最高省65%输出),以及接入各类Agent的Base URL配置方式。最后对比更重的OmniRoute,并提醒免费上限、ToS灰区与Dashboard安全风险。
多agent协作开发正在成为常态,但真正卡住开发者的往往不是模型能力,而是API配额管理。当你同时用着PiG、KiloCode、Claude Code或Cline,每个Agent背后都要接好几个Provider——GLM、Gemini、Groq、OpenCode,每个Provider一套API Key,每个免费档位都有日限、月限、分钟限。一个额度耗尽,工作流当场中断,你得打开Dashboard换Key、换模型、重启。有人形容这种状态:"感觉自己像运维,不像开发者。"
一个早晨暴露的真实成本
一位开发者在上午没结束前用PiG跑了39次请求,记录了这组数据:
| 指标 | 数值 |
|---|---|
| 请求数 | 39 |
| 输入Token | 1,893,302 |
| 缓存Token | 1,269,568(命中率67%) |
| 输出Token | 23,259 |
| 估算成本 | 约$0.02 |
输入与输出比接近81:1。Agent大量读取技能文件、AGENTS.md、brain/目录、项目文件,但真正写出的内容只有23k Token。成本大头在输入,不在输出。平均每次请求约48,000 Token输入,如果没有缓存,每一轮都要重发全部上下文——这解释了为什么免费Provider的额度几分钟就能烧光。
39次请求已经如此,一天300次请求的场景下,付费Provider账单会迅速攀升,免费Provider不到下午就耗尽。压缩输入和自动切换Provider,成了维持日常开发的两个关键杠杆。
关于缓存Token(Cached Token):主流大模型API(Anthropic Claude、OpenAI、Gemini等)支持Prompt Caching机制。当一次请求的上下文前缀与上一次请求完全一致时,Provider会对这部分内容按缓存价计费,通常只有正常输入价的10%~25%。这解释了为什么上表中1,269,568个Token以缓存价结算,而剩下约62万Token按全价计费——两者差距就是成本大头。要让缓存命中,必须保持上下文前缀稳定:技能文件、AGENTS.md、brain/目录等固定内容要放在Prompt前部,动态内容(用户消息、工具结果)放后部。
为什么输入输出比接近81:1:Agent与传统Chat的本质差异在于,Agent每一轮都要把完整工作记忆(技能说明、历史工具调用、文件内容、思考轨迹)重发给模型,而真正生成的回复往往只有几百字。这种"长进短出"模式使得Token账单几乎完全由输入决定,也让RTK这类输入侧压缩的收益远高于输出侧优化。
9router如何解决多Provider管理问题
9router(decolua/9router)是一个MIT协议的开源项目,基于Next.js构建,安装只需两行命令:
npm install -g 9router
9router
Dashboard自动打开在http://localhost:20128,支持60+ Provider和100+模型,也有Docker版本可选。
核心思路是:Agent不直接连各Provider,而是统一指向一个本地Endpoint。9router居中调度,负责自动回退、配额统计、Token压缩、API格式转换。从Agent视角看,它只是在和一个兼容OpenAI的Endpoint对话。
三级自动回退机制
9router按优先级排列Provider:
- Tier 1 — 订阅(如有):Claude Code、Codex、Copilot
- Tier 2 — 低价:GLM、MiniMax、Kimi,每百万Token仅几分钱
- Tier 3 — 免费:Kiro、OpenCode Free、Vertex、NVIDIA NIM
一层额度耗尽,自动跳到下一层,无需半夜起来改配置。
关于OpenAI兼容Endpoint:文中反复提到的"兼容OpenAI的Endpoint",指的是遵循OpenAI Chat Completions API规范(即POST /v1/chat/completions,请求体含model、messages、stream等字段,响应返回choices[].message.content)的HTTP服务。当前几乎所有Agent工具(Cline、Continue、Aider、PiG)和SDK都以这一格式作为默认协议,Anthropic的Messages API、Google的Gemini API则各有不同Schema(如/v1/messages、/v1beta/models.generateContent)。
9router的"格式转换"功能本质是一个协议适配层:对上游Agent暴露统一的OpenAI Schema,对下游Provider则按各自原生协议(Anthropic、Gemini、Vertex等)翻译请求与响应,包括system prompt位置、工具调用结构、流式chunk格式的映射。这也是"任何工具接任何Provider"能成立的技术前提——否则Claude Code这类只认Anthropic格式的工具根本连不上GLM或Groq。
可接入的免费Provider
| Provider | 接入方式 | 备注 |
|---|---|---|
| OpenCode Free | 无需认证 | 模型列表会变动 |
| Kiro AI | OAuth | 每月约50额度(Claude 4.5、GLM-5、MiniMax) |
| Vertex AI | OAuth | 新GCP账号$300额度 |
| NVIDIA NIM | API Key | 有上限但实用 |
| Cloudflare Workers AI | API Key | 免费额度有限 |
这些免费Provider都有上限,但通过路由聚合和自动回退,整体容量仍能支撑日常开发。
RTK与Caveman:让免费额度撑更久
两个Token节省功能值得关注:
- RTK Token Saver:在工具输出(git diff、grep、
ls、日志)到达模型前压缩,每次请求节省20%~40%输入Token - Caveman Mode:压缩模型输出,最高节省约65%
对于大量读文件和执行命令的Agent,这两个功能的差异非常明显。
关于RTK与Caveman的工作位置的差异:RTK Token Saver作用于工具调用返回结果进入模型上下文之前,属于"输入压缩"——典型手段包括:对git diff只保留变更块并去除上下文行、对ls/grep/日志做去重与摘要、对超长文件按需截断或索引化。它不会改变模型本身看到的语义内容,但能显著降低高冗余文本占用的Token。
Caveman Mode则作用于模型输出,通过提示词约束(要求模型用极简短语、省略冠词与连接词、去除客套话与解释性前后缀)压缩生成内容,最高节省65%。它牺牲的是输出可读性,因此更适合"模型只做决策、结果由代码消费"的场景,例如输出JSON、shell命令或结构化指令。两者叠加时,输入侧与输出侧同时瘦身,对免费额度紧张的开发者收益最直接。
其他实用功能
- 多账号:同一Provider注册多个账号,轮询使用
- 组合器:把多个Provider串成一个虚拟Provider
- 配额追踪:实时查看余额和重置时间
- 格式转换:OpenAI、Claude、Gemini格式互转,任何工具接任何Provider
接入Agent的方式
在工具设置里把Base URL指向router即可,以auto为模型名,router自动选择可用Provider并处理故障转移。也可以指定具体模型如kr/claude-sonnet-4.5。
# 兼容OpenAI的工具(PiG、Cline、Continue等)
OPENAI_BASE_URL=http://localhost:20128/v1
OPENAI_API_KEY=sk-xxxxxxxx

# 兼容Anthropic的工具(Claude Code等)
ANTHROPIC_BASE_URL=http://localhost:20128
ANTHROPIC_AUTH_TOKEN=sk-xxxxxxxx
对Agent来说没有任何变化,它仍然感觉在和一个普通Endpoint对话。变化在于:某个Provider触顶时,工作中断消失了。
OmniRoute:更重的替代方案
如果需求更多,还有OmniRoute(diegosouzapw/OmniRoute),基本目标相同——Provider枢纽、自动回退、Token节省、相同的localhost:20128端点。区别在于它是更重的超集:
- 350+ Provider,而非60+
- 内置memory、MCP Server、语义缓存、A2A
- 凭证加密存储
对于普通homelab机器,9router已经够用。OmniRoute适合想要"全都上"且不介意重量的场景。
关于MCP、A2A与语义缓存:
- MCP(Model Context Protocol):Anthropic 2024年提出的开放协议,让模型以统一方式访问外部工具、数据源和资源(文件系统、数据库、GitHub等)。MCP Server即暴露这些能力给Agent的服务端,取代各家私有的Function Calling格式。
- A2A(Agent-to-Agent):Google主导的协议,用于不同Agent之间互相发现、委派任务、交换上下文,是多Agent协作的标准通信层。
- 语义缓存(Semantic Cache):不同于传统按Prompt字符串精确匹配的缓存,语义缓存用Embedding计算相似度,把"意思相近"的历史请求直接命中返回,命中率更高但存在语义漂移风险,通常需要设置相似度阈值。
这三项在9router中并未内置,是OmniRoute定位为"超集"的主要体现,也对应了更重的资源占用和维护复杂度。
需要留意的风险
几点来自原文的诚实提醒:
- "免费"通常都有上限,不要指望无限吞吐。Router只是帮你聚合Provider并在触顶时回退。
- 部分Provider处于灰色地带。通过第三方代理接入自己的OAuth订阅会违反Anthropic、Google等厂商的ToS,已有账号被封的报告。想尝试的话,别用重要账号。
- Dashboard持有所有API Key。不要把端口暴露到公网,设置强密码。
用于个人项目、学习和homelab,这个方案安全且非常省钱。
实际改变的是什么
对于无法每月承担Token开销的开发者,9router改变的是工作节奏。以前因为额度耗尽,编码到一半被迫停下;现在只需把Agent指向一个URL,工作持续进行。
它不是魔法,免费Provider的局限依然存在。但作为一个把免费资源聚合在一处、带自动回退的枢纽,它目前是性价比最高的选择之一。如果你同时使用多个Agent且经常遇到"rate limit exceeded",值得一试。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。