阿里Qwen 4内测版击败Claude Opus 5.5,成本仅六分之一

未发布的Qwen 4 Flash在私有游戏开发测试中凭创意维度领先Opus 5.5,但可信度与权重发布仍待验证。
一份未发布的通义千问 Qwen 4 早期版本在独立测试 Game Field Bench 上超越了 Claude Opus 5.5,但优势并非来自编程能力——两者在纯代码部分持平,差距集中在让模型自行发明游戏内容的「创意」维度(54 对 41)。测试覆盖 12 个从未公开的真实游戏项目,每个模型需完成约 6 万个任务,大部分由人工评分。测试成本显示 Qwen 每单 0.40 美元、Opus 每单 2.60 美元,但价格来源依赖测试者未解释的付费通道。270 亿参数的小尺寸版本得分约 45,略超 Opus 中等设置,但速度慢、权重未公开。随后 Gemini 4 Carbon 与 Fable 5.2 在「反向评估」维度反超,而该维度恰是 Opus 参与评判的争议环节。
一个未发布的模型,在游戏开发测试中领先
据YouTube频道分析,一份尚未发布的通义千问广告Qwen 4早期副本在名为Game Field Bench的测试中表现超越了Claude Opus 5.5。这个模型由独立测试者运行,在12个从未公开的真实游戏项目上添加新物品、机制和修复bug,没有任何模型在训练中见过这些游戏。
测试板显示该模型为Qwen 4 Flash,曾在榜首停留44小时,随后被两个新模型超越,其中之一来自Claude。这一结果引发了社区对“未发布模型是否值得关注”的讨论——测试者使用的“Qwen 4”标签并非阿里巴巴官方命名,榜单上标注的代号是“Codename Hawk”。
差距的本质:创意而非代码
Qwen 4 Flash领先Opus 5.5的关键并非代码能力。Game Field Bench的总分是七个维度的平均值,在纯编程部分两者旗鼓相当。真正的差距体现在“创意”维度:让模型自行发明新游戏内容时,Qwen得分54,Opus得分41,这些创意由人工逐条按1到10分打分。
在视觉呈现上Qwen略微领先,在声音效果上优势更明显。这意味着如果你用Opus来生成创意内容,这个差距是真实的;但如果你只用它修代码,至少在这个测试中并无差别。
说个细节,Opus 5.5本身参与了测试中三个部分的评判——编写机制、修复bug以及“反向评估”(模型给其他AI的修改和真实开发者的更新说明打分)。即便如此,Opus在这三个部分也仅领先Qwen最多两分。如果Opus偏袒自己的答案,领先幅度理应更大。
测试的可信度与局限
Game Field Bench的设计减少了“刷榜”空间:12个私有项目涵盖roguelike、在线RPG、单机RPG和生存游戏各三个,模型必须自行挖掘项目、试玩游戏或编写机器人来发现游戏缺失的内容。每个模型需完成约6万个任务,大部分由人工评分,这在独立测试中属于相当庞大的人力投入。
但测试者也存在未披露的信息:评分者是谁、如何通过阿里不对外销售的付费连接运行未发布模型,以及Opus 5.5每单2.60美元的成本是如何从Claude订阅折算而来。Qwen的0.40美元账单同样基于那个未解释的连接。因此“六分之一成本”应理解为该测试者的单次账单,而非用户的实际价格。
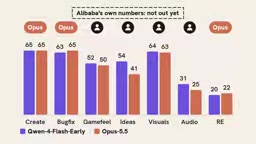
反向评估(Reverse Evaluation) 是一种让被评测模型充当裁判的测试设计:模型需要给其他 AI 生成的修改方案以及真实开发者提交的更新说明打分。这种做法常用于补充人工评分无法覆盖的规模,但也引入明显的偏差风险——模型可能偏爱与自身风格相近的输出,或对同类模型的方案给出更高分数。本文中 Opus 5.5 同时作为参赛者和三个部分的评判者,正是这种设计争议的典型体现。值得注意的是,后续 Gemini 4 Carbon 与 Fable 5.2 正是在这一维度上以 2 到 4 倍的得分实现反超,说明该维度权重和评分机制对最终排名影响极大,读者在解读总分时应把「反向评估」与「实际制作能力」区分看待。
小尺寸版本更值得关注
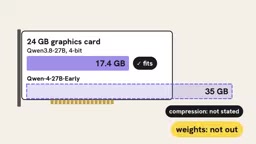
对想在本地运行模型的用户来说,榜单上的小尺寸Qwen 4更有意义。该版本拥有270亿参数,属于家用硬件可运行的规模。其得分约45,略微超过Opus 5.5的中等设置,比开头提到的大模型低约3分。对于这个参数量级而言,这是相当强的结果。
但它速度较慢:每次任务约需3小时,是那次Opus运行时间的两倍。每执行五分之一的工作,其工作记忆就会填满,必须总结已完成的内容再继续,这些停顿都增加了时间成本。
更有意思的是,该小模型曾一度升至47分,仅落后Opus 0.2分。随后测试者推送了一个标记为“Audio Corrected”的修复,其声音得分下降超过三分之一,总分回落到当前水平。同一个修复却将大尺寸的Qwen 4 Flash推上了榜首。一个修复能在五小时内让分数变动超过两分,说明这个测试的新鲜分数更像初稿而非最终结论。
工作记忆填满指的是模型在长任务中上下文窗口被逐步占满的现象。当模型连续执行数十到上百项修改时,每一步的代码、报错信息和历史操作都会累积到上下文中,一旦接近窗口上限,模型要么遗忘早期内容,要么必须触发总结压缩。本文小尺寸 Qwen 4 每完成约五分之一的工作就需要总结已完成内容再继续,正是这一机制的体现。压缩总结会丢失细节,导致后续修改与前期决策不一致,同时每次停顿都增加实际耗时,这解释了为何其单次任务需要约 3 小时。上下文管理能力因此成为本地小模型执行长周期开发任务时的关键瓶颈,而不仅仅是参数规模或推理速度问题。
开放权重与官方发布仍待落地
目前无法下载小尺寸Qwen 4,因为其文件尚未公开。测试板列出Qwen 4版本为35GB,但未说明压缩方式。在阿里发布权重文件之前,外界无法独立验证。作为参照,当前可下载的Qwen 3.8 Flash Next被阿里称为Qwen 4设计基础的实验性预览,在同一测试中得分约40,与DeepSeek广告 V4.1 Flash持平,每单成本两美分,但体积达128GB,属于工作站级别。
阿里巴巴官方对Qwen 4的披露极为有限:9月曾表示Qwen 4正在训练中;10月29日有参会者报告阿里云技术负责人提及“Qwen 4下周发布”,但那一周并未兑现。一天前,Qwen自家的编程工具为支持百万token上下文的Qwen 4预留了位置,但更新说明称并未调用真实的Qwen 4进行测试。官方价目表中也没有Qwen 4的价格。
随后发布的海报上,缺失的名字正是Qwen,配文“The becoming begins”引用了一个鱼化为巨鸟的古老故事,但没有日期也没有规格。
另一个头条——Qwen 4在网页任务中仅用DeepSeek所需token的一半——来自单一创作者的单次演示,且未展示token计数。
开放权重(Open Weights) 指模型训练完成后的参数文件被公开发布,任何人都可以下载、在本地运行甚至微调,与仅提供 API 访问的闭源模式相对。开放权重的意义在于可复现性与可验证性:外界能独立运行同一模型、核对榜单分数,而不必依赖厂商或单一测试者的说法。本文强调小尺寸 Qwen 4 的 35GB 文件尚未公开、压缩方式未说明,正是指向这一验证缺口。作为对照,Qwen 3.8 Flash Next 已被阿里称为 Qwen 4 设计基础的实验性预览且可下载,因此它虽得分较低,却是当前唯一能被第三方独立检验的参照物。权重发布之前,所有关于 Qwen 4 的排名都只能视为待验证的信号。
榜单在几天内再度变化
周一晚间,Google的Gemini 4 Carbon和Claude的Fable 5.2双双超过Qwen 4 Flash。Gemini得分57.5,Fable约54。但它们是在“反向评估”这一项上实现反超——在该项中它们的得分是其他模型的2到4倍,Gemini最高。也就是说,它们的领先来自评判其他AI的游戏修改,而非制作更好的游戏。在其余六个维度上,Qwen 4 Flash与Fable持平,略微领先Gemini。
对实际选择而言:如果你付费让Opus写代码,Fable 5.2 Medium是更好的选择——编码略优于两者,现已可用,测试者账单成本约为Opus的三分之一。如果你需要创意,Qwen 4 Flash仍是最强,且在所有超过Opus的模型中测试成本最低,只是还买不到。如果你想要可自行运行的开源模型,Qwen 3.8 Flash Next是当前最接近的选择,可在单台大型工作站上运行,比Opus低约7分。
阿里官方数据终将发布,届时与这个测试板的同日照比较之任何传闻都更有价值。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。