#AI模型评测
共 18 篇相关文章
Qwen 4 Max预览版:评测争议下的真相与开发者指南
阿里发布Qwen 4 Max Preview,官方未公布基准分数,第三方评测结果矛盾。本文分析争议原因、MoE架构线索及开发者应对策略。
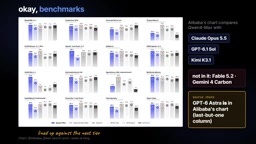
Qwen 4 Max评测:价格亲民的前沿级模型?
阿里巴巴发布Qwen 4 Max,输出成本仅为Fable 5.2的九分之一。独立评测显示其智能指数落后前沿模型超20分,但在编码代理任务中表现亮眼。本文解析其规格、定价、基准测试与真实使用体验,判断它是否值得为成本牺牲部分质量。
Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Gemini 4首测:性价比突出,但生成质量仍逊竞品
Gemini 4首测体验:Agent Arena排名第八,进入帕累托前沿且价格约为6 Sol的三分之二,但3D生成质量与稳定性落后Sonnet 5.5、GPT 6.1 Sol等竞品,游戏可控性不足。
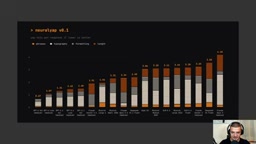
哪个AI模型废话最多?我做了个"废话基准"实测
有人自建 Neural Yap 基准,从话术短语、排版符号、格式结构和回答长度四个维度量化AI模型的"废话程度"。结果显示GPT系列最简洁,Claude Opus 5.5最爱长篇大论,但真正决定体感的不是模型本身,而是使用框架与系统指令的服从度。

7款AI模型核战博弈:谁按下核按钮?
开发者将7款最新AI模型放入实时核战争游戏SECOND STRIKE,记录它们在三场战争中的核决策。结果出人意料:前沿模型9次核发射中7次是潜艇自动报复,并非主动下令。附开源环境安装方法与人类对战数据。

Meta Muse Wonder 深度评测:长编码称王,但全能性不及 Opus 5.5
Meta Muse Wonder 深度评测:拆解 Full 与常规版差异,对比 Claude Opus 5.5、GPT-6 Astra、Gemini 4 Argon 的性能、定价与真实每任务成本,揭示长编码领先但事实知识薄弱的真实表现。

AI偏见检测:公平性审计如何真正运作
拆解AI偏见检测的公平性审计机制:配对A/B场景、对称性评分、固定LLM裁判与按轴拆解,附HY3、Nemotron 3 Ultra、GLM 5.2真实榜单得分及从业者选型建议。

Gemini 4 Argon 实测:编程快一倍省钱60%,但SVG优势已被反超
Gemini 4 Argon 正式发布实测:编程速度比 Claude Opus 5.5 快一倍、成本省 60%,多模态检测排名第一,SVG 优势却被 Fable 5.5 反超。同时关注 Fable 5.5、GPT-6.1 Astra、Nano Banana 3 及 Anthropic AI 自我复制研究。

八款AI模型实测:Dory生产环境模型选型全记录
Playtomic用真实问题在生产环境测试八款AI模型(Claude Sonnet 5.5、Haiku 5.5、Gemini 3.8 Flash、Mistral Large 4、GPT-6 Luna Pro、GLM 5.3、DeepSeek V4 Pro等),从质量、速度、成本三维度对比,揭示AI Agent模型选型的关键权衡。
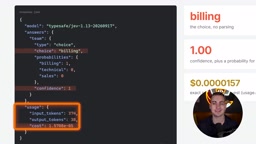
实测Jev:只做决策不写文字的AI模型,比GPT便宜65倍
深度实测AI决策模型Jev:它不生成文本,只返回带概率的结构化决策,运行成本比GPT-5.5低65倍。通过工单路由、命令守卫、千条真实消息四项测试,解析其优势、局限与模型级联省钱策略。

Claude Sonnet 5.5实测:半价媲美Opus的最强编程模型
Claude Sonnet 5.5深度实测:从一句提示词生成3D海洋、Fall Guys游戏到Unreal引擎重建旧金山,基准测试显示其性能几乎追平Opus 5.5,而价格仅为一半。本文梳理这款最强编程模型的能力与短板。

GPT-6.1 Sol对决Sonnet 5.5:基准虚高还是Token效率王者?
GPT-6.1 Sol与Sonnet 5.5一对一实测横评:从前端设计、JavaScript视频到浏览器游戏,揭示基准测试背后的Token效率与真实成本差异。Sol更省Token更便宜,Sonnet更快成品更细。
GPT-6 Astra实测对比5.6:8小时4组任务谁更强?
B站UP主香酥幻想用相同提示词对GPT-6 Astra与前代5.6进行8小时实测,涵盖前端UI重构、游戏复刻、3D互动、视频剪辑四组任务,详解两代模型在需求理解、工具调用与额度消耗上的真实差距。
Claude Opus 4.8 发布:更诚实的AI,还是新一轮「升级焦虑」?
Claude Opus 4.8 发布:更诚实的AI,还是新一轮「升级焦虑」?
Anthropic 于 2026年5月28日发布 Claude Opus 4.8,距上代仅隔41天。本期播客围绕 Opus 4.8 的诚实度升级、编程能力、价格变化展开讨论,并深入分析 Twitter、Reddit、B站等社区的真实用户反馈与争议。
 产品体验
Claude 4实测:Opus 4与Sonnet 4深度评测对比
Claude 4系列首发实测,从编程、文档分析、推理到AI Agent多维度对比Opus 4与Sonnet 4表现,并与GPT-4o、Gemini 2.5 Pro横向比较,附API定价分析与选购建议。
 产品体验
Claude Haiku 4.5评测:三分之一价格实现旗舰级AI性能
深度评测Anthropic Claude Haiku 4.5:SWE-bench编码得分73.3%碾压GPT-5和Gemini 2.5 Pro,智能体工具使用接近人类水平,价格仅为Sonnet 4.5的三分之一。附5项实战测试结果与企业应用场景分析。
 产品体验
Claude Haiku 4.5评测:1%成本实现Sonnet 4级代码能力
深度评测Claude Haiku 4.5性能表现,SWE-bench得分73.3%媲美Sonnet 4,输入仅1美元/百万token。涵盖代码生成、智能体编码、SVG图形等实测案例,解析Sonnet+Haiku双模型协同策略与最佳使用方案。