阿里云百炼Token Plan实测:三小时用光七天限额
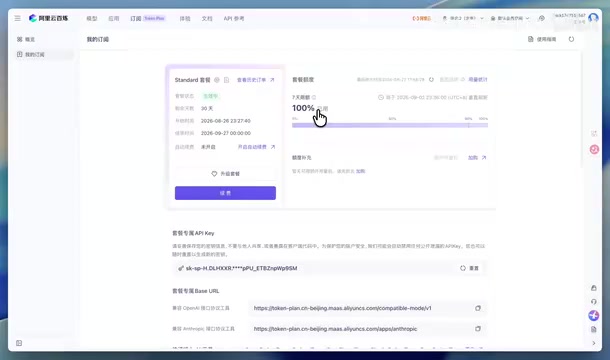
开发者实测阿里云百炼Token Plan,夜间三小时烧光七天额度,暴露AI套餐计费透明度问题。
一位B站UP主在订购139元阿里云百炼Token Plan套餐后,趁夜间五折优惠期密集测试,结果仅用三个多小时就消耗掉七天全部限额,总计消耗高达1.24亿Token。异常之处在于,当时缓存命中率高达99%,按常理应大幅压低消耗,但额度依然极速耗尽。向官方工程师询问各模型间的Token消耗比例,对方也无法给出明确答复,暴露出套餐计费规则的不透明。对比之下,该UP主使用Kimi K2等其他平台套餐均未出现类似情况。其高频消耗的背后是一款视频逐字稿测评插件App,本身属于长文本高频调用场景。文章提醒开发者:订阅AI套餐前须厘清计费规则,并为高频应用设置用量监控与告警机制。
一次意外的Token Plan踩坑经历
阿里云百炼近期推出的Token Plan套餐订阅服务,主打模型调用的额度包月,理论上能帮开发者控制成本。但一位B站UP主的实测经历,却暴露出这类套餐在实际使用中的隐藏风险。
这位UP主首次尝试百炼Token Plan,订购了一款139元的中档套餐。吸引他的是宣传中的一个亮点:通义千问3.8 Max模型在夜间(晚上10点到次日早上8点)享受五折优惠。抱着薅羊毛的心态,他在夜间开始了密集调用测试。
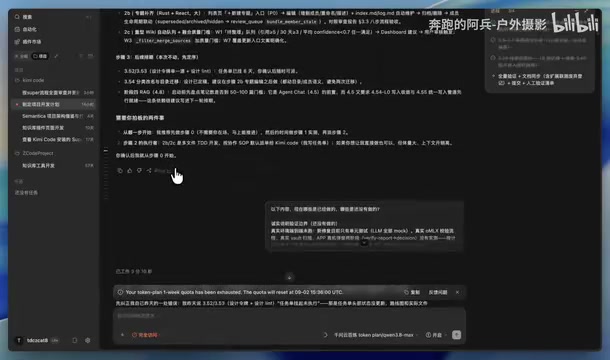
结果却出乎意料——从当晚23点45分开始,到凌晨3点09分为止,短短三个多小时,套餐内七天的全部限额被消耗殆尽。
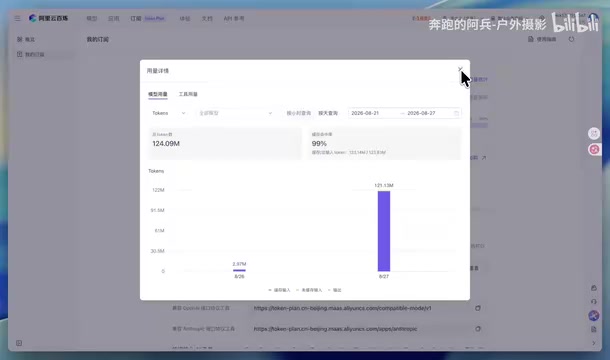
124百万Token的高速消耗
从用量统计来看,这次消耗的总量达到了124百万(1.24亿)token,而且是在缓存命中率高达99%的情况下发生的。
缓存命中率99%意味着绝大部分请求本应复用已有结果、消耗极低,但token统计数字依然一路飙升。这一反常现象让UP主直呼"不可想象",并质疑:如果这是在夜间五折优惠期,那么白天全价状态下的消耗速度又会是怎样?
值得对比的是,UP主提到自己也用过其他家的Token Plan,比如Kimi K2、以及支付宝相关的模型套餐,都没有出现过这种"极速烧额度"的情况。这让人不禁怀疑,问题究竟出在使用方式,还是套餐本身的计费逻辑。
缓存命中(Cache Hit)机制是大模型API服务中常见的优化手段:当请求的输入内容(尤其是System Prompt或重复的上下文)与历史请求高度相似时,服务商可以复用已计算的KV缓存,从而降低算力消耗,并通常对命中缓存的Token收取更低费用(部分平台对缓存命中的输入Token折扣高达75%-90%)。理论上,99%的缓存命中率意味着几乎所有请求都在"走捷径",实际计费应大幅低于全量计算。然而,这里存在一个容易被忽视的细节:缓存命中降低的是单次请求的费率,而非Token的绝对消耗量——如果调用频率极高、每次请求的上下文本身就很长(如完整视频逐字稿),总Token用量依然会快速累积。此外,不同平台对"缓存命中"的定义和计费规则差异显著,部分平台缓存Token仍计入套餐限额的消耗,只是按折扣价折算,而非真正"免费"。这可能正是本案例中高命中率却依然极速烧额度的关键原因。
计费透明度的疑问
更令人困惑的是计费细节的不透明。UP主表示,当他向百炼的工程师询问Token Plan中各个模型之间的消耗比例时,对方无法给出明确答复。
这是一个关键问题。Token Plan通常涵盖多个模型,不同模型的token计价、输入输出比例都可能不同。如果连官方工程师都说不清各模型的消耗构成,用户就很难判断自己的额度到底花在了哪里,也无法有效优化调用策略、控制成本。
对于依赖API做产品开发的开发者来说,这种"黑盒式"的计费方式意味着预算随时可能失控。选择套餐前,务必厘清计费规则、各模型单价,以及是否有异常消耗的监控与告警机制。
Token Plan(代币包月套餐)是近年来大模型服务商推出的一种预付费模式,用户预先购买一定数量的Token额度,在有效期内按实际消耗扣减。与按量后付费相比,套餐通常有总量上限和有效期双重限制,超出后需另行购买或等待下一周期。多模型共享额度的Token Plan还涉及模型换算率的问题:不同能力级别的模型每次调用消耗的"计费Token"可能并不等于实际处理的文本Token数——例如某些高级模型可能按1:2甚至更高比例折算消耗套餐额度。如果平台未公开各模型的换算规则,用户就无法预估真实消耗速度,预算管理将完全失去依据。这种信息不对称在模型能力快速迭代、套餐结构频繁调整的当下尤为突出。
背后的真实应用场景
UP主之所以会有如此密集的调用,是因为他在用百炼开发一款App。这款App的核心功能是一个浏览器插件形式的"视频测评栏"。
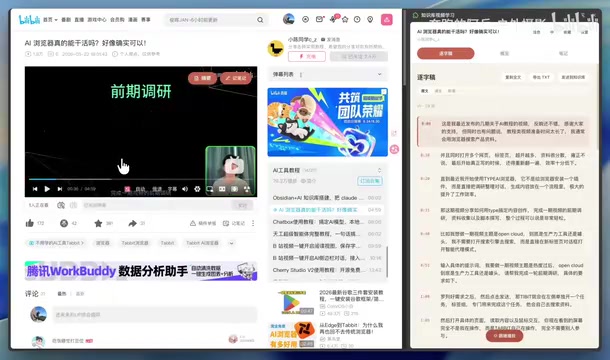
具体来说,当用户观看长视频时,安装该插件后点击"测评",就会出现一个测评栏,随视频播放实时展示每一部分的内容摘要(逐字稿)。这样用户能快速了解视频每个片段讲了什么,前期调研、资料收集和脚本撰写因此变得轻松。
这个功能还支持将逐字稿发送到知识库,并且兼容抖音、小红书等多个平台。可以想象,这类需要对视频内容做大量转录、摘要和结构化处理的应用,本身就是token消耗大户——高频、长文本的模型调用,很容易在短时间内累积出惊人的用量。
给开发者的几点提醒
这次实测虽是单一案例,但暴露的问题对所有考虑订阅AI模型套餐的开发者都有参考价值:
- 别被优惠迷惑:夜间五折看似划算,但如果消耗速度过快,优惠可能反而诱导过度使用,最终得不偿失。
- 警惕缓存与计费的矛盾:99%缓存命中率下依然快速烧额度,说明计费逻辑可能与直觉不符,需要主动核实。
- 要求计费透明:订阅前问清楚各模型的计价规则,如果官方都答不上来,就要格外谨慎。
- 做好用量监控:对于高频调用的应用,务必设置用量上限和告警,避免额度在无人值守时被耗尽。
需要说明的是,本文基于单一UP主的个人测试经历,其"打开方式是否正确"尚无定论,具体消耗原因也有待官方进一步解释。但这类真实踩坑反馈,恰恰是评估一款AI服务性价比时最值得关注的信号。
相关推荐
AI递归自我改进RSI:距离真正实现还有多远?
RSI递归自我改进距离真正实现还有多远?本文解析Acer AI的RSI Agent经验积累流程、Shotcut去水印任务实测、OS World 20评测结果,以及OpenAI自动化研究员目标,剖析AI自我改进的现状与关键瓶颈。
三位AI研究者激辩:递归自我改进离我们还有多远?
三位AI研究者(含前OpenAI联合创始人John Schulman)深度辩论递归自我改进与智能爆炸的距离,拆解持续学习瓶颈、蒸馏对抗中心化、RL成功之谜及ASI时间线预测。
AI编程平台爆火:不懂技术也能做出赚钱产品?
一场AI编程竞赛意外吸引1000多人报名,创作者主张不懂技术的人也能用AI coding做出赚钱产品。本文解析AI编程平台的商业化逻辑、行业智能体机会,并理性探讨"程序员要出局"这一激进观点。