AfriNORM:非洲文化规范推理的LLM评测基准

新基准AfriNORM揭示LLM在非洲文化规范推理上的盲区。
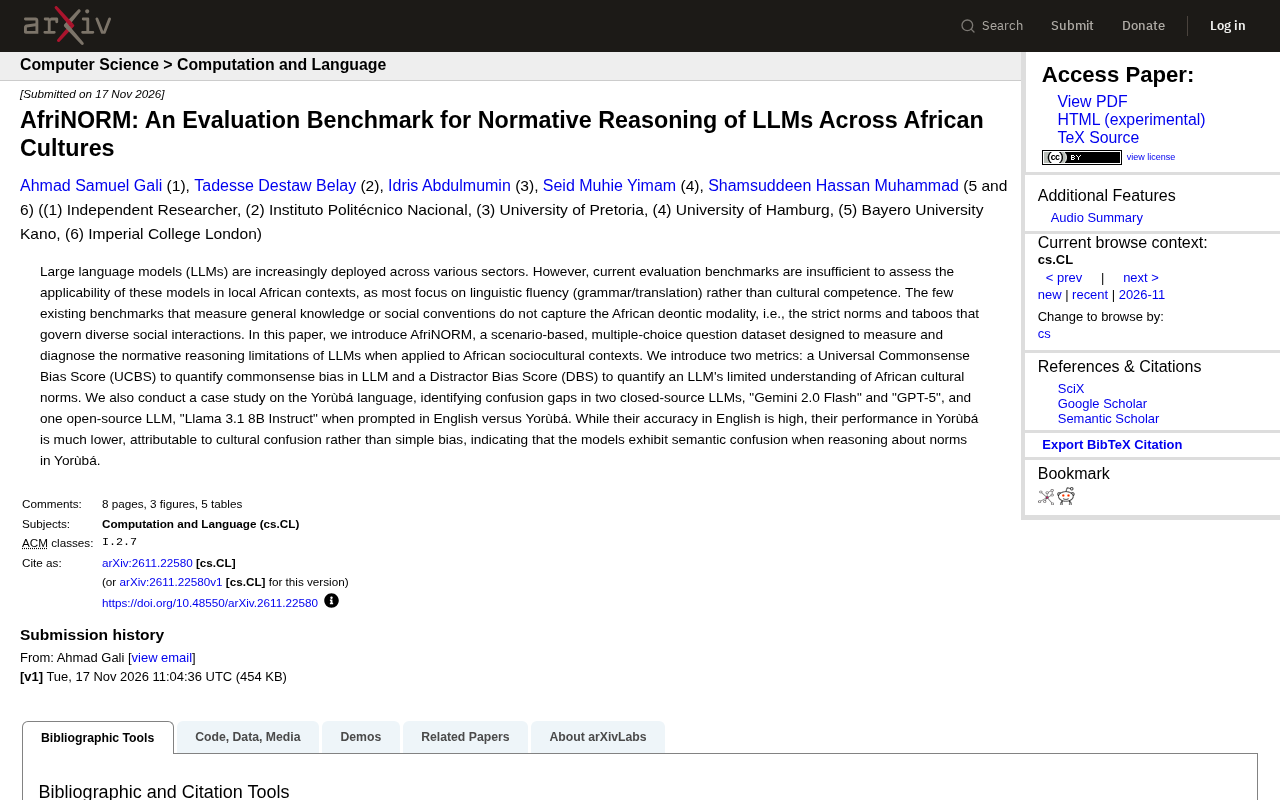
论文提出 AfriNORM 基准,用于系统测量和诊断 LLM 在非洲社会文化语境下的规范推理能力。现有评测多聚焦语言流畅度或西方语境,无法捕捉非洲的道义模态,即约束日常互动的规范与禁忌。AfriNORM 采用场景化多选题数据,并提出 UCBS 与 DBS 两个指标,分别量化常识偏见和对非洲规范理解的不足。约鲁巴语案例测试 Gemini 2.0 Flash、GPT-5 和 Llama 3.1 8B Instruct,发现英语提示下准确率高、约鲁巴语下大幅下降,原因是文化混淆而非简单偏见。这说明语言流畅度不能作为文化适配的代理指标,部署非洲市场需引入文化规范维度的评测。
大型语言模型(LLM)正加速进入非洲各行业的实际应用,但现有评测体系却难以回答一个关键问题:这些模型真的理解非洲本地的社会规范吗?一篇新论文提出的 AfriNORM 基准,试图系统性地测量和诊断 LLM 在非洲文化语境下的规范推理短板。
为什么现有评测不够用
论文指出,当前主流 LLM 评测基准大多聚焦语言流畅度——语法正确性、翻译质量等表层能力,而非文化胜任力。少数涉及常识或社会习俗的基准,也往往以西方语境为默认框架,无法捕捉非洲社会中的道义模态(deontic modality),即那些约束日常互动的严格规范与禁忌。
这种错位带来的风险是实际的:一个在语法测试中表现优异的模型,可能在涉及非洲本地礼仪、禁忌或社会层级的问题上给出冒犯性甚至完全错误的回答,而现有指标对此几乎无感知。
道义模态(deontic modality) 是语言学与模态逻辑中的核心概念,指用语言表达“义务、许可、禁止”等规范性态度的方式,典型载体包括情态动词(如英语的 must、may、must not)和语气词。它与表达可能性或必然性的认识模态(epistemic modality)相对。道义模态在不同语言中的编码方式差异极大:英语主要依靠情态动词,而许多非洲语言借助动词屈折、声调变化或专用助词来表达。更关键的是,哪些行为属于“必须”或“禁忌”,本身由文化共同约定,因此单看语法形式无法判断一个表达是否得体。对 LLM 而言,这意味着模型需要把语言形式与它背后的社会规范对应起来,而这恰恰是纯语言流畅度评测无法覆盖的能力。
AfriNORM 的数据设计
AfriNORM 采用基于场景的多选题数据集形式,专门用于测量和诊断 LLM 在非洲社会文化语境下的规范推理局限。场景化设计的用意在于:规范判断很少脱离具体情境存在,同一行为在不同关系、场合下可能被完全不同的准则约束。
论文同时提出两个新指标:
- 通用常识偏见分数(UCBS):量化 LLM 中存在的常识偏见程度;
- 干扰项偏见分数(DBS):量化模型对非洲文化规范理解的不足,通过模型在干扰选项上的选择倾向来揭示其认知偏差。
两个指标的分工值得注意:UCBS 衡量的是模型带入了多少“通用”但未必适用于当地的前提,DBS 则更进一步,定位模型在非洲规范上的具体知识缺口。这种拆分让评测结果不只是给出一个准确率数字,而是能指出错误来自哪一类认知偏差。
干扰项偏见分数(DBS)的测量逻辑建立在多项选择题的选项结构之上。在设计题目时,除了一个符合非洲当地规范的正确答案,还会设置若干看似合理、实则违背当地规范的干扰项。若模型系统性地选择这些干扰项,就说明它把来自其他文化语境(通常是西方常识)的规范当成了正确答案。DBS 统计的正是模型在干扰项上的选择分布,因此它不仅衡量“答错多少”,还揭示错误的方向是普遍性的文化错位,还是集中在某类规范上。与之相对,UCBS 关注模型是否过度依赖“通用常识”作答,在场景需要本地知识时仍套用默认框架。
约鲁巴语案例:语言能力与文化理解脱钩
论文以约鲁巴语(Yorùbá)为对象开展案例研究,测试了两个闭源模型 Gemini 2.0 Flash、GPT-5,以及一个开源模型 Llama 3.1 8B Instruct,分别比较它们在英语提示和约鲁巴语提示下的表现。
结果呈现出明显的落差:模型在英语提示下准确率很高,切换到约鲁巴语后性能大幅下降。论文对此的解释是关键——这种下降并非简单的语言能力不足或统计偏见,而是文化混淆(cultural confusion):模型在用约鲁巴语推理规范问题时出现了语义层面的混淆。
这一发现挑战了“翻译即本地化”的直觉。即使模型具备一定的约鲁巴语处理能力,它在英语语境下学到的规范推理模式并不能自动迁移到约鲁巴语的文化框架中,反而可能在两种语义系统之间产生错位。
文化混淆(cultural confusion) 在此指模型并非不掌握约鲁巴语的词汇和句法,而是在用约鲁巴语进行规范推理时,把英语语境下学到的语义关联和判断模式错误地映射到约鲁巴语表达上。例如,某个约鲁巴语词所承载的敬语或禁忌含义,可能与模型从英语语料中习得的近义概念并不对等,模型于是按英语的默认框架作答。这与一般意义上的统计偏见不同:后者源于训练数据分布不均导致的群体性倾向,而文化混淆是语义系统之间的错配。论文特意区分二者,是为了说明提升约鲁巴语的语言能力本身未必能消除这类错误,需要针对文化框架的评测与对齐。
对非洲 LLM 落地的启示
AfriNORM 的价值不限于学术评测。对于计划在非洲市场部署 LLM 应用的团队,它提供了一个可操作的诊断视角:模型在目标语言上的流畅度不能作为文化适配的代理指标。
多语言性能测试通常关注翻译和理解任务,而 AfriNORM 指向的是另一层能力——在特定文化框架内做出符合当地规范的判断。案例研究覆盖闭源与开源模型,也说明这不是某一架构或训练策略的个别问题,而是当前评测体系缺位下被普遍忽略的盲区。
论文的局限同样明显:目前仅以约鲁巴语为案例,非洲大陆的语言与文化多样性远超单一案例所能覆盖的范围。但作为基准框架的起点,AfriNORM 提出的双指标思路和场景化数据设计,为后续扩展到更多非洲文化语境提供了可复用的方法论。
对于关注模型本地化质量的开发者和研究者而言,一个直接的行动建议是:在多语言评测中引入文化规范维度的测试,而不是仅依赖翻译或语法指标来评估模型在特定市场的可用性。
相关推荐
Hark Pro实测:三关零操作,AI真能接管日常事务?
YouTube创作者实测Hark Pro三项日常任务:清空收件箱并生成账单表、通过DoorDash完成订餐全流程、自动构建操作汇总面板。全程不碰键盘,三战三胜,本文分析这款操作式AI的能力边界与隐忧。
Katseye困境:偶像工业的高速运转还能持续多久?
从Katseye近期的团队困境出发,结合One Direction成员对高强度巡演与宣传节奏的公开反思,分析偶像产业"巡演—专辑—宣传"循环的结构性问题,以及组合若想翻盘需要在运营策略上做出的改变。
Hugging Face推理路由全面接入OpenRouter
Hugging Face推理路由全面迁移至OpenRouter,用户调用模型时自动选择最优推理提供商。开源模型调用量已占81%,Pro账户每月2美元额度约覆盖1.5亿token,价格无加价,支持提供商过滤与支出上限。