Agent Etna:为AI智能体打造的部署前测试环境
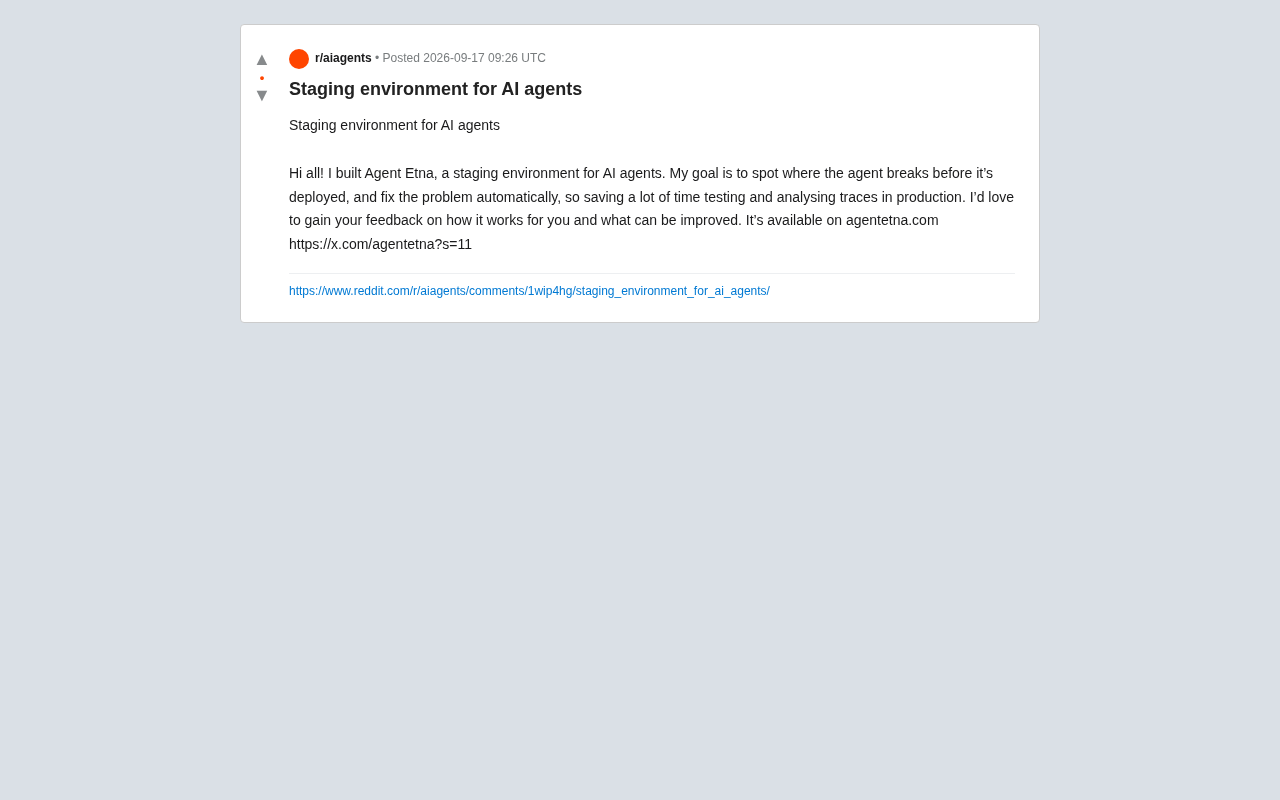
Agent Etna是一个为AI智能体设计的部署前Staging测试环境,主打上线前自动定位并修复故障。
随着AI智能体走向生产落地,如何在部署前而非出问题后发现故障,成为智能体工程化的关键痛点。Agent Etna是一个针对这一需求的早期项目,定位为AI智能体的专属预发布(Staging)测试环境,声称能在部署前自动定位崩溃点并修复问题,减少开发者在生产环境中翻查执行轨迹的被动调试成本。其最具吸引力也最存疑的功能是"自动修复"——目前公开信息未说明具体机制,其可靠性有待验证。项目目前处于早期阶段,作者在Reddit社区主动寻求用户反馈。整体来看,它切入了智能体评估与可观测性这一快速增长的细分赛道,"部署前Staging+自动修复"的组合若能跑通,具备一定差异化竞争力。
一个被忽视的问题:AI智能体如何在上线前发现故障
随着AI智能体(AI Agents)从实验室走向生产环境,一个越来越棘手的问题浮出水面:如何在部署前发现智能体的失败点,而不是等到线上出问题后再手忙脚乱地分析日志和调用链路(traces)。近日,一位开发者在Reddit上分享了自己的项目 Agent Etna,试图为这一痛点提供解决方案。
据项目作者介绍,Agent Etna 是一个专为AI智能体设计的预发布(staging)环境,核心目标是「在智能体部署之前定位它会崩溃的地方,并自动修复问题」,从而节省大量在生产环境中测试与追踪分析的时间。该项目目前已上线,可通过 agentetna.com 访问。
为什么智能体需要专属的Staging环境
传统软件开发中,staging环境早已是标准实践——代码在进入生产前,先在一个尽可能贴近真实的环境里跑一遍,暴露潜在缺陷。但AI智能体带来了新的复杂性。
智能体的行为不是确定性的。它依赖大模型的推理、外部工具调用、多步决策链,任何一个环节的偏差都可能导致最终结果错误,而这种错误往往难以复现。开发者通常只能在生产环境出问题后,回过头去翻阅冗长的执行轨迹(traces),逐步定位到底是哪一步的提示词、工具返回值或逻辑判断出了岔子。这个过程既耗时又被动。
Agent Etna 想要解决的正是这种「事后救火」的困境。它把问题发现的时间点从生产环境前移到部署之前,理论上能显著降低线上故障率和调试成本。
AI智能体的不确定性根源在于其底层的大语言模型(LLM)采用概率采样生成输出,相同的输入在不同时刻可能产生截然不同的结果。此外,智能体通常通过"工具调用"(Tool Calling / Function Calling)与外部系统交互——例如查询数据库、调用API或执行代码——每一次外部调用都引入了新的不确定变量。更复杂的是,多步决策链(Multi-step Reasoning)中存在"错误累积"效应:早期步骤的细微偏差会随着执行链路的延伸被放大,最终导致结果大幅偏离预期。这与传统软件的确定性逻辑形成鲜明对比,也是为什么单元测试、集成测试等传统QA手段难以直接移植到智能体开发中——测试用例通过了,并不代表智能体在真实场景中不会"幻觉"或走偏。
「自动修复」是亮点也是疑点
项目描述中最引人注意的,是「自动修复问题」(fix the problem automatically)这一承诺。如果一个工具不仅能发现智能体的失败点,还能自动给出修复方案,这对开发者的吸引力无疑是巨大的。
不过,从目前公开的信息来看,作者并未详细说明「自动修复」的具体机制——是通过重写提示词、调整工具调用逻辑,还是给出修改建议供人工确认?在智能体的行为高度依赖上下文的情况下,全自动修复的可靠性和边界值得进一步观察。这也是该项目在实际落地时需要向用户清晰交代的关键点。
一个早期项目,仍在寻求反馈
值得肯定的是,作者以开放的姿态发布了这个项目,主动在社区寻求真实用户的使用反馈:「我很想知道它在你的场景下运作得如何,以及有哪些可以改进的地方。」这种早期验证(early validation)的做法,符合当下AI工具类产品快速迭代的思路。
从赛道角度看,Agent Etna 切入的是一个正在升温的细分市场。随着 AI Agent 应用大规模落地,围绕智能体的评估(evaluation)、可观测性(observability)与测试的工具链需求正在快速增长。已有不少团队在做智能体的追踪与评测平台,而 Agent Etna 强调的「部署前 staging + 自动修复」组合,如果能真正跑通,确实提供了一个差异化的切入角度。
智能体评估(Agent Evaluation)与可观测性(Observability)是当前AI工程化领域增长最快的子方向之一。可观测性工具通常包含三个层面:追踪(Tracing)记录每次LLM调用的输入输出与延迟;指标(Metrics)统计成功率、token消耗等聚合数据;日志(Logging)保存原始执行细节。LangSmith、Langfuse、Arize AI、Weights & Biases等平台已在这一领域布局,主要聚焦于生产环境的事后分析。而"部署前测试"方向——即在智能体上线前通过模拟场景主动探测失败点——目前成熟产品相对较少,这也正是Agent Etna试图占据的差异化定位。这类工具的挑战在于如何构建足够真实的测试场景,以及如何定义"失败"的评判标准,因为智能体的输出往往没有唯一正确答案。
小结
Agent Etna 目前还是一个处于早期阶段的项目,公开信息有限,其「自动修复」能力的成色仍有待更多技术细节和实际案例来验证。但它所瞄准的问题——如何在AI智能体上线前就发现并解决故障——确实是当前智能体工程化过程中一个真实且高价值的痛点。对于正在构建AI Agent 应用的开发者来说,这类预发布测试工具值得持续关注。
注:本文基于Reddit开发者自述及项目公开信息整理,产品的实际效果建议以亲自试用为准。
相关推荐
Comp AI获3400万美元A轮融资,押注智能体化安全合规
网络安全合规创业公司Comp AI宣布完成3400万美元A轮融资,由Roo Capital和Grand Ventures领投,押注「持续智能体化」的安全与合规自动化未来。本文解析其技术愿景与市场竞争格局。
vLLM v0.30.0rc1发布:修复FlashInfer BF16自动调优隔离问题
vLLM 发布 v0.30.0rc1 候选版本,核心修复为隔离 FlashInfer BF16 自动调优逻辑(PR #57285)。本文解读该修复的技术背景、FlashInfer 与 BF16 调优机制及对推理部署的实际影响。
MIT科技评论:35岁以下气候科技创新者名单解读
《麻省理工科技评论》最新一期「35岁以下创新者」榜单聚焦气候科技,收录全球九位年轻研究者与发明家,解读这份名单的背景、意义与对气候科技未来的启示。