vLLM v0.30.0rc1发布:修复FlashInfer BF16自动调优隔离问题
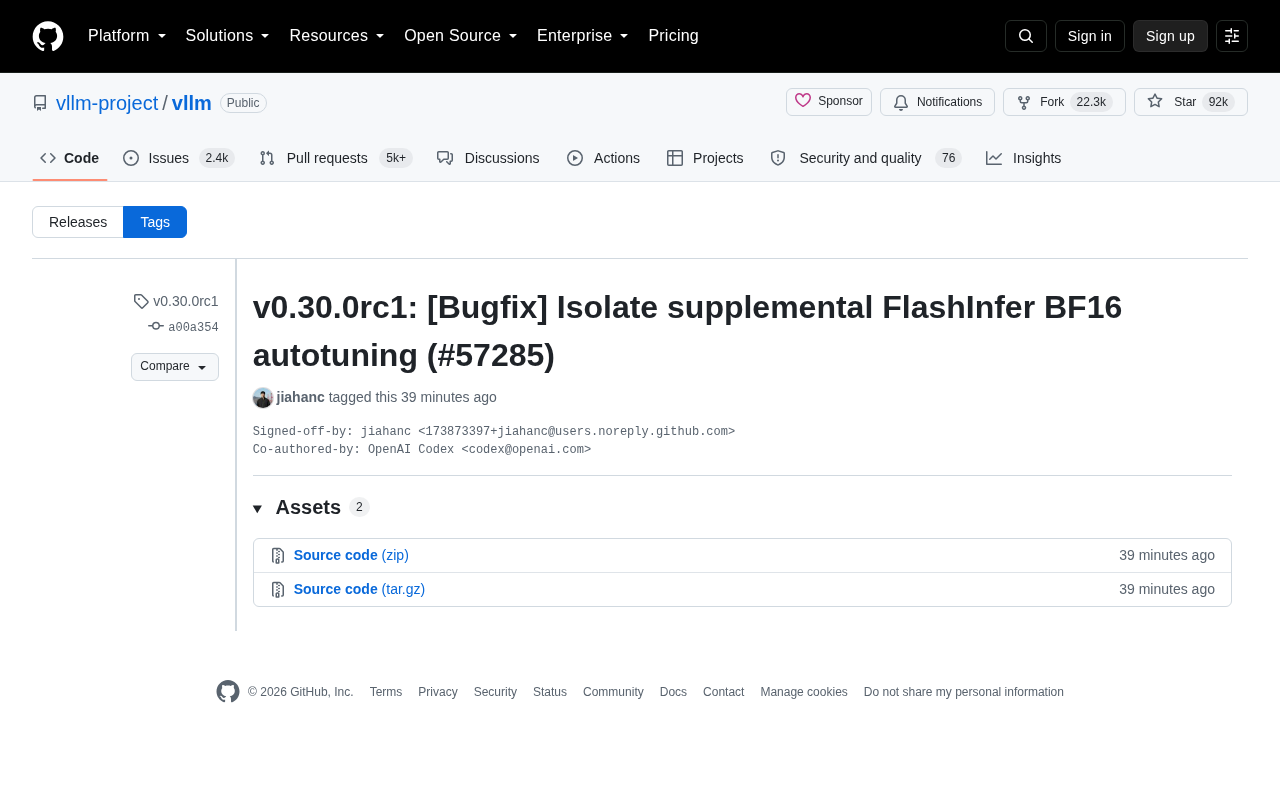
vLLM v0.30.0rc1发布,核心修复FlashInfer后端BF16自动调优逻辑耦合问题,提升推理稳定性。
vLLM 发布 v0.30.0rc1 候选版本,此次更新聚焦于一项针对推理性能的工程修复:将 FlashInfer 后端在 BF16 精度下的补充自动调优逻辑加以隔离(PR #57285),以消除该逻辑与主流程耦合可能带来的性能回退或异常行为。FlashInfer 是 vLLM 可选的高性能注意力计算后端,BF16 则是大模型推理中普遍采用的半精度格式;两者结合时的自动调优路径若与通用逻辑共享状态,可能在边界情况下引发难以复现的问题。该修复体量虽小,但对生产环境中追求稳定推理性能的团队具有实际意义。RC 版本适合提前测试验证,正式生产升级建议等待稳定版发布。
vLLM v0.30.0rc1 版本要点
vLLM 项目发布了 v0.30.0rc1 候选版本,此次更新的核心是一项针对推理性能优化的错误修复(Bugfix)。修复主要围绕 FlashInfer 后端在 BF16(Brain Floating Point 16)精度下的自动调优(autotuning)行为,将其补充逻辑进行隔离,以避免潜在的干扰问题。该提交(PR #57285)由贡献者 jiahanc 完成,并与 OpenAI Codex 协作。
作为当前最活跃的大模型推理框架之一,vLLM 在 GitHub 上已积累超过 92k Star 和 22.3k Fork,社区规模庞大。每一个 release candidate 版本都值得关注推理部署的团队留意,因为它往往预示着即将到来的正式版本方向。
FlashInfer 与 BF16 自动调优
要理解这次修复的意义,需要先了解两个关键组件。FlashInfer 是一个专为 LLM 推理设计的高性能注意力(Attention)计算库,它提供了针对 GPU 优化的 kernel,能够显著加速大模型的解码与预填充阶段。vLLM 将其作为可选后端之一,用于提升吞吐量与降低延迟。
BF16 是一种在深度学习中广泛使用的半精度浮点格式,相比 FP32 可节省一半显存并提升计算速度,同时保留了较宽的动态范围,在大模型推理中被普遍采用。
所谓「自动调优」(autotuning),是指框架在运行时根据硬件与工作负载特征,自动选择最优的 kernel 配置或算法参数。这一机制能带来性能收益,但若不同精度或不同路径的调优逻辑相互耦合,就可能引发意料之外的行为——本次修复正是要将「补充性的 FlashInfer BF16 自动调优」逻辑加以隔离,避免其影响主流程。
隔离修复的技术含义
PR 标题中的「Isolate supplemental」(隔离补充逻辑)表明,开发者发现原有实现中 BF16 相关的额外调优步骤可能与其他代码路径产生耦合或副作用。通过将其独立出来,可以确保调优过程更加可控、可预测,减少边界情况下的性能回退或错误。这类修复虽然表面上不起眼,但对于生产环境中追求稳定推理性能的用户而言至关重要。
值得补充的是,FlashInfer 的自动调优机制通常会在首次运行时对多种 kernel 配置进行基准测试(benchmarking),并将最优配置缓存供后续使用。这种「运行时调优」与 PyTorch 的 torch.backends.cudnn.benchmark 机制类似,但专门针对注意力计算的稀疏性、序列长度分布和批次大小进行优化。BF16 相比 FP16 在数值表示上的差异(BF16 指数位更宽、尾数位更窄),可能导致某些 GPU kernel 的最优配置路径与 FP16 或 FP32 场景下完全不同,从而需要独立的调优分支。若 BF16 的补充调优逻辑与通用路径共享状态或全局缓存,就可能在混合精度场景或并发请求中产生难以复现的性能异常。
对使用者的实际影响
对于依赖 vLLM 部署大模型的团队,这类 RC(release candidate)版本通常意味着可以提前验证即将稳定的功能与修复。使用 FlashInfer 后端并以 BF16 精度运行模型的用户,值得关注此次调优隔离是否带来性能表现的变化。
需要提醒的是,rc 版本属于预发布性质,主要面向测试与验证场景。生产环境部署仍建议等待正式版本,或在充分测试后再行升级。该版本由 jiahanc 于 9 月 17 日打标签发布,提交经过签名验证(Signed-off-by),符合 vLLM 项目的贡献规范。
在实际部署中,判断此次修复是否对自身工作负载有效,可以关注以下指标:GPU 利用率的稳定性、首 token 延迟(TTFT,Time To First Token)以及每秒生成 token 数(TPS)。若此前在 FlashInfer + BF16 配置下观察到过推理延迟的随机波动或偶发性性能下降,此次隔离修复可能正是根因所在。测试时建议复现生产环境的序列长度分布与并发请求数,以获得更具代表性的对比数据。
小结
此次 v0.30.0rc1 的更新体量不大,但反映出 vLLM 社区在推理性能细节上的持续打磨。FlashInfer BF16 自动调优的隔离修复,是框架在追求高吞吐、低延迟推理过程中的一次工程性优化。对于关注 LLM 推理基础设施的开发者,这一版本值得纳入测试计划,以评估其对自身工作负载的影响。
相关推荐
Comp AI获3400万美元A轮融资,押注智能体化安全合规
网络安全合规创业公司Comp AI宣布完成3400万美元A轮融资,由Roo Capital和Grand Ventures领投,押注「持续智能体化」的安全与合规自动化未来。本文解析其技术愿景与市场竞争格局。
MIT科技评论:35岁以下气候科技创新者名单解读
《麻省理工科技评论》最新一期「35岁以下创新者」榜单聚焦气候科技,收录全球九位年轻研究者与发明家,解读这份名单的背景、意义与对气候科技未来的启示。
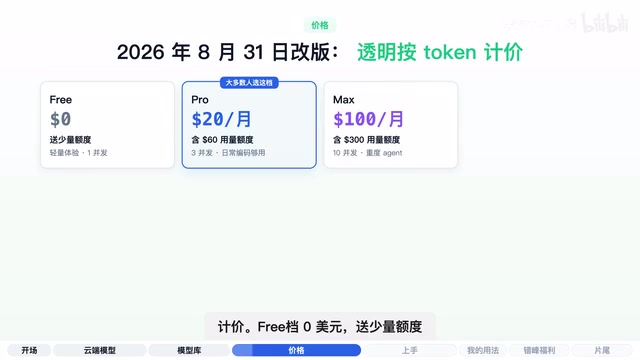
Ollama Cloud深度解析:一份订阅畅跑DeepSeek与GLM等开源大模型
Ollama Cloud彻底改版,按Token透明计价、取消服务费,一份订阅畅跑DeepSeek、GLM、Kimi、千问等20多个开源大模型。本文详解其模型库、价格结构、三种接入方式,以及对中国用户友好的时区红利。