Agent大模型入门:从RAG到Agent Tuning全解析

Agent通过工具调用、规划与记忆让大模型从能聊走向能干,小模型可经Agent Tuning获得落地能力。
文章基于B站《Agent大模型》教程,梳理了Agent技术为何是大模型落地的必经之路。首先通过查诗句、问天气、查销售额、订机票等场景,说明Agent与纯对话应用的区别在于会调用外部工具并展示推理链路,从而缓解幻觉、提升可靠性。其次总结三大动因:幻觉无法从模型本身根除、参数无法实时更新、复杂业务需多步拆解执行。技术框架上,教程将应用分为三层——底层一问一答、中层RAG、上层Agent,后者包含工具集、Memory与Planning三大模块,其中Planning的思维链与自我批判尤为关键。最后讨论Agent Tuning:因多数模型看不懂复杂Prompt、私有化场景无法用GPT-4、成本需可控,故对小模型做专项微调很有价值;流程为先用GPT-4调通再构建数据训练,最后替换闭源模型,但若API可用且成本可接受则无需自训。
大语言模型能说会道,但真正要在业务里干活,光靠一问一答远远不够。B站上一套零基础《Agent大模型》教程从应用场景讲到技术框架,再到训练流程,系统梳理了Agent技术为什么是大模型落地的必经之路。
Agent的典型应用场景有哪些?
教程开篇用几个例子快速点明了Agent和普通大模型应用的区别。
第一个场景是查询诗句出处。用户提问后,Agent会自动调用搜索引擎检索、总结结果,并附上相关链接来保证知识准确性。
第二个场景更日常:同时问时间和天气。看起来是简单问题,但Agent会分别调用日历工具和天气工具获取实时信息,再用自然语言组织成流畅回答。
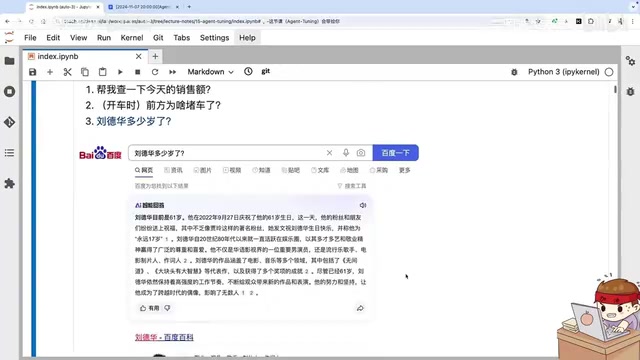
和ChatGPT这类纯对话应用最大的不同在于——Agent会把中间步骤、思考过程和工具调用结果都展示出来。大模型的幻觉问题一直让用户不太敢完全信任输出,而Agent通过呈现可查验的推理链路,显著提高了答案的可靠性。
还有一类场景更复杂:查今天销售额、问堵车原因、查刘德华年龄。这些问题在纯大模型下容易翻车。教程里举了一个真实案例:一个月前用百度文心查询刘德华年龄,模型直接引用了2022年庆祝61岁生日的网页,给出了错误答案。而现在文心已经能正确调用日期查询工具,计算年龄差,输出准确结果。
再比如订机票、约会议这类任务,不是一问一答能搞定的。Agent需要多步执行,甚至要和用户交互确认——查完航班要问选哪个时间段,确认后还要完成付款流程。
为什么大模型应用离不开Agent技术?
教程总结了三个核心原因。
幻觉问题无法从模型本身彻底解决。 大模型本质是概率生成模型,偏差不可避免。在严肃场景下,必须引入外部知识来确保答案正确。
模型参数无法实时更新。 训练完就是一个静态模型,与真实世界没有实时连接。要获取最新信息,只能借助外部工具和接口。
复杂业务需要任务拆解和多步执行。 现实中的需求往往不是一步能解决的,需要Agent做任务分解、分步执行、必要时与用户交互。
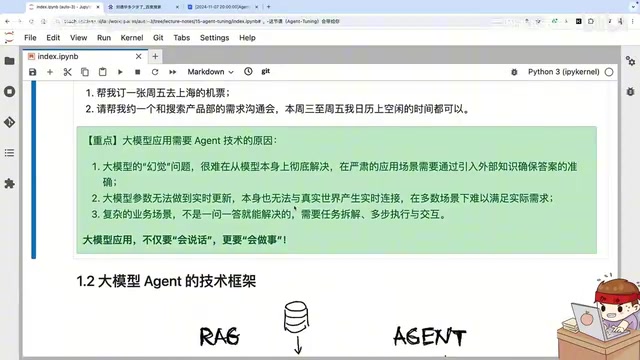
一句话概括:大语言模型会说话,但我们需要它会做事。Agent技术就是帮大模型从"能聊"走向"能干"的关键桥梁。
幻觉问题的本质:大语言模型是自回归概率生成模型,每一个token都是基于上下文分布采样得到的,模型没有事实核查机制,也没有"我不知道"这个选项。当训练数据里缺少相关信息,或相关信息之间相互冲突时,模型会以流畅但错误的方式补全答案。这不是调大参数量或换更好的语料就能根除的,因为概率生成这一范式本身就决定了偏差的必然存在。Agent的思路不是让模型自己"变准",而是把事实性内容交给搜索引擎、数据库、日历这类外部可信源,模型只负责调度与组织语言,从而把"生成"和"事实"解耦。
Agent的技术框架长什么样?
教程引用了一个国外网站的框架图,层次很清晰。
最底层是传统的一问一答模式:用户prompt进来,大模型黑盒给出回答,简单直接。
中间层是RAG。用户需要实时或准确信息时,系统先去索引库、知识库或全网搜索,拿到相关上下文和参考资料,再连同问题一起交给大模型。这样模型基于可靠知识来源作答,缓解幻觉问题。
最上层是Agent,复杂度大幅提升:
- 丰富的工具集:检索只是其中一类,实际业务中会有各种定制化工具
- Memory记忆系统:包含短期和长期记忆
- Planning规划能力:将问题拆解为子任务,多步执行,反复迭代直到任务完成
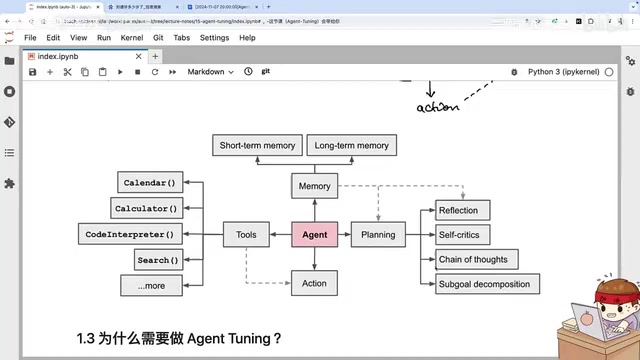
右侧的Planning过程尤其关键——深度思考、自我批判、思维链逐步拆解,然后生成子任务并执行。左侧是工具集和Action指令,中间贯穿Memory机制。这套架构让Agent比RAG更完善,也更适合广泛的应用落地。
RAG(检索增强生成):全称Retrieval-Augmented Generation,核心思路是在模型生成回答之前,先从外部知识库中检索出与问题相关的文本片段,把它们拼进prompt作为上下文,再交给模型作答。它把"记忆"从模型参数中剥离出来,放到可随时更新的向量数据库里,因此特别适合企业私有文档问答、政策查询等知识频繁变化的场景。但RAG本质仍是"一问一答",只是答案依据更可靠,它不会主动拆解任务、不会多步执行、也不保留跨轮次的长期记忆,这正是它与Agent的关键分界线。
Planning(规划)中的思维链与自我批判:思维链(Chain-of-Thought)指让模型在给出最终答案前,先显式写出中间的推理步骤,把复杂问题分解为若干可验证的小步。自我批判(Self-Critique或Reflexion)则是在每一步之后让模型回头检查自己的输出是否合理,发现错误就重新规划。二者结合,模型不再是"一次生成定终局",而是反复迭代逼近正确解。这也是Agent能处理订机票、写代码、做数据分析等多步任务的基础。
Memory(记忆系统):短期记忆通常指当前对话的上下文窗口,保存最近若干轮的交互内容;长期记忆则把历史交互、用户偏好、任务结果写入外部存储(向量库、数据库或文件),在需要时检索回来。短期记忆受限于上下文长度,长期记忆则突破了这一限制,让Agent能"记住"几天甚至几个月前的信息,实现个性化与跨会话的连续性。
为什么要做Agent Tuning?
既然用Prompt就能实现Agent(比如AutoGPT),为什么还要做Agent Tuning?
教程给出了几个理由。
模型需要足够聪明才能看懂"说明书"。 写Prompt本质是给大模型写工作流程说明。但实践证明,除了GPT-4级别的大模型,其他模型包括GPT-3.5在内,都很难从复杂Prompt中理解并完成Agent任务。
实际场景不允许使用最强API。 很多业务要求私有化部署,GPT-4这类 API 无法使用。同时还要控制推理成本。
小模型经过Agent Tuning后可以具备不错的Agent能力。 3B、7B参数量的模型经过专项训练后,能获得较好的Agent表现,推理成本更低,部署更方便。
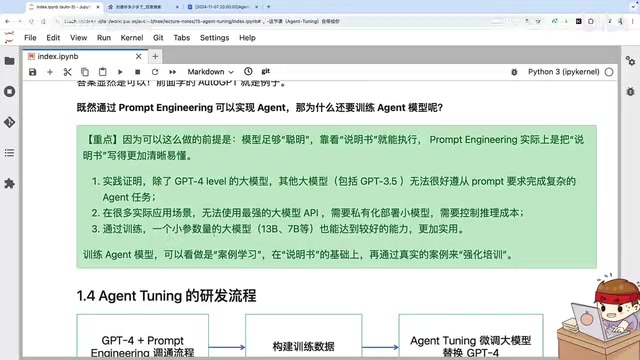
打个比方:Prompt像是通识教育,Agent Tuning像是上岗培训。大学生有通用知识储备,但到了具体岗位还需要针对性训练。
AutoGPT:2023年出现的一个开源实验性项目,尝试仅靠精心设计的Prompt就让GPT-4自主完成复杂任务——自动拆解目标、调用工具、循环执行直到完成。它验证了"用Prompt也能做出Agent"的可行性,也暴露了明显短板:token消耗巨大、容易陷入死循环、长流程中错误不断累积。AutoGPT的意义在于证明了Agent范式的方向,同时反衬出为什么要在模型层面做Agent Tuning——把能力内化到参数里,比靠外挂Prompt硬撑更稳定、更省token。
Agent Tuning:指用大量Agent任务轨迹数据(包含思考过程、工具调用、执行结果)对大模型做监督微调,让模型学会"何时该调用哪个工具、如何拆解任务、出错时如何回退"这些行为模式。与纯粹依赖Prompt不同,Tuning把Agent能力写进了模型权重,因此3B、7B这样的小模型也能获得可用的Agent表现。这既满足了私有化部署的合规要求,又把推理成本压到了可接受范围。
Agent Tuning的研发流程和成本考量
典型流程是:先借助GPT-4这类强模型把整个Agent流程调通,然后在此基础上构建训练数据——自动化生成加人工修正——再进行Agent Tuning训练自己的模型,最后替换掉GPT-4完成闭环。
Prompt和训练数据之间有强关联,所以流程调通是构建高质量数据的前提。
但Agent Tuning并非任何场景都必须。如果能用API且成本可接受,就没必要自己做训练。教程给了一个成本参考:7B模型、470万token训练数据、训练5轮,按阿里云广告A100价格估算,需要4卡才能训起来,整体成本不低。如果需要反复调整,成本还会增加。
这个数据可以作为业务决策时的参考——先算账,再决定要不要走Tuning这条路。
相关推荐

AI不是替代者:从工厂根因分析看人机协作
从工厂根因分析场景出发,解析AI如何加速证据链构建而非替代人类专家,探讨「AI支持人而非取代人」的务实落地逻辑与商业价值。

AI Agent决策审计:受监管流程中的证据链怎么建
从Reddit讨论出发,分析受监管流程中AI agent决策审计的三个核心问题:审计记录该包含哪些字段、错误决策的反馈延迟如何应对、以及LLM评审员与人类判断的一致性如何持续校准。

FCC首度出手:含"外国监控芯片"设备被禁
FCC首次行使新权力,以含有"外国监控芯片"为由封禁两款设备。本文分析这一监管变化对硬件供应链合规、芯片采购决策及市场准入的影响。