#RAG
共 326 篇相关文章

StringQFT:AI辅助理论物理的开放教材与工具集
StringQFT是一个面向AI辅助理论物理的开放教材项目,包含18卷3795页内容,提供1073项基准、1371条RAG记录和19个计算工具,支持自动答案检查与来源追溯。
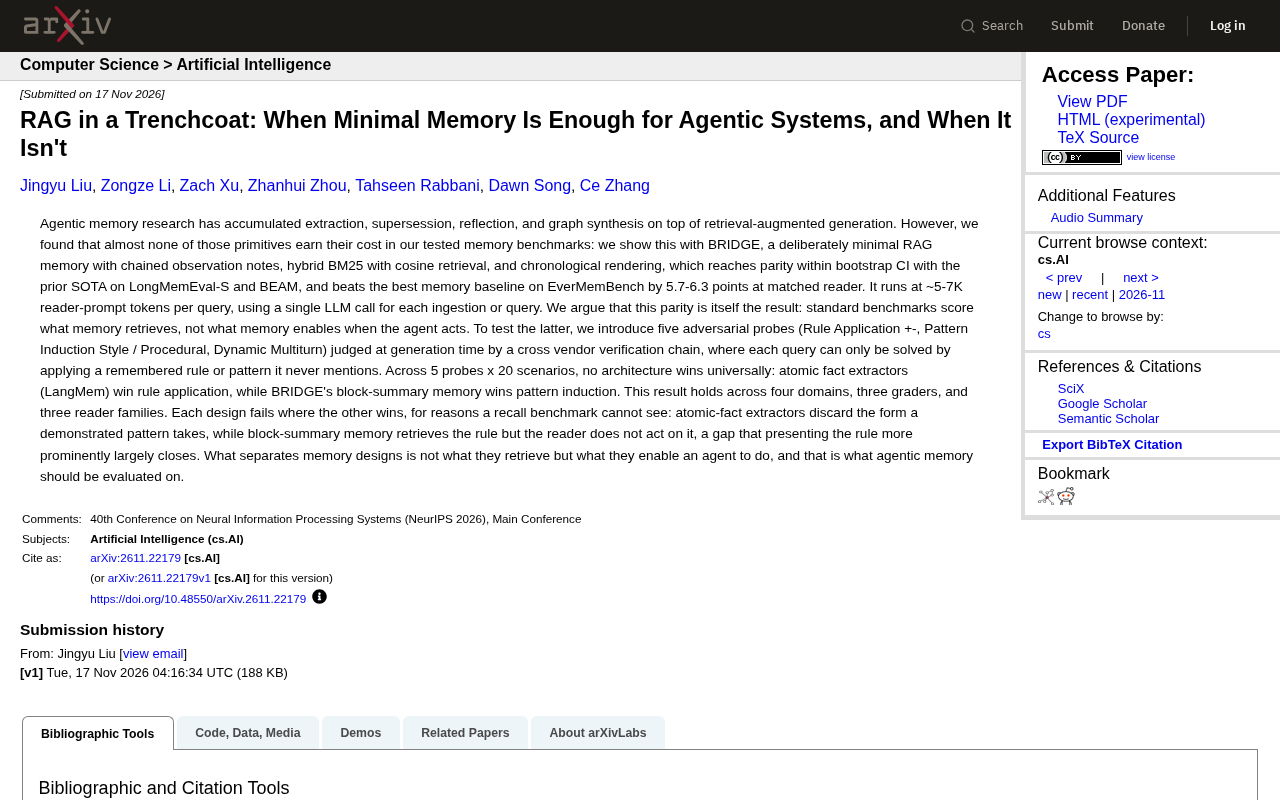
极简RAG记忆系统BRIDGE:何时够用,何时不够?
研究提出极简RAG记忆系统BRIDGE,在多个基准上媲美复杂系统,并通过对抗性探针揭示智能体记忆评估应关注“使能”而非检索。
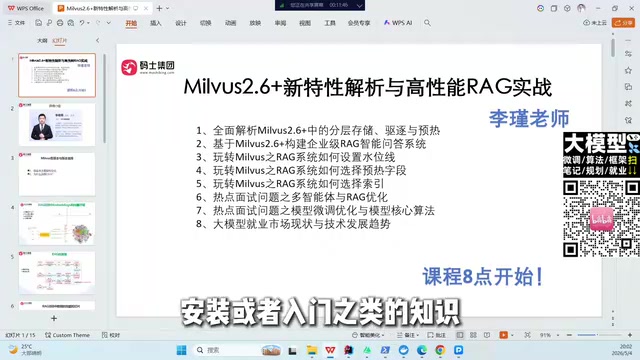
Milvus 2.6 实战:构建高性能 RAG 智能问答系统
深入解析 Milvus 2.6 向量数据库架构与部署方式,结合高性能 RAG 智能问答实战,讲解水位线、预热字段、索引与驱逐策略等关键优化点,帮助开发者构建企业级 AI 应用。
为律所搭建RAG聊天机器人后,我对AI的看法变了
一位开发者分享为律师事务所构建RAG聊天机器人的经历,反思AI在专业场景中的角色定位:技术指标只是入场券,信任机制和可审计性才是落地关键。
传统RAG与上下文图谱:如何判断谁更胜一筹?
传统RAG与上下文图谱如何选型?本文从查询复杂度、数据结构、评估指标三个维度给出判断框架,并探讨混合方案为何常是最优解,帮助开发者做出匹配业务需求的技术决策。
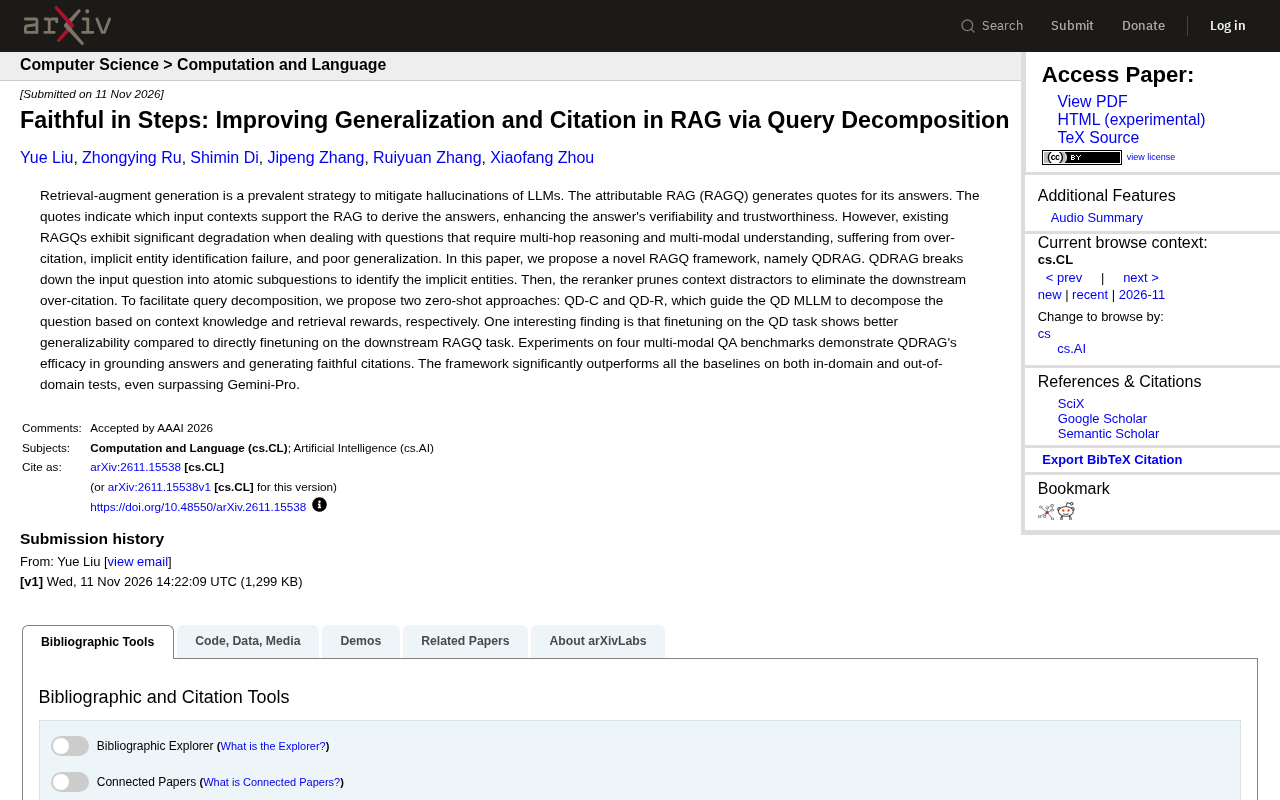
QDRAG:查询分解如何提升RAG引用忠实度与泛化能力
论文提出QDRAG框架,通过查询分解将问题拆解为原子子问题,结合重排序剪枝消除过度引用,显著提升RAG的引用忠实度和泛化能力,在多模态QA基准上超越Gemini-Pro。
四层拆解RAG向量索引:页面级命中掩盖了块级漏检
Reddit用户分享RAG向量索引四层检查方法,发现页面级命中可能掩盖块级漏检。本文解析该问题,探讨分层评估对RAG系统优化的重要性,并提供实践启示。
LLM Wiki+Graph RAG+传统RAG:企业知识库选型与实战
企业知识库该选传统RAG、Graph RAG还是LLM Wiki?本文拆解三者互补关系,给出分层取证、按需组合的落地方案,并介绍三明治架构语音智能体与多租户知识库中台的实战经验。
Milvus 2.6 实战:高性能 RAG 从向量原理到企业问答
基于李锦老师课程,详解 Milvus 2.6 向量数据库架构、相似度检索原理与高性能 RAG 项目实战,涵盖分层存储、驱逐策略、预热机制及 2026 年 AI 大模型就业趋势分析。

BharatSynthQA:印度寺庙遗产问答数据集,LLM表现如何?
BharatSynthQA是一个聚焦印度寺庙与宗教遗产的问答数据集,包含近10万问答对,揭示当前LLM在该领域知识薄弱,提供源段落时F1从0.18-0.30提升至0.73-0.77,支持文化 grounded QA与RAG研究。

Reddit热议:真正抓出RAG与AI Agent问题的评估方法
Reddit讨论聚焦:哪些评估真正抓出了RAG聊天机器人与AI Agent的实际问题,以及安全与数据治理如何在评估流程中同步落地。本文梳理有效评估的共同特征与可操作起点。

Weaviate播客对话ZeroEntropy:检索增强生成的技术新解
Weaviate播客第150期对话ZeroEntropy创始人Ghita Houir Alami,探讨检索增强生成(RAG)的技术挑战与创新思路,为开发者提供检索优化的新视角。

AI Agent不是幻觉,而是用错了"时间版本"的现实
AI Agent出错不一定是幻觉:它可能检索到真实但属于错误时间版本的信息。解析ChronoRAG-G与OETRA方法如何通过显式证据义务与时间兼容性检查,解决Agent的时间错配问题。

对话记忆新解:事实压缩与检索增强的配对评测
一项在LoCoMo数据集上的配对评测对比了检索增强生成与事实压缩两种对话记忆策略,发现压缩策略在事实型问题上以更少token取得优势,但在需要精确措辞的对抗性问题上落后,揭示了记忆设计的选择边界。

Dify 搭 RAG 助手:知识库、工作流与 Agent 节点实战指南
Dify 搭 RAG 助手时知识库、工作流、Agent 节点怎么连才不乱?本文拆解三者分工与连接逻辑,讲清可上线 RAG 应用的核心链路,并给出从拖拽工具到代码框架的学习路径。

RAG生产环境向量数据库怎么选?开发者实战讨论
Reddit开发者讨论生产环境和MVP阶段RAG向量数据库的选型经验,涵盖专用向量数据库、传统数据库向量扩展与轻量方案的取舍,并提供务实的选型检查清单。

Dify从入门到部署:搭建RAG知识库与私有化智能体
从Dify平台定位讲起,对比Coze云端托管与Dify私有化部署的差异,详解Windows下WSL+Docker的安装流程,并梳理RAG知识库切分建库到嵌入网页的实操主线,适合大模型初学者。

MIPS加速:让RAG检索更快更高效
解析RAG中最大内积搜索(MIPS)的计算瓶颈:当候选向量达百万级、维度达数千时穷举搜索成本高昂,近似搜索等加速手段可在可控误差下显著提升检索效率,改善RAG端到端延迟与吞吐。