Agent工程化实战:从0到1搭建智能体的10个关键步骤
用10个工程化步骤,填平Agent从Demo到落地产品之间的鸿沟。
本文针对AI Agent开发中「Demo能跑但项目难落地」的核心痛点,提出了一套完整的工程化方法论,分10个步骤逐一拆解。前三步强调先想清楚再动手:明确需求的五要素、建立项目规范(含AGENTS文件和密钥管理)、设计workflow与Agent分离的架构。第四到六步聚焦构建模块:Agent定义要具体化角色与输出结构,工具遵循「一个工具只做一件事」原则,并区分Tools(能力)与Skills(可复用的经验证方法流程)。第七八步处理记忆与提示词:Context与Memory分开管理,提示词拆分成独立模块并纳入版本控制。最后两步覆盖上线后的工作:测试(能否跑通)与评估(做得好不好)是两件事,部署后需靠四类日志持续监控。全文核心论点是:Agent工程的本质是用确定性的工程方法约束不确定的AI,使其长期稳定地完成业务任务。
为什么有人做出来的只是一个一问一答的聊天机器人,而有人做出来的 Agent 却能自己搜资料、读网页、整理报告,甚至调用工具完成复杂任务?这中间的差距既不是模型也不是 API,而是工程化能力。
跟着教程调用一个框架、写个 Prompt、配几个工具,Demo 确实能跑起来,但真要从头到尾做一个完整项目时,问题立刻暴露:需求怎么定义?代码怎么组织?工具怎么拆解?出了问题怎么排查?功能更新后怎么保证不崩?Demo 能跑通和项目能落地之间,差的正是一套完整的工程化方法论。本文把 Agent 项目从 0 到 1 的完整流程浓缩成 10 个步骤,逐一拆解每一步该做什么、为什么这么做,以及那些常见的坑在哪里。
第一步到第三步:想清楚再动手
新手最大的毛病,是打开编辑器就开始写代码,一上来就想做一个「万能 Agent」——能聊天、能搜索、能写代码、能画图、能做 PPT。结果做了一两个月,什么都能干一点,什么都干不好。
定义需求才是正确的第一步。需要在文档里写清楚五件事:目标(要完成什么核心任务,必须具体明确)、输入(用户给什么信息、什么格式)、输出(最终交付物是文章、答案还是代码)、自主权边界(哪些能让 Agent 自己决定,哪些必须人工确认,比如删除文件这类高危操作)、成功标准(做到什么程度算完成,比如准确率达到 90%)。
反面例子是「做一个 AI 助手帮我做各种事情」——这不叫需求,叫幻想。正面例子则是「用户输入一个技术名词,Agent 搜索官网和 GitHub,输出一份包含核心结论、关键事实、来源链接的调研报告,信息必须真实,不确定的要标注」。目标一旦模糊,后面的工具、技能、记忆只会越加越多,系统最终变成四不像。
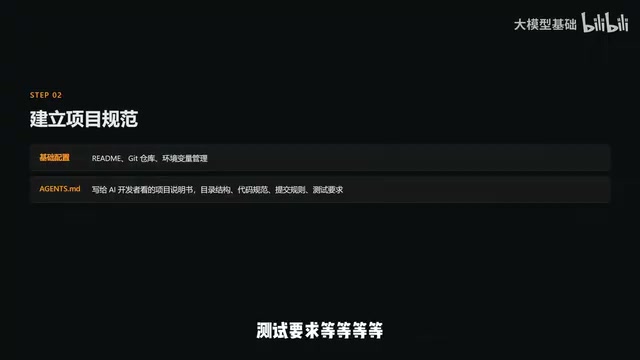
第二步是建立项目规范。越是小项目越要早立规矩,因为 Demo 可能下个月就变成生产产品,等大了再补规范就是「还债」。要做三件事:基础配置(项目做什么、怎么运行、依赖是什么,并建好 Git 仓库)、编写 AGENTS 文件(写给 AI 开发者看的项目说明书,包含目录结构、代码规范、提交规则、测试要求,AI 辅助开发时会先读它再动手)、密钥管理。
密钥管理有血泪教训:有学生把 API Key 写进代码传到 GitHub,当晚就被人扫到,用他的 Key 疯狂调用 API,一晚上花了 800 多块。正确做法是把真实密钥放进 .env 文件,并将其加入 .gitignore,绝对不能提交到代码仓库。
第三步设计项目架构。很多人喜欢把所有逻辑塞给一个大 Agent,给一堆工具让它「自己看着办」。Demo 阶段能用,复杂起来必然失控——因为大模型本身是不确定性程序,同样的任务可能这次先搜索再总结,下次先总结再搜索,第三次直接开始编造。
核心思路是把确定性流程和需要判断的部分分开。目录结构大致包括:agents(各 Agent 的定义和角色)、tools(工具函数)、skills(经过验证的任务方法流程)、workflow(确定性流程和编排逻辑)、提示词模板、上下文与长期记忆、单元测试与效果评估。最核心的一句话是:workflow 管流程,agent 管判断。就像餐厅分工,采购员买菜、厨师炒菜、服务员上菜、收银员收钱,每个岗位只干自己擅长的事,流程固定才不会乱。
第四步到第六步:定义 Agent、工具与 Skills
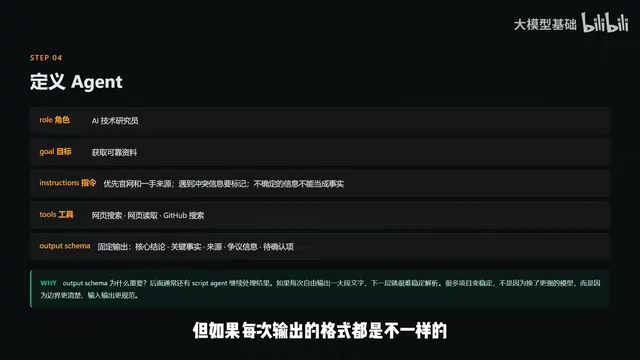
定义 Agent 时不能只写「你是一个有用的助手」,这就像招聘信息只写「我们需要一个人才」。至少要说清五件事:角色(越具体表现越稳)、目标、指令(具体行为规则,比如优先使用一手来源、遇到冲突信息要标记)、工具(不是越多越好,工具多了反而容易选错)、输出结构。
输出结构尤其重要,因为 Agent 的输出往往不是给人看,而是给下一个环节处理的——调研 Agent 的报告可能交给写作 Agent 润色或存入数据库。如果每次格式都不同,下一环节就无法稳定解析。就像餐厅上菜,这次用盘子、下次用桶、再下次直接倒桌上,后面的流程根本没法运行。
**设计工具(Tools)**的核心原则只有一句:一个工具尽量只做一件明确的事。搜索工具只负责搜索并返回标题、摘要、URL;读取网页的工具只负责读正文;保存文件的工具只负责存到指定路径。这样做有三个好处:工具越简单调用出错概率越低、出问题好排查、每个工具都能单独测试。
作者早期写过一个「全能」网页处理工具,输入地址后自动搜索、读取、提取、保存,结果 Agent 有时想搜索却触发了保存,有时读网页只返回摘要,排查半天才发现是工具太复杂导致理解错误。拆成三个独立工具后问题立刻解决。工具不是越强大越好,而是越清晰越好。
Skills 与 Tools 的区别是很多人搞混的地方:Tools 是能力(你能干什么,是手和脚),Skills 是方法(你怎么把事情干成,是菜谱)。比如「调研一个新 AI 产品」就是一个 Skill——搜索官网、查官方文档和 GitHub、看新闻和社区讨论、核对冲突信息、合并重复信息、整理成结构化报告。它调用了各种工具,但本身是组合使用工具完成任务的方法。
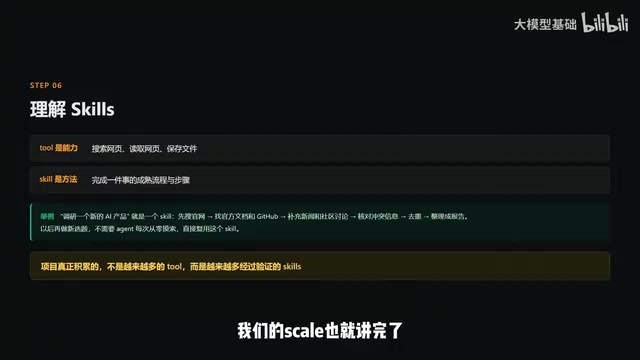
把经过验证的流程写成 Skill,下次做新调研就不用从零摸索,又快又稳。一个重要观点是:项目真正积累的不是越来越多的工具(工具网上一大堆),而是越来越多经过验证的 Skills,这才是核心竞争力。
第七步到第八步:记忆管理与提示词组织
Context 与 Memory 要分开管理。 Context(上下文)是当前任务里的所有信息:用户输入、已找到的资料、工具返回结果、程序执行到哪一步,任务结束后就没用了,直接扔掉。Memory(长期记忆)是跨任务保留的信息:用户偏好、做过的选题、固定规则。
有个反面例子:一个写作 Agent 把所有历史对话都存进上下文,结果每次写新文章都要重读之前全部内容,又慢又贵,更可怕的是旧文章里的错误信息会污染新文章。并不是记得越多就越聪明——记住了错误的东西反而让后续任务难以纠正。长期记忆一定要谨慎,只保存真正有价值、经过确认的信息。早期用 JSON 文件或 SQLite 就够,真有大量检索需求再上向量数据库,别一开始就过度设计。
Context 就像办公桌上正在处理的文件,下班收拾干净;Memory 像书架上真正有参考价值的书。
**组织提示词(Prompt)**不能一股脑全塞在一起。正确做法是拆成几部分分开管理:系统提示(角色和长期规则,固定不变)、任务描述(当前具体要干什么,每次不同)、约束条件(能做什么、不能做什么)、示例(给一两个正面例子告诉模型什么是好结果)、输出结构(固定最终格式)。
拆分的好处是修改时知道自己改了什么。比如 Agent 总把不确定信息写成事实,只需在约束条件里加一条「不确定信息必须标注」,不用重写整个提示词。提示词还要纳入版本管理,记录每次改了什么、为什么改、效果如何。有团队改提示词全靠感觉,改了一个月发现效果还不如最初版本,却已经回不去了。
第九步到第十步:测试评估与部署监控
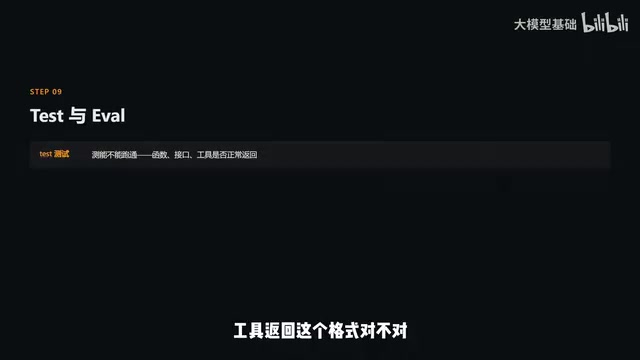
**测试和评估是两回事。**测试看能不能跑通:接口有没有报错、工具返回格式对不对,跟普通软件测试一样。评估看做得好不好:事实准确率、有没有幻觉、工具选择对不对、任务完成率。
举例:调研 Agent 输出了 2000 字报告,从测试看函数跑通、格式正确,测试通过;但从评估看,信息可能全是过时的、来源链接是编的、关键事实是错的——程序上成功,业务上失败。很多人只做测试不做评估,上线后才发现效果差,为时已晚。
评估的核心是固定评估集、用数据驱动迭代:准备一批测试案例(比如 20 个调研任务),每个都有标准答案或评分标准,每次改提示词、工具、流程后都跑一遍,看分数涨了还是降了。分数涨说明改对,降了赶紧回退,不再靠感觉判断。
部署和监控——上线才是真正的开始。Agent 不是确定性程序,同样任务今天明天结果可能不同,模型在更新、工具在变化、用户输入千奇百怪。上线后必须能看到 Agent 内部在干什么,要记录四类日志:任务日志(用户给了什么任务、workflow 走到哪一步)、决策日志(Agent 做了什么选择、为什么选这个工具,排查问题的关键)、工具日志(调用了什么、输入输出、耗时)、成本指标(token 用量、耗时、错误率、任务成功率)。
有了完整日志,用户反馈答案错误时就能顺藤摸瓜:查任务日志发现 workflow 走到第三步,查决策日志发现 Agent 选了搜索工具但关键词错了,查工具日志发现返回的第一条已是过时信息——问题立刻定位。没有 trace 和 log,出问题时你永远只能靠猜。
结语:用确定性工程约束不确定的 AI
从需求到上线,10 个步骤构成了从「会写 Demo」到「能做产品」的完整方法论。作者最后总结的一句话点破了核心:Agent 工程的本质,就是怎么让一个不确定的 AI 长期稳定地完成确定的业务任务。
大模型会抽风、会幻觉、会犯傻,但业务是确定的——用户问问题就必须给准确答案,让你调研就得给可靠报告。从定义需求到日志监控,所有工程化工作本质上都是在用确定性的工程方法去约束和引导不确定性的 AI。理解了这一点,也就理解了整个 Agent 工程的精髓。
背景补充
这里提到的「确定性流程与判断分离」,在工程上对应的是 Orchestration(编排) 的概念。编排层负责规定任务的整体走向:第一步做什么、满足什么条件才进入第二步、遇到错误如何回退,这些都是硬编码的逻辑,不依赖模型输出。Agent 层只在必须做出语义理解或策略选择时才介入,例如「这段话是在问产品价格还是技术参数」。这种分层设计借鉴了传统软件工程中的「策略与机制分离」原则——把稳定的流程机制交给程序控制,把变化的策略判断交给 AI,从而把系统的不确定性限制在可控的边界内。LangGraph、Prefect、Temporal 等工具都是为这类有状态编排场景而生的,但即便不用任何框架,在代码层面明确区分「流程控制代码」和「Agent 调用代码」也是同等重要的架构原则。
Skills 在实现上通常表现为一段固定的 Python 函数或脚本,内部按顺序调用多个 Tools,并包含错误处理和结果合并逻辑。它的关键价值在于可复现性:同一个 Skill 在不同任务中被调用时,执行路径是一致的,而不是每次由 Agent 临时决定「我先搜哪个再看哪个」。这与 Prompt Engineering 中常见的 Chain-of-Thought(思维链)有本质区别——思维链让模型在推理时自己决定步骤,而 Skill 是把经过人工验证的最优步骤固化成代码。随着项目演进,Skills 库的质量直接决定系统的稳定上限,因为它积累的是团队对特定任务领域的专业知识,这些知识以可执行代码的形式沉淀下来,既不会因模型升级而丢失,也不会因提示词变化而失效。
AI 系统的评估在业界通常称为 Evals(评测),是 LLM 应用工程中一个专门的子领域。常见的评估方式有三种:人工标注(最准确但成本高)、基于规则的自动检查(如验证输出是否包含来源链接、格式是否符合 Schema),以及用另一个 LLM 充当评判者(LLM-as-Judge,速度快但需要先验证评判模型本身的可靠性)。实践中通常混合使用:对格式、字段完整性用规则检查,对内容质量用 LLM-as-Judge,对关键业务指标做抽样人工复核。评估集的质量比数量更重要——20 个覆盖典型场景和边界情况的高质量测试案例,往往比 200 个随机案例更能揭示系统的真实短板。OpenAI Evals、Braintrust、LangSmith 等工具专门为此设计,但自建一个简单的 CSV + 评分脚本在早期同样有效。
相关推荐

AI温和派的崛起:在狂热与末日论之间寻找中间地带
AI舆论正陷入加速主义与末日论的两极撕裂,但一群"AI温和派"正在崛起。本文梳理福山、"AI作为常规技术"作者及好莱坞制片人卡森伯格的最新观点,呈现在狂热与恐惧之间寻找中间地带的思潮。
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。