Agent工作流中的人工审核该放在哪?关键检查点设计指南

Agent工作流中人工审核的位置决定其有效性,应设在高风险、不可逆决策节点而非流程末尾。
本文从一个开发者的真实困惑出发,系统分析了 agent 工作流中人工审核(human-in-the-loop)的位置设计问题。末尾审批因信息不对称和高纠错成本而容易流于形式,全节点审核则因「确认疲劳」和效率损耗而难以为继。真正有效的做法是将有限人力集中在边际价值最高的节点:外部不可逆动作执行前、agent 置信度低于阈值时、以及风险指标触发时。实践中,成熟的 agent 系统往往采用「默认自动 + 动作前拦截 + 弱证据升级 + 过程可追溯」的分层组合策略,核心理念是关注决策过程的可信度,而非仅看最终输出是否正确。
从一个真实困惑说起
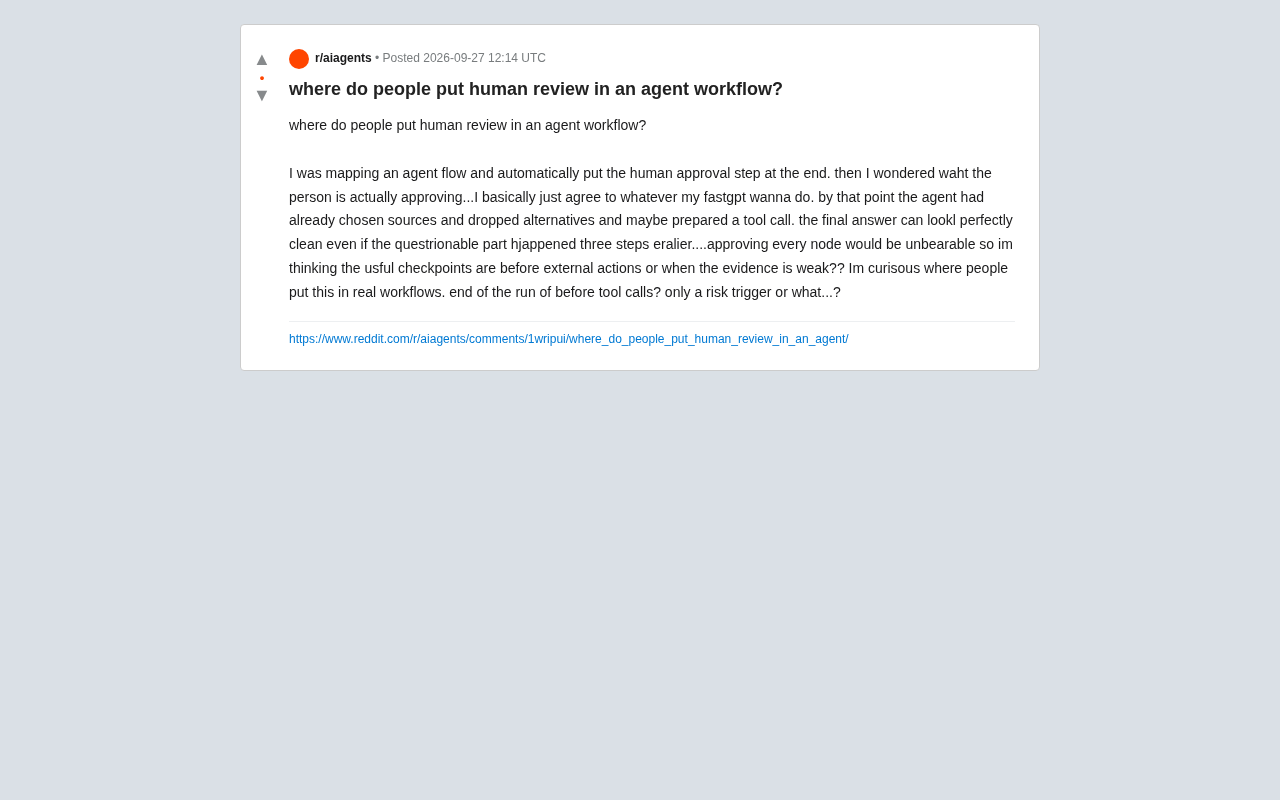
一位开发者在设计 agent 工作流时,习惯性地把人工审批环节放在了流程末尾。可当他真正开始思考「人到底在审批什么」的时候,问题暴露了出来:到了最后一步,agent 早已选好了信息源、丢弃了备选方案,甚至准备好了工具调用。最终输出可能看起来干净利落,但那个真正值得怀疑的环节,也许发生在三步之前。
这个观察点出了 agent 系统设计中一个被普遍忽视的问题——人工审核(human-in-the-loop)的位置,决定了它究竟是有效的控制手段,还是走过场的橡皮图章。
末尾审批为什么容易失效
把审核放在流程结尾,是最符合直觉的做法:agent 跑完全程,人看一眼结果,点头放行。但这种设计有两个结构性缺陷。
第一,信息不对称。到最终答案阶段,中间的决策路径已经被压缩甚至隐藏。agent 在早期选择了哪些证据、又抛弃了哪些替代方案,审核者往往看不到。原帖作者说得很直接:「我基本上就是同意 agent 想做的任何事。」当审核者缺乏对中间过程的可见性时,审批就退化成了形式。
第二,纠错成本高。如果问题出在流程早期(比如选错了数据源),到末尾才发现意味着整段推理链都建立在错误基础上,返工代价极大。更糟的是,一个逻辑有瑕疵的过程,完全可能产出一个「表面上无懈可击」的结论,反而更难被识破。
全节点审核也不是答案
那么反过来,是不是每个节点都插入人工确认就安全了?现实中这条路走不通。
原帖作者一针见血:「审批每一个节点会让人无法忍受。」agent 的价值恰恰在于自动化和速度,如果每一步都要等人点头,那还不如手动操作。过度的人工介入会彻底抵消 agent 带来的效率收益,也会让审核者陷入「确认疲劳」——当需要点击的确认框太多时,人反而会条件反射地全部通过,审核质量不升反降。
所以真正的问题不是「要不要人工审核」,而是在哪些点上审核的边际价值最高。
「确认疲劳」(confirmation fatigue)在人机交互研究中有充分记录,与之相关的还有「自动化偏见」(automation bias)——当人类审核者习惯性地面对大量机器输出时,往往会逐渐倾向于相信系统判断而放弃独立思考。研究表明,审批频率越高、单次决策信息量越大,认知负担就越重,错误率反而上升。这也是为什么安全领域早已放弃「更多审核等于更安全」的朴素假设,转而研究如何设计「注意力经济」——让有限的人类注意力只消耗在真正需要判断的地方。在 agent 系统中,这意味着审核设计本身就是一种资源分配问题,而非单纯的风险管控问题。
高价值检查点在哪里
结合原帖的思考和社区讨论,几个位置的审核收益明显更高:
外部动作执行前
这是最被广泛认可的检查点。当 agent 准备调用工具、发送邮件、写入数据库、执行交易等产生不可逆副作用的操作时,人工确认的价值最大。原帖作者也倾向于「在外部动作之前」设卡。原因很简单:内部推理错了还能重来,但真实世界的动作一旦发生就难以撤回。
证据薄弱或置信度低时
第二个高价值触发点是当 agent 的判断依据不足时。原帖提到「当证据薄弱时」应该介入——这本质上是一种基于风险的动态审核。与其在固定位置卡人,不如让系统评估当前决策的不确定性,只有在置信度低于阈值时才请求人工介入。这样既保留了自动化效率,又在真正需要判断的地方引入了人的经验。
风险触发式审核
更进一步的做法是设置风险触发器(risk trigger)。系统监控一系列信号——操作的破坏性、数据的敏感度、金额大小、决策的偏离程度等——只有当风险指标越过阈值时才升级到人工审核。这种模式把人力集中在少数真正关键的决策上。
风险触发器的思路与软件工程中的「断路器模式」(circuit breaker pattern)以及金融交易系统的「熔断机制」有异曲同工之处——系统并非随时拦截,而是在监测到异常信号时才切换到保护模式。在 agent 场景中,常见的风险信号维度包括:操作的可逆性(数据库写入 vs. 只读查询)、影响范围(单条记录 vs. 批量修改)、偏离历史基线的程度(当前决策路径是否显著异于过往类似任务)、以及上下文的新颖性(agent 是否遭遇了训练和测试中未曾出现的情形)。将这些维度加权量化,就可以构造出一个动态的「风险分数」,超过阈值时自动升级到人工队列,低于阈值时放行。这种机制的难点在于阈值的校准:设得太低会复现全节点审核的问题,设得太高则形同虚设。
实践中的分层策略
综合来看,成熟的 agent 工作流往往不采用单一审核点,而是分层组合:
- 默认自动:低风险、可逆、高置信度的操作全自动执行;
- 动作前拦截:所有产生外部副作用的调用强制确认;
- 弱证据升级:置信度低于阈值时主动请求人工判断;
- 过程可追溯:即使不逐节点审批,也要记录中间决策路径,让末尾审核者能回溯「为什么会走到这一步」。
关键的转变在于:审核不应该只关心「最终输出对不对」,更要关注「导出这个输出的过程是否可信」。原帖那句「值得怀疑的部分可能发生在三步之前」,正是整个设计哲学的核心。
「过程可追溯」这一层在工程实现上通常依赖结构化日志或专用的 agent 追踪工具(如 LangSmith、Phoenix Arize 等)。这类工具会以树状或时间线形式记录每一次 LLM 调用的输入输出、工具调用参数、以及 agent 的内部推理链(chain-of-thought)。对于末尾审核者来说,能够快速定位「agent 在第 3 步选择了数据源 A 而非 B,原因是什么」,是判断最终输出可信度的关键前提。这也呼应了近年来 AI 系统可解释性(explainability)研究的核心主张:可解释性的价值不只在于事后分析,更在于实时赋能人类审核者作出更好的决策。
写在最后
人工审核在 agent 工作流中的位置,本质上是一场控制力与效率的平衡。放在末尾省事但失效,放在每一步安全但低效。真正有效的设计,是把有限的人力投放到边际价值最高的地方——外部动作之前、证据薄弱之时、风险触发之刻。
对于正在搭建 agent 系统的开发者来说,这个问题没有标准答案,但有清晰的思路:先识别哪些步骤不可逆、哪些决策高风险,再围绕这些节点设计检查点,而不是习惯性地把审批堆到流程末尾。
相关推荐
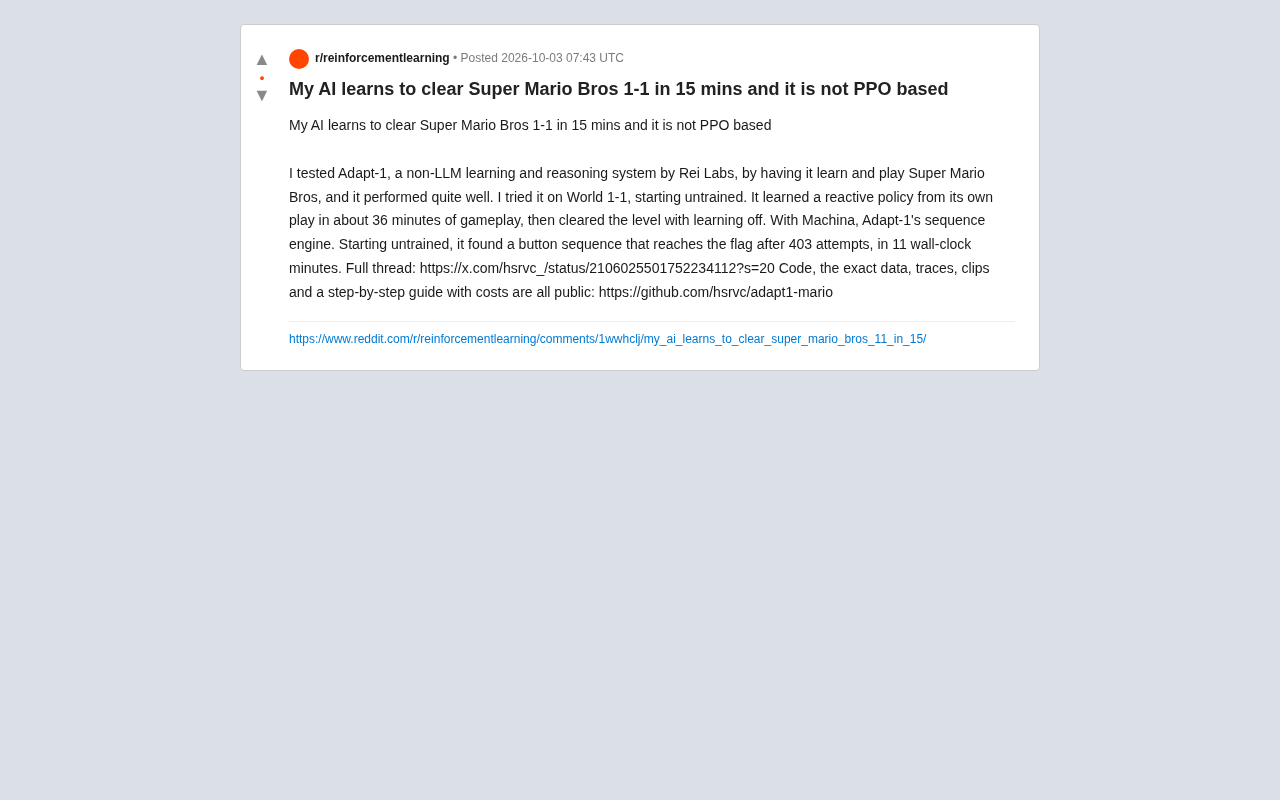
非PPO的Adapt-1:15分钟自学通关超级马里奥1-1
Rei Labs的Adapt-1是一个非PPO、非LLM的学习与推理系统,通过反应式策略和Machina序列引擎两种方式从零开始通关超级马里奥1-1,并公开全部代码与数据供复现。本文解析其方法与局限。

Seedance集成Computer:营销与品牌团队的AI新利器
Seedance 集成到 Computer 平台后,为营销和品牌团队带来 AI 视频内容生成的新可能。本文解析这类集成式 AI 工具对营销工作流的价值与落地考量。

vLLM 发布 v0.31.0:为 Transformers 版本设置上限约束
vLLM 发布 v0.31.0 版本,核心改动是在依赖项中为 Transformers 库添加版本上限约束,提升兼容性与部署稳定性。本文解析该改动的技术动机与对使用者的实际影响。