vLLM 发布 v0.31.0:为 Transformers 版本设置上限约束

vLLM v0.31.0 发布,核心改动为 Transformers 库添加版本上限以提升兼容性与部署稳定性。
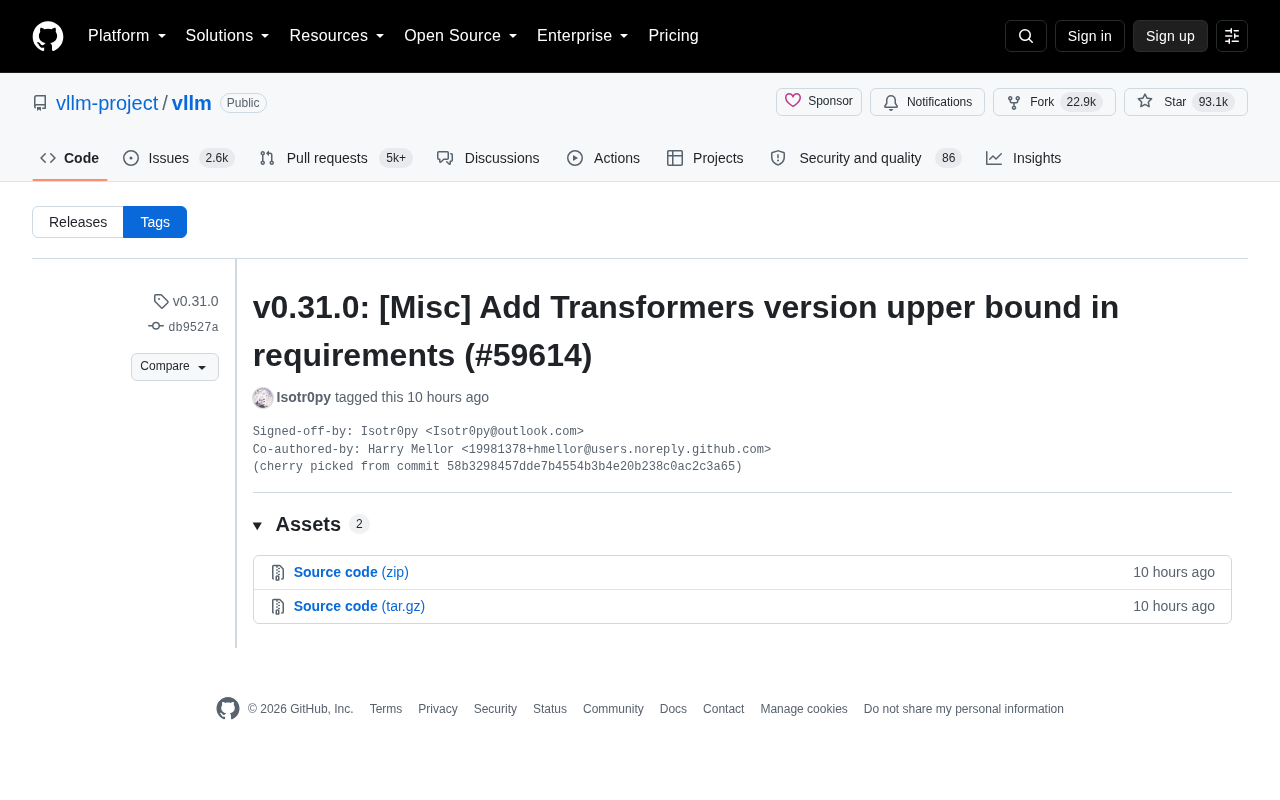
vLLM 发布 v0.31.0 版本,本次更新的核心改动来自 PR #59614,由社区贡献者协作完成并通过 cherry-pick 合入发布分支。改动内容是在依赖声明中为 Hugging Face Transformers 库添加版本上限约束。由于 vLLM 对 Transformers 的底层实现高度耦合,而 Transformers 更新频繁且时常引入破坏性变更,仅设下限的依赖声明会导致用户环境中自动拉取不兼容的新版本,进而引发运行时错误。添加上限后,部署的可复现性显著提升,隐性兼容性问题的排查成本也将降低。对于同时依赖更高版本 Transformers 的用户,需注意可能产生依赖冲突,应在隔离环境中处理或等待后续版本放宽约束。
vLLM v0.31.0 版本发布
vLLM 项目近期发布了 v0.31.0 版本。作为当前最受欢迎的大模型推理与服务引擎之一,vLLM 在 GitHub 上已累计获得超过 93.1k 星标,Fork 数达到 22.9k,是开源 LLM 推理生态中极具影响力的项目。
本次版本的主要变更来自 PR #59614,核心改动是在依赖项(requirements)中为 Transformers 库添加了版本上限约束(upper bound)。该提交由开发者 Isotr0py 发起,并与 Harry Mellor 共同协作完成,是从主干 commit 58b3298 cherry-pick 而来的修复。
为什么要给 Transformers 加版本上限
vLLM 的模型加载、配置解析和权重映射大量依赖 Hugging Face 的 Transformers 库。两个项目的迭代节奏并不一致——Transformers 更新频繁,且时常引入破坏性变更(breaking changes),比如调整模型配置字段、修改 API 签名或重构内部实现。
在依赖声明中只写下限(例如 transformers>=x.y)而不设上限,会带来一个隐患:当用户安装或升级环境时,pip 可能自动拉取最新版本的 Transformers,而这个最新版本未必与当前 vLLM 完全兼容,从而导致运行时报错或推理结果异常。
通过添加版本上限(即形如 transformers>=x.y,<z 的约束),维护团队能够把兼容性范围锁定在经过验证的区间内,避免下游用户因为上游的激进更新而“踩坑”。这是一种常见且务实的依赖管理实践,尤其适合像 vLLM 这样对底层库耦合度较高的项目。
Cherry-pick 是 Git 中的一个操作命令,指将某个特定的 commit 从一个分支"摘取"并应用到另一个分支,而无需合并整个分支的历史。在大型开源项目中,主干分支(main/master)通常处于快速迭代状态,包含大量尚未稳定的新功能。当一个 bugfix 或关键修复在主干上完成后,维护者会通过 cherry-pick 将其单独移植到较为保守的发布分支(release branch),这样就能在不引入主干其他变更风险的前提下,把修复带入正式版本。vLLM v0.31.0 的依赖约束改动正是通过这一机制从主干 commit 58b3298 合入发布分支的,体现了成熟开源项目对发布质量控制的严谨态度。
对使用者的实际影响
对于正在使用 vLLM 的工程团队来说,这类看似微小的改动往往能显著提升环境的可复现性与稳定性:
- 部署更可靠:新搭建的生产或测试环境不会意外拉入不兼容的 Transformers 版本。
- 问题定位更简单:排除了因上游库版本漂移导致的隐性 bug,减少排障成本。
- 升级路径更清晰:版本约束明确了官方验证过的兼容组合,便于团队规划依赖升级。
需要留意的是,如果你的其他依赖项或业务代码恰好需要更高版本的 Transformers,这个上限约束可能带来冲突,届时需要权衡是否等待 vLLM 后续版本放宽约束,或在隔离环境中处理。
在 Python 的包管理生态中,依赖版本"漂移"(version drift)是一个普遍痛点。pip 在解析依赖时遵循"最新兼容版本优先"的策略,若项目只声明下限而无上限,每次在新环境中安装时获取的实际版本可能各不相同,进而导致"在我机器上能跑"的经典问题。为此,业界常用 pip freeze 导出锁定文件、或借助 pip-tools、Poetry、uv 等工具生成 lock file 来固化全部依赖的精确版本。vLLM 在 requirements 中添加上限是在"官方包"层面给出明确的兼容性声明,与用户侧的锁文件策略互为补充——前者由项目维护者负责,后者由部署团队负责,共同构成可复现环境的保障。
开源协作的日常缩影
这次发布也折射出大型开源项目的日常运作方式:一个由社区贡献者提交、经过协作评审、再通过 cherry-pick 合入发布分支的小型修复,正是维持项目长期健康的基石。相比引人注目的大功能更新,这类依赖维护和兼容性保障工作虽不显眼,却直接关系到数十万用户的使用体验。
建议日常使用 vLLM 的用户关注官方 Release Notes,在升级前确认版本约束与自身环境的匹配情况,以获得最佳的稳定性。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。