Agentic AI工具设计:比Prompt更关键的一环

Agent 表现失常的根源常在工具设计,而非系统提示词。
文章指出,当 AI Agent 表现不佳时,人们习惯重写 System Prompt,但真正的问题往往出在工具设计上。模型只能看到工具的名称、描述和参数模式,模糊的命名会让它每次调用都像抛硬币。作者给出六条工程化建议:把工具描述写成给新同事的交接文档;按任务分组设计少而精的高层工具,同时分离读写操作;返回值只保留必要字段以节省 Token;让错误信息说明原因并给出替代方案;为写操作提供幂等键与 dry_run;在代码层面而非模型层面强制执行步数、超时和成本限制。核心结论是——调试 Agent 应先读失败记录,从工具入手,而不是反复修改 Prompt。
当AI Agent表现失常时,大多数人的第一反应是重写系统提示词(System Prompt)。但真相往往藏得更深:问题出在工具上——工具的命名、参数结构,以及出错时返回的信息。这个观点看似朴素,却切中了当前Agent落地的核心痛点。
模型眼中的工具:只有名字和描述
Agent选择工具的依据只有三样东西:名称、描述和参数模式(Schema)。除此之外,它看不到任何内部实现细节。
这意味着如果你提供了 search_customers 和 find_customer 两个名字相似、描述也相近的工具,模型每次调用都等于在抛硬币。这种模糊性会直接导致行为不可预测。
解决思路是把工具描述当作给新同事的交接文档来写:工具做什么、什么时候用、什么时候不用、什么样的参数才算合理。"搜索客户"只是一个标签;而"通过姓名、邮箱或电话查找客户。在任何需要customer_id的操作之前使用。支持部分名称匹配。"才是一条真正的指令。这个区别直接决定了Agent能否稳定地选对工具。
什么是参数模式(Schema)
参数模式通常以 JSON Schema 的形式描述,它规定了每个参数的名称、类型(字符串、整数、枚举等)、是否必填、取值范围以及格式约束。模型不会"看到"函数的内部实现,它只知道"调用 get_recent_orders 时需要传 customer_id(字符串)和 days(整数)"。因此 Schema 的设计质量直接决定了模型能否正确构造调用:如果 days 没有说明单位或默认值,模型可能传入 7 也可能传入 "last week";如果 customer_id 没有标注格式,模型无法判断应该传数据库主键还是业务编号。把 Schema 当作一份接口契约来写,给每个字段配上清晰的描述和示例,是让工具调用稳定的关键一环。
少而精的高层工具
工具粒度是另一个常见误区。假设用户问"这位客户上周买了什么",如果现有工具是 list_orders、get_order、list_order_items,Agent需要依次调用一长串,每一次调用都是一次往返、更多上下文Token、以及多一次出错的机会。
而一个 get_recent_orders(customer_id, days) 工具就能一步完成。据原文作者分析,这种"按任务分组"的设计大幅减少了调用链长度和故障面。
但也不能走极端。一个既查数据又改数据的工具,既难以描述清楚,也难以在审批环节控制风险。核心原则是按任务分组,同时把读操作和写操作分开。
返回值应该为模型服务,而非暴露原始API
很多开发者习惯把底层API的完整响应直接丢给Agent,这是一个隐性成本黑洞。一个四十个字段的JSON记录,每次调用都在消耗Token,同时把真正重要的三四个字段埋在噪音里。
原文给出了几条实用建议:删掉Agent永远不会用到的字段;在可能的情况下用名称替代不透明的ID,但当下游工具需要ID时也要保留;限制列表返回条数并明确告知——比如"显示312条中的20条,请缩小搜索范围或使用page=2继续。"
这些细节看似琐碎,但累积起来对Agent的决策质量和运行成本影响巨大。
错误信息就是指令
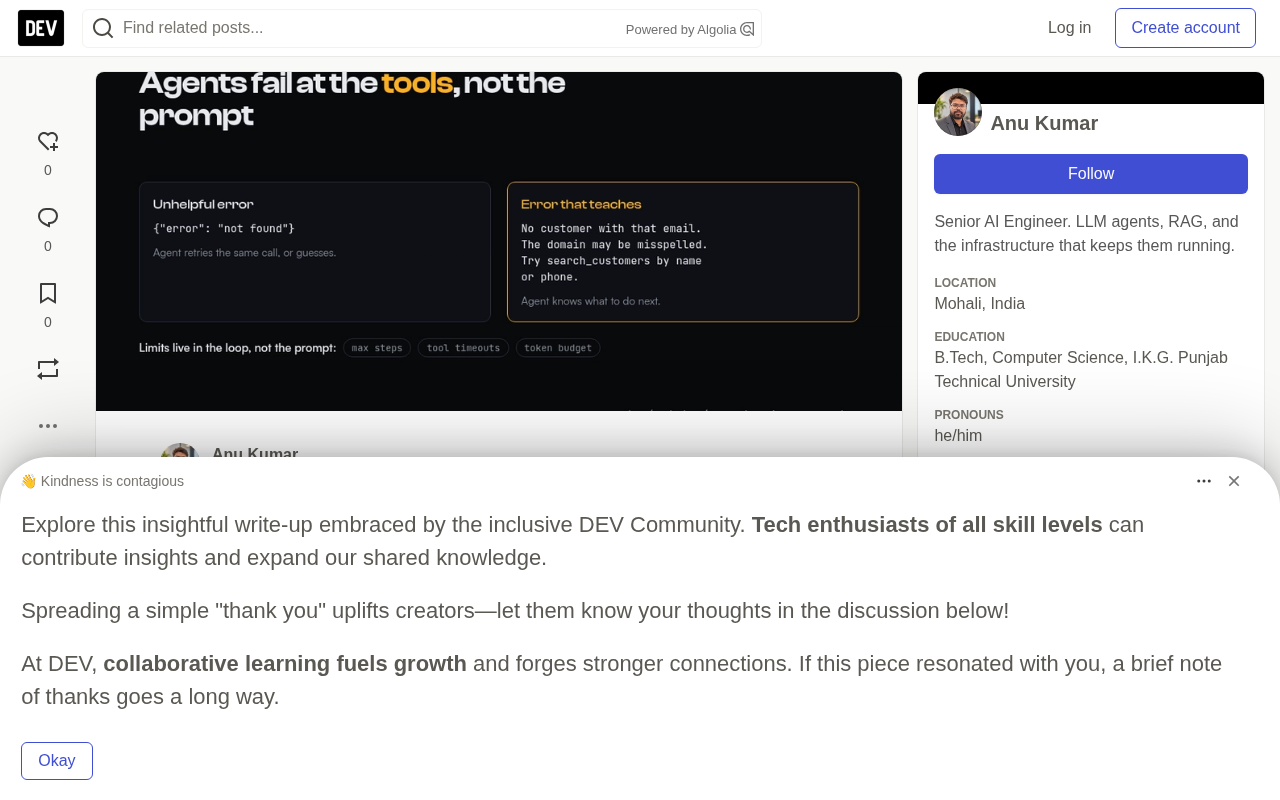
Agent读取工具返回的错误信息后,会据此决定下一步动作。一个裸错误(如 {"error": "not found"})什么信息都没提供,Agent要么重复同样的调用,要么自己编一个答案。
有价值的错误信息应该说明出了什么问题,以及应该尝试什么替代方案。原文给出的对比例子很直观:
# 无帮助
{"error": "not found"}

# 有帮助
{"error": "没有邮箱为 ravi@exmple.com 的客户。该域名可能拼写有误。请尝试用姓名或电话通过 search_customers 查找。"}
后者不仅告诉Agent"没找到",还指出了可能的原因和下一步行动。这种设计思路把错误处理从"报错"升级为"引导"。
让写操作可安全重试
Agent会重试。网络超时可能发生在请求已经到达服务器之后。任何涉及写操作的工具都应该接受一个幂等键(Idempotency Key),确保同样的调用执行两次只产生一次效果。
话说回来,参数的合法性校验应该放在工具内部完成,而不是信任模型会传入合理的值。对于高风险操作,提供 dry_run 标志,让Agent先展示"将会发生什么"而不实际执行。这些机制共同构成了一层安全网,把Agent的不确定性限制在可控范围内。
幂等键(Idempotency Key)的工作机制
幂等键是一段由调用方生成的唯一标识符(通常是 UUID),随写操作一起发送给服务端。服务端在处理请求前先检查这个键是否已经出现过:如果是首次出现,就正常执行并把结果与键一起记录;如果同一个键再次到达,说明这是重试,服务端直接返回第一次执行的结果,而不重复产生副作用。这样即使 Agent 因为超时或网络抖动把同一个"退款"或"创建订单"操作发送了两次,业务层面也只生效一次。对于 Agent 场景尤其重要,因为它无法可靠地区分"请求没发出去"和"响应没收到",而幂等键把这个判断责任交给了服务端。
把限制放在模型之外
要求模型"最多执行十步",它有时会执行三十步。这是当前模型的固有限制。可靠的做法是在运行循环的代码层面强制执行:最大步数、每个工具的超时时间、Token或成本预算。
当触发限制时,停止执行并返回已完成的部分结果,附上简洁的解释。一个有理由的部分答案,远好过一个无限循环直到被外部杀死的Agent。
运行循环(Agent Loop)与预算控制
Agent 的执行本质上是一个循环:模型输出一个工具调用 → 系统执行 → 把结果回灌给模型 → 模型决定下一步,直到它给出最终答案或触发停止条件。把最大步数、超时和成本预算放在这个循环的代码里,意味着无论模型如何"意图",一旦触及阈值循环就会强制中断。这些阈值应该按业务场景设定:面向用户的实时问答可能只允许 5~8 步和十几秒;后台批量任务则可以放宽。中断时返回已有的部分结果,比让 Agent 卡死或无限循环更有价值,因为用户至少能得到一个可用的中间回答。
先读失败记录,再改Prompt
原文最后给了一条务实的建议:在再次修改Prompt之前,先读几段Agent失败的完整记录。你通常会发现它误读了工具、被工具的输出淹没、或者在一个它无法理解的错误上反复重试。这些问题的根源都在工具设计上,而非Prompt本身。
这个判断框架的价值在于,它把Agent调试从"反复试Prompt"的玄学,拉回到了工程化的轨道上。工具的名字、描述、参数、返回值和错误信息,每一个环节都是可以被系统性优化的对象。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。