Agentic SOAR vs 传统SOAR加聊天机器人:安全响应的真实差异
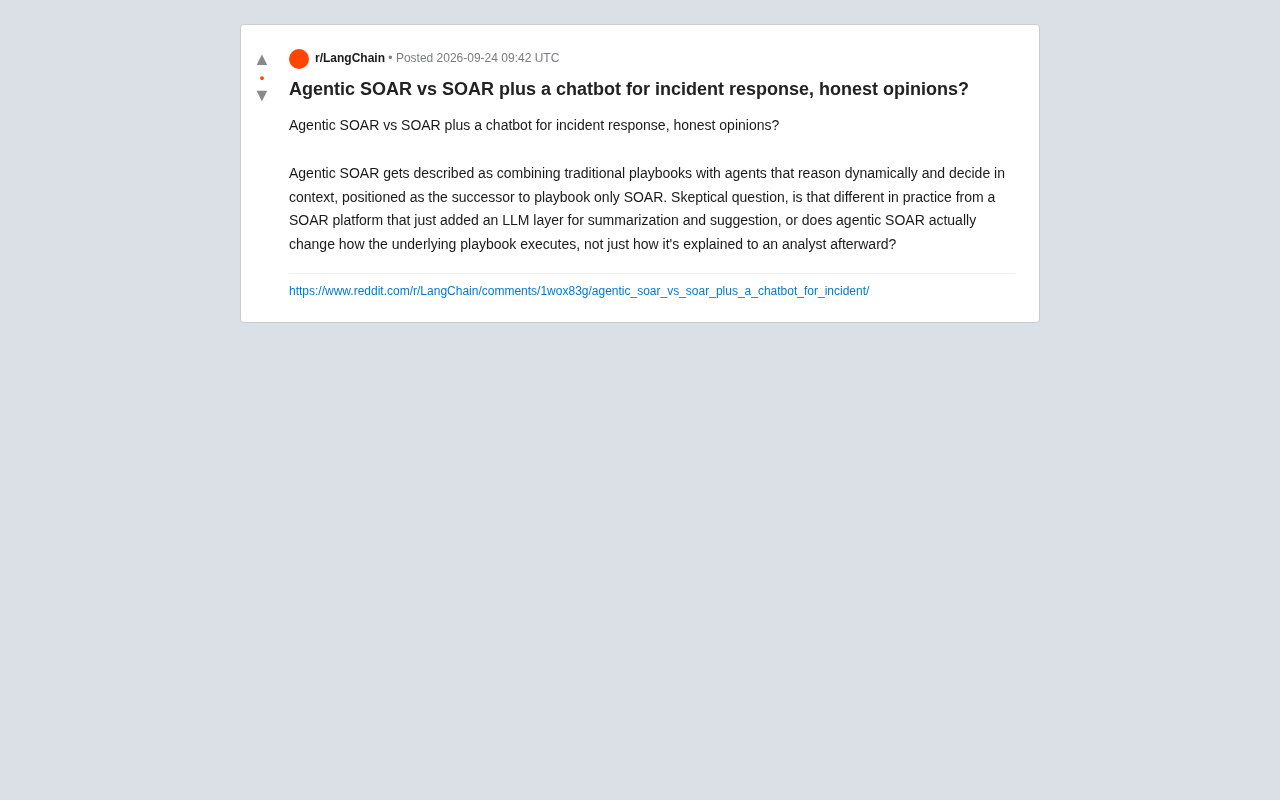
辨别Agentic SOAR与「SOAR加聊天机器人」的本质:AI究竟改变了机器的决策执行,还是仅改变了人看到的解释界面。
本文针对安全运营领域一个正在发酵的核心争议展开分析:市面上标榜「Agentic SOAR」的产品,是否只是在传统SOAR平台外叠加了一个LLM聊天层?文章厘清了两者的本质差异:传统SOAR依赖预定义剧本做确定性执行,LLM外挂层仅在执行完成后提供摘要、建议和问答,不介入执行逻辑本身;而真正的Agentic SOAR应让智能体嵌入执行链条,能在剧本未覆盖的场景中动态推理并自主决策。这一区分对SOC团队意义重大:前者在面对新型攻击时仍会卡壳,后者则在扩大自动化覆盖的同时引入可审计性与可控性的新挑战。文章最后提供了四个可操作的辨别问题,帮助评估者穿透厂商营销话术,回归执行层验证。
一个来自安全运营一线的尖锐提问
在网络安全运营(SecOps)领域,一个关于事件响应工具的争论正在发酵。Reddit 上一位从业者抛出了颇具穿透力的问题:所谓的 Agentic SOAR(智能体化安全编排、自动化与响应),与「传统 SOAR 平台外挂一个 LLM 聊天机器人」,在实际运行中究竟有没有本质区别?
这个问题之所以尖锐,是因为厂商的营销话术往往模糊了两者的边界。Agentic SOAR 被描述为「结合传统 playbook(剧本)与能够动态推理、在上下文中做决策的智能体」,并被定位为「仅靠剧本的 SOAR 的继任者」。听起来很美,但一线分析师想知道的是:这到底是运行逻辑的升级,还是只是给分析师看的「事后解释」变得更漂亮了?
先厘清两个容易混淆的概念
要回答这个问题,得先明确 SOAR 的本质。传统 SOAR(Security Orchestration, Automation and Response)的核心是预定义剧本:当某类告警触发时,系统按照人工事先编写好的固定流程执行——查询威胁情报、隔离主机、封禁 IP、创建工单。它的逻辑是确定性的、线性的,走的是 if-then 的分支树。
「SOAR + 聊天机器人」是什么
这种模式下,底层剧本的执行方式完全没变。LLM 层通常做三件事:
- 摘要:把一堆告警日志和事件数据压缩成人类可读的总结
- 建议:向分析师提示「下一步可能该做什么」
- 问答:让分析师用自然语言查询事件详情
关键在于——LLM 在这里是一个旁观者。它读取剧本执行的结果,然后把结果翻译给人看,但它不参与、也不改变剧本本身如何跑。剧本该怎么执行还怎么执行,AI 只是叠加在最上层的一个「解说员」。
「Agentic SOAR」承诺了什么
真正意义上的 Agentic SOAR,理论上应当让智能体介入执行链条本身。也就是说,智能体不是在剧本跑完之后做总结,而是在事件处置过程中:
- 根据实时上下文动态选择下一步动作,而非死板遵循预设分支
- 在剧本没有覆盖的场景中自主推理出应对路径
- 调用工具、评估结果、再决定后续,形成闭环的决策循环
换句话说,区别的核心是:AI 是改变了剧本的执行方式,还是只改变了向分析师解释的方式? 这正是原帖发问的精髓。
SOAR 平台诞生于 2015 年前后,最初是为了解决 SOC 团队面临的「告警疲劳」问题——每天数以万计的安全告警中,大量是重复性、低价值的噪音,分析师的精力被大量消耗在机械性的查询和处置动作上。早期代表产品包括 Phantom(后被 Splunk 收购)、Demisto(后被 Palo Alto Networks 收购并改名 XSOAR)和 Swimlane。这类平台的核心价值在于「编排」——将散落在防火墙、EDR、威胁情报平台、工单系统等各工具之间的操作,通过 API 集成串联成自动化流程。然而,剧本的编写和维护本身需要大量人工投入,且对攻击场景的覆盖天然存在滞后性,这正是 Agentic 化尝试解决的根本矛盾。
「智能体(Agent)」在 AI 领域特指具备感知环境、规划行动、调用工具并根据反馈迭代的自主系统,区别于单次输入输出的普通 LLM 调用。其底层通常依赖 ReAct(Reasoning + Acting)或 Plan-and-Execute 等框架,让模型在每一步骤中先推理、再行动、再观察结果,形成多轮循环。在安全响应场景中,这意味着智能体需要维持跨步骤的上下文状态、调用沙箱分析或威胁情报等外部工具、并在获得新信息后修正决策路径。当前主流的实现方式包括 OpenAI Function Calling、LangChain Agents、以及各大安全厂商自研的工具调用框架。这种架构与「LLM 读取日志后输出摘要」在工程复杂度上存在数量级的差异。
为什么这个区分如此重要
对安全运营中心(SOC)而言,这不是文字游戏。如果 AI 只是事后解说,那么在面对剧本未预见的新型攻击时,系统依然会卡壳——它无法处置没写进剧本的情况。分析师得到的只是一份更好读的报告,而真正的响应决策负担仍然压在人身上。
而如果 AI 真正嵌入执行层,它理论上能应对长尾场景、减少「剧本盲区」,让自动化覆盖更广的事件类型。但这同时也带来新问题:智能体自主决策的可审计性和可控性。安全响应动辄涉及隔离生产系统、封禁账户,一个「黑箱」智能体擅自行动的风险,可能比僵化的剧本更让 SOC 团队睡不着觉。
可审计性(Auditability)和人机协同(Human-in-the-Loop)是安全自动化领域的两个核心合规要求,在金融、医疗、关键基础设施等受监管行业尤为突出。NIST 网络安全框架和 SOC 2 等标准均要求安全操作具备完整的决策留痕。对于 Agentic 系统,这意味着不仅要记录「执行了什么动作」,还要记录「基于什么推理做出该决策」——即智能体的思维链(Chain of Thought)也需纳入审计日志。目前业界尚无针对 AI 驱动安全响应的统一审计标准,这也是许多 SOC 团队对 Agentic SOAR 持谨慎态度的制度层面原因,而非仅仅是技术信任问题。
如何辨别厂商话术里的水分
面对市场上纷繁的「Agentic」标签,采购或评估时可以用几个问题快速验伪:
- 执行层追问:当遇到剧本没定义的情况时,系统是停下等人,还是能自主推理出动作?如果是前者,那本质仍是传统 SOAR。
- 决策记录:智能体做出的每一步决策是否可追溯、可回放?还是只有最终结果的摘要?
- 人工介入点:智能体是全自动执行,还是在关键动作前需要人工批准(human-in-the-loop)?这决定了它的实际自主程度。
- 剧本依赖度:脱离预定义剧本后,系统还能不能工作?完全依赖剧本、AI 只做包装的,就是「换皮」。
如果厂商只能拿出更漂亮的告警摘要和自然语言问答界面,却说不清底层执行逻辑发生了什么改变,那大概率就是「SOAR 加了个聊天机器人」,而非真正的 Agentic SOAR。
务实的判断
从原帖引发的讨论视角看,这个领域目前存在明显的营销与工程现实之间的落差。「Agentic」是当下最热的营销词,但很多产品的智能体成分仅止于表层的 LLM 摘要与建议。真正让智能体参与执行决策、并保证可控可审计的系统,工程复杂度和信任门槛都要高得多。
对于正在评估事件响应工具的团队,务实的态度是:不要被「继任者」「下一代」这类叙事带节奏,而是回到执行层去验证——AI 究竟改变的是机器做什么,还是仅仅改变了人看到什么。 这一条界线,才是区分真智能体与聊天机器人外挂的试金石。
相关推荐
本地AI多节点一键部署:Panel AI如何降低私有化门槛
一款名为Panel AI的本地AI多节点部署面板试图把复杂的私有化部署做成一键傻瓜式操作,支持vLLM与Ollama、应用市场一键安装和多机集群管理。本文解析其功能、部署流程与AI基础设施的价值定位。
MiniMax H3 开源视频模型实测:能否颠覆 AI 视频生成?
MiniMax H3 开源视频生成模型实测:支持文本/图像/视频/音频多模态输入,最高 2K 分辨率、音频驱动、R2V 运镜等独特功能,已原生集成 ComfyUI。本文解析其真实表现、短板与本地部署方法。
YuE2歌曲生成模型Windows本地部署完整教程
YuE2(月二)是香港团队推出的开源AI歌曲生成模型,对标Suno。本教程详解如何在Windows系统用ComfyUI便携版配合低显存消费级显卡(如2080Ti)本地部署YuE2,包含硬件要求、生成管线、冒烟测试及常见问题解答。