YuE2歌曲生成模型Windows本地部署完整教程
香港团队开源的3B音乐生成模型YuE2,通过ABC乐谱两段式管线在低显存显卡上实现可控AI作曲。
YuE2是香港团队开发的3B参数开源AI音乐生成模型,目标对标商业级的Suno V5/V6。其核心特色是两段式生成管线:先将风格提示词与歌词转化为ABC乐谱,再基于乐谱进行声学生成,从而实现旋律骨架的可控复用。官方建议24GB显存,但本文介绍的ComfyUI便携版脚本方案让2080Ti等12-22GB显存的图灵架构显卡也能运行FP16版本,尽管生成一首歌需十余分钟。部署关键在于独立环境管理(we2env文件夹)以及将权重放置于正确路径(models/月二-3b),并在正式生成前用30秒冒烟测试验证环境。模型不支持商用与断点续传,但ABC乐谱可复用以提升效率。
YuE2是什么:对标Suno的开源音乐生成模型
YuE2(读作"月二")是一个由香港团队联合香港高校共同开发的AI音乐生成模型。据这位B站UP主介绍,该模型号称可以对标商业级的Suno V5、V6,目标是让用户通过文本提示词和结构化歌词,直接生成完整的AI歌曲。
和许多音乐生成模型不同,YuE2最大的特色在于它的两段式生成逻辑:先生成一段ABC乐谱,再基于这份乐谱进行音乐生成。这意味着当你对某段乐谱满意后,后续生成的音乐内容就不会有太大波动,你可以指定基于某个乐谱继续创作,这在实际使用中提供了更强的可控性。
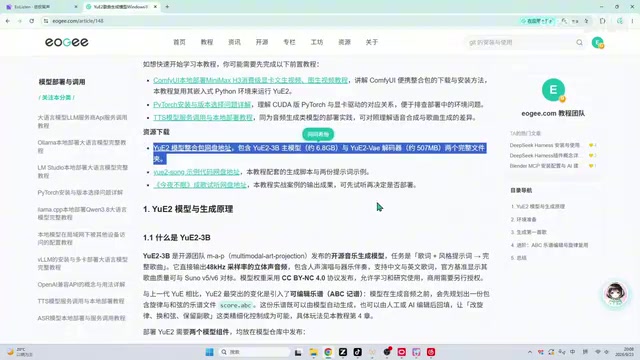
模型本身是一个3B参数规模的模型,磁盘占用约6.8GB,再加上一个约0.5GB的VAE模型,整体权重约7.3GB。虽然体积不算大,但实际运行时的显存消耗要高不少。
ABC乐谱是一种轻量级的文本音乐记谱格式,起源于1980年代的民间音乐社区。它用ASCII字符表示音高、时值、调号等信息,例如 |: G2 A2 | B4 :| 就能描述一段旋律。这种格式文件极小,便于模型以语言建模的方式进行学习和生成。YuE2选择先生成ABC乐谱的设计,本质上是把旋律骨架的生成当作一个"文本生成"问题来处理,再将结构化的乐谱信息传递给声学解码器,从而实现旋律可控性与音色表现力的分离。相比直接端到端生成波形,这种两阶段设计更容易让用户在旋律层面进行干预和复用。
完整生成管线:从提示词到高清音频
理解YuE2的工作流程,有助于在部署时排查问题。整个生成管线大致分为几个环节:
- 基于风格提示词 + 结构化歌词输入
- 生成ABC乐谱
- 语义转化与自回归逐帧输出
- 声学生成
- VAE解码,最终输出高清音乐
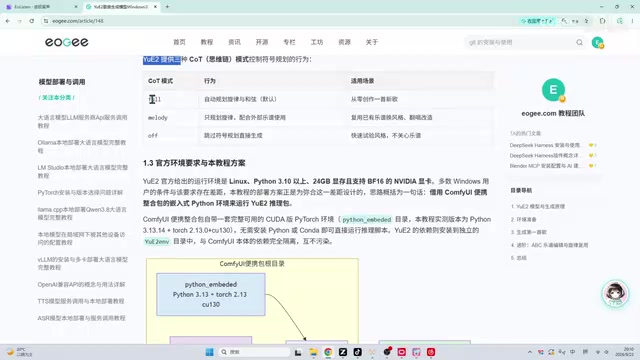
模型提供了几种运行行为模式:Full、Melody 以及关闭状态,分别对应不同的使用场景。UP主坦言自己在音乐乐理方面并不专业,因此教程重点放在了工程部署层面,而非乐理细节。
值得关注的是ABC乐谱的复用机制。第一次生成乐谱后,第二次生成时可以直接复用之前的谱子,这样能明显缩短整首歌曲的生成时间,对老显卡用户尤其友好。
硬件门槛:低显存显卡也能跑起来
官方建议的运行环境是24GB以上显存,这个门槛对大多数消费级显卡用户来说并不友好。本教程的核心价值,正是在于探索如何在非旗舰显卡上把这个模型跑起来。
UP主使用的配置是:
- 系统:Windows 11
- 显卡:2080Ti 22G(魔改版,图灵架构)
- 模型磁盘占用:7.3GB
- ComfyUI版本:0.31.0
这里有一个关键的架构限制需要注意:图灵架构(RTX 20系列)不支持BF16,只能运行FP16。好在UP主提供的模型版本本身就支持FP16,因此这一点不影响正常使用。
从实际体验看,UP主建议至少配备12GB或16GB显存才能相对流畅运行。以其2080Ti为例,生成一首歌大约需要十几分钟——显卡越老、显存越低,速度越慢;而在30系、40系显卡上会明显更快。
BF16(Brain Float 16)与FP16(Half Precision Float 16)都是16位浮点格式,但两者设计取舍不同:BF16保留了与FP32相同的8位指数位,数值范围更大、训练时不易溢出,是近几代AI训练的主流精度;FP16则将更多位分配给尾数,精度略高但动态范围小。英伟达图灵架构(RTX 20系列)的Tensor Core仅原生支持FP16,而安培架构(RTX 30系列)起才加入了BF16硬件加速。因此在20系显卡上强行运行BF16权重,要么报错,要么被软件回退到FP32大幅降速。YuE2提供专门的FP16版本,正是为了覆盖这部分用户群体。
部署思路:ComfyUI便携版 + 独立环境
整个部署方案建立在此前的ComfyUI便携版基础之上,再配合Python环境实现。前置条件是完成ComfyUI相关的环境配置以及GPU与PyTorch环境验证——如果跟着UP主前面的教程走过,这一步是绕不开的。
模型资源可以从UP主的网盘下载(速度较快),也可以去HuggingFace或魔搭(ModelScope)平台搜索模型名称"YuE2"(月二)自行获取。下载后务必确认文件完整。
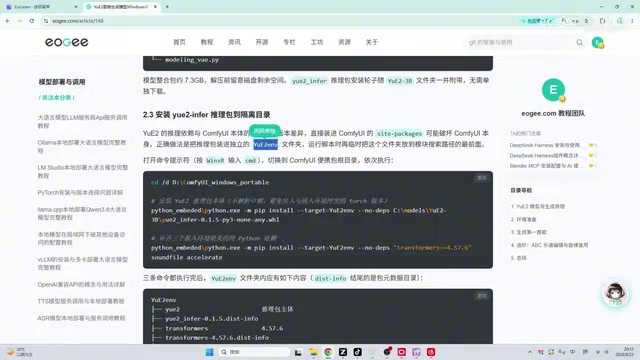
部署上有一个值得借鉴的做法:模型权重并没有直接放进ComfyUI的默认目录,而是单独建立了一个名为 we2env 的文件夹,专门存放该项目的模型权重和配置内容,同时还包含针对性的额外依赖。这种独立环境管理的方式,能有效避免与其他项目产生冲突。
脚本的默认模型路径是 models/月二-3b 文件夹。UP主特别提醒:绝大多数"找不到模型"的报错,都是因为模型放错了位置——只要放到这个默认目录下就不会出问题。
实操技巧:先做冒烟测试,再正式生成
运行过程本身并不复杂,执行对应脚本即可开始生成。但UP主给出了一个非常实用的建议:正式生成前,务必先做"冒烟测试"。
所谓冒烟测试,就是用约30秒的短音频快速验证本地环境与模型是否匹配。这一步能避免你辛辛苦苦等了十几二十分钟,最后却因为环境问题崩溃的尴尬。测试通过后,再进行完整歌曲的生成。
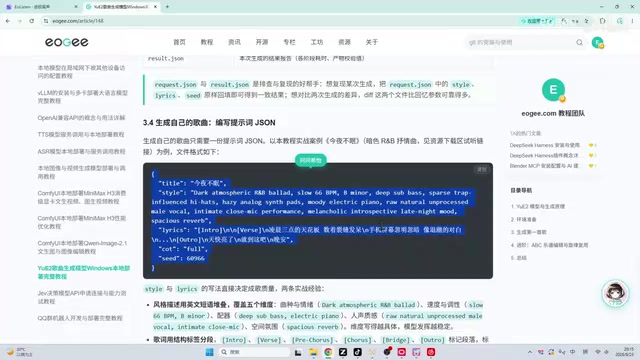
对于不熟悉命令行的用户,UP主还给出了一个偷懒方案:把项目配置文件放到与教程相同的位置后,可以直接让AI Agent协助——告诉它你部署了什么模型、配置信息是什么,然后描述想生成的歌曲即可。资源包中已经包含了可直接使用的提示词和歌词示例。
"冒烟测试"(Smoke Test)这一说法源自硬件工程领域——新电路板上电后,若没有冒烟则说明基本可用。在软件工程中,它特指用最低成本验证系统核心路径是否畅通的快速测试,通常只覆盖最关键的一条流程,不追求完整性。在本地AI模型部署场景中,冒烟测试的意义格外突出:大模型的单次推理往往耗时数分钟到数十分钟,任何环境依赖缺失、显存溢出或路径错误都可能在靠后的阶段才暴露。用30秒短音频做验证,等同于以极低时间成本提前拦截大概率失败场景,是部署流程中性价比最高的一步。
常见问题与使用限制
围绕这个模型,UP主还回答了几个高频问题:
爆显存怎么办? 可以调低相关参数,模型支持降配运行,代价是生成速度会变慢。
为什么不用ComfyUI节点生成? 目前还没有找到适配该模型的现成节点,因此本教程采用自己编写脚本的方式来模拟或替换对应节点功能。
能否商用? 模型本身不支持商用。生成的音乐作品可以在社交平台分享,但涉及获利的场景需要另行确认。
支持断点续传吗? 不支持。生成中断后无法从断点继续,只能重新开始。
总的来看,YuE2为想在本地体验AI音乐生成的用户提供了一条可行路径,尤其是这套针对低显存显卡的部署方案,降低了尝鲜门槛。虽然老显卡的生成速度较慢,但对于不追求即时产出、又不想依赖商业服务的创作者来说,这是一个值得动手实践的开源选择。
相关推荐
本地部署开源Laya实战:搭建环境并运行三个AI客服分类演示
开源项目 Laya 本地部署完整实战:从虚拟环境搭建、模型下载到三个客服文本分类演示,涵盖置信度阈值判断与接入本地大模型生成草稿回复,全程 CPU 运行无需 API 密钥。
Athena:让AI智能体学会遗忘的三层记忆系统
Athena是一个开源AI智能体记忆服务,采用三层结构与艾宾浩斯遗忘曲线机制,让智能体主动决定记住什么、遗忘什么。本文解析其话题切链、热度评分与间隔重复原理。
Qwen-Image-2.1 开源实测:7B参数媲美闭源图片模型
Qwen-Image-2.1 正式开源,视觉生成仅 7B 参数却媲美顶级闭源图片模型,支持多图参考编辑、透明图像生成与消费级显卡本地部署。本文实测其效果与 ComfyUI 部署全流程。