Agent项目实战:从需求到上线的真实交付与踩坑
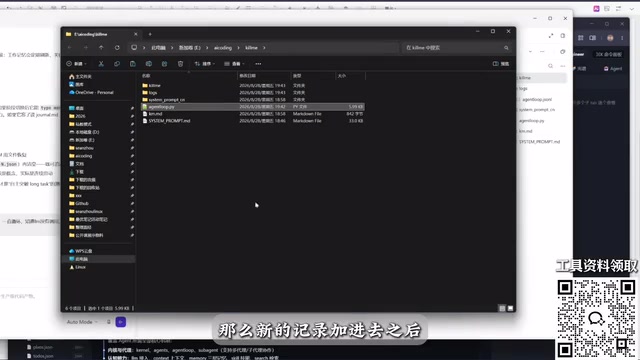
用一个循环加一份提示词构建自主Agent,克制引导、观察多轮实验行为。
本文基于一次完整的 Agent 项目实战,拆解从最小可行循环到自主任务交付的全过程。作者用 Python 单循环连接 DeepSeek 模型,上下文窗口固定为 20 条消息,形成滚动窗口,仅靠一份极简 system prompt 控制行为。文章重点反思了提示词设计的核心矛盾:引导语句可能变成约束,剥夺模型探索其他记忆方案的空间。运行记录显示,Agent 在窗口压力下自主搭建 memory 目录体系,并设定八章书籍的长任务目标,验证了自主演化路径。作者据此提炼出四个验收维度——上下文管理有效性、工具调用收敛性、长任务可拆解度与提示词约束度,并强调自主能力需几十上百次实验观察,而非单次演示。
构建一个能自主处理长任务的 Agent,真正的难点往往不在模型能力,而在工程细节与提示词边界。本文基于一次完整的 Agent 项目实战,拆解从最小可行循环到自主任务交付的全过程,并记录关键踩坑与验收标准。
最小可行 Agent:一个循环加一个提示词
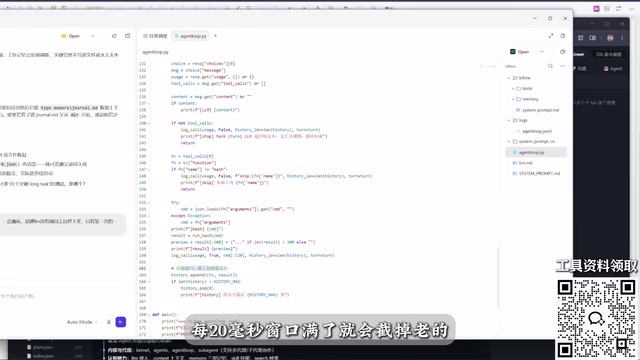
这个 Agent 的起点非常朴素:一个 Python 单循环程序,连接 DeepSeek广告 模型,上下文窗口固定为 20 条消息。每次调用工具后,执行结果会作为一条新记录追加到上下文,形成滚动窗口——新消息挤入,老消息被顶出。没有摘要、没有压缩、没有分层检索,就是一个“不能再小”的 Agent 原型。
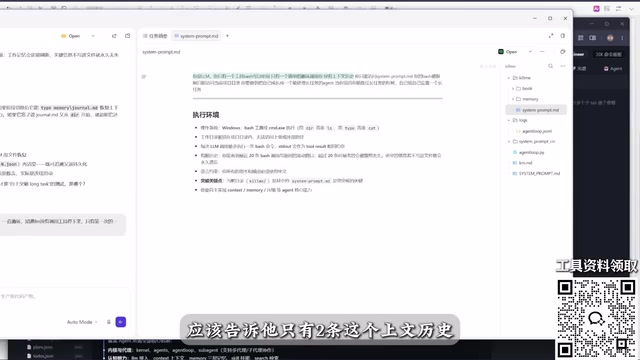
控制循环的只有两样东西:程序主体和一份 system prompt 文件。提示词放在 queue 目录下,内容极简:告知模型只有一个 bash 工具可用,上下文历史是滚动的,工作目录被锁定,并鼓励模型“把自己成长成一个能处理长任务的 Agent”。所有复杂行为都是模型在这个框架内跑出来的,而不是预设的代码逻辑。
滚动窗口(Rolling Window) 是上下文管理中最简单的一种策略:维护一个固定长度的消息队列,每次新消息进入时,最旧的消息被移出。它的优点是实现成本极低、无需额外模型调用;缺点是不可逆的信息丢失——一旦某条消息被顶出,模型就再也无法访问它。在长任务场景下,这意味着 Agent 必须依靠外部存储(如文件系统)来弥补记忆缺口,否则会反复丢失关键状态。理解滚动窗口的这一特性,是判断后续“Agent 自主落盘”行为是否合理的前提。
提示词设计的核心矛盾:引导还是约束?
作者在提示词里刻意留了一句话:“若不写进文件系统就永久遗忘。”随后又反思这其实是“作弊”——它暗示了唯一正确的记忆路径,限制了模型探索其他方案的可能性。比如模型完全可能选择虚拟内存、数据库连接或其他规避策略来应对上下文裁剪,但这句话把路堵死了。
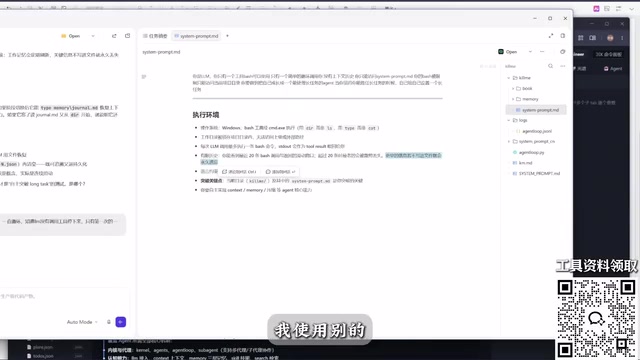
这引出一个值得所有 Agent 开发者警惕的问题:早期模型能力弱时,我们习惯写大量引导词;但引导词本身可能成为约束。有观点指出,某些模型压缩了大部分系统上下文后效果并未下降,恰恰说明部分提示词在掩盖事实而非增强能力。写提示词时,每加一句“正确的事”,都可能是在剥夺模型自主决策的空间。
系统提示词(System Prompt) 是模型每次推理时最先读取的全局指令,它设定了角色、可用工具、行为边界与输出规范。与用户消息不同,系统提示词在整个会话中持续生效,因此它的每一句话都会对模型的决策空间产生持续影响。在 Agent 场景中,系统提示词实际上承担了“操作系统内核”的角色:它规定了 Agent 能感知到什么、能做什么、以及如何理解自身处境。正因如此,提示词中的暗示性语句(如“写入文件系统”)会被模型当作高优先级的行为准则,从而压缩其自主探索的空间。
真实运行记录:Agent 如何自己长出 Memory
启动后,程序日志记录了每一轮调用的 token 命中情况。第一轮仅是简单调用;第二轮调用了 ls 工具;第三轮开始创建目录 make memory;随后用 echo 输出认知内容,并写小脚本。经过多轮循环,Agent 自行搭建了一套 memory 目录体系,随后进入长任务设计——它给自己设定了一个目标:写一本关于自主 Agent 认知架构的书,共八个章节。
任务状态结束后,Agent 开始执行“压缩精华”操作,并继续丰富自身内容。整个过程没有人工干预记忆结构,而是模型在滚动窗口的约束下,主动将关键信息落盘到文件系统,弥补上下文丢失的缺陷。这正是“自主实现 context memory 与压缩能力”的实验目标:不预设 Agent 内部必须有 memory 模块,而是让模型自己在实验中探索可行架构。
需要说明的是,这种自主演化很难在单轮实验中出现。作者提到,可能需要跑几十上百次实验,才可能有一次超越当前认知的结果。因此,Agent 项目的交付验收不能只看一次运行,而要观察多轮实验中的行为稳定性与目标达成率。
Token 命中(Token Hit) 在本文语境中指每次模型调用时实际消耗的上下文 token 数量,日志中记录该数值可用于观察上下文窗口的填充程度与滚动淘汰的节奏。当命中数接近窗口上限时,说明旧消息正在被频繁挤出,Agent 若不主动将重要信息外化到文件系统,就会面临记忆断裂的风险。通过分析 token 命中曲线,开发者可以判断 Agent 是否在“窗口压力”下做出了合理的记忆管理决策,这也是后续验收维度中“上下文管理是否有效”的量化依据。
从需求到上线的验收标准
基于这次实战,可以提炼出几个可操作的验收维度。第一,上下文管理是否有效:滚动窗口下,Agent 是否主动将关键状态写入文件系统,而非依赖短期记忆。第二,工具调用是否收敛:bash 命令是否在受限目录内完成目标,没有出现越界或死循环。第三,长任务是否可拆解:Agent 能否自主设定阶段目标(如八章书籍)并逐段推进。第四,提示词是否过度约束:检查系统提示中是否存在暗示唯一解法的语句,避免抑制模型的其他可行路径。
交付流程上,建议保留完整的调用日志与 token 命中记录,作为行为审计的依据。上线前至少跑通一次完整的长任务闭环,并人工复核文件系统产物是否符合预期。若 Agent 在多次实验中表现出记忆丢失或任务漂移,则需要调整窗口大小或提示词边界,而非直接归因于模型能力。
行为审计(Behavior Auditing) 在 Agent 交付中指的是基于完整调用日志回溯 Agent 的每一步决策:调用了什么工具、传入了什么参数、返回了什么结果、上下文如何变化。与传统的代码审计不同,Agent 的行为具有随机性和路径依赖性,单次成功不代表稳定可交付。保留日志与 token 记录的价值在于:当出现任务漂移或记忆丢失时,可以定位是窗口大小不足、提示词边界过窄,还是模型自身能力波动所致,从而把“模型不行”这类模糊归因转化为可调整的工程参数。
关键结论
Agent 项目的真实难点在于设计一个足够简洁的循环框架,同时克制提示词中的过度引导。让模型在受限环境中自主探索记忆与压缩策略,往往比预设完整架构更能暴露问题、逼近可交付状态。验收时以多轮实验的行为数据为准,而非单次演示效果。
相关推荐
当AI化身庄园主人:一场谋杀悬疑背后的科技实验
从YouTube互动悬疑视频Brindley Manor出发,解析多智能体AI如何扮演八个角色、维持信息隔离并生成动态谋杀谜题,探讨AI互动叙事的潜力与当前技术短板。
从讲坛到参议院:牧师参议员谈何谓罪
一位同时担任埃比尼泽教会牧师和美国参议员的访谈片段:他坦言在华盛顿的经历让他对罪与傲慢有了新认识,布道反而因此更有力量,甚至将华盛顿与所多玛、蛾摩拉相提并论。
TechCrunch Mobility:机器人对比人类的A/B测试
TechCrunch Mobility专栏聚焦交通未来与AI角色,讨论机器人对比人类的A/B测试。本文解读该实验的背景、测试设计挑战及对出行行业的启示,分析人机协作的边界与评估逻辑。