AGI雏形已现:GPT-6 Astra测试99.9%背后的三块缺失拼图

GPT-6 Astra在抽象推理测试中拿下99.9%,但AGI仍差三块拼图。
文章厘清了AI、AGI与超级智能三个常被混淆的概念:AI是任务边界清晰的具体工具,AGI要求像人一样跨领域学习和自主设定目标,超级智能则全面超越人类。GPT-6 Astra在AIC到AGI-3测试中取得99.9%,证明其在举一反三的抽象推理上接近满分,但作者强调单项测试高分不等于通用智能达成。距离真正AGI,还缺物理世界交互、自主目标设定和持续成长三块拼图。对普通人而言,结论不是恐慌,而是每周花两小时真正上手使用AI工具,在雏形期建立熟悉度,避免在成熟期被淘汰。
AI、AGI、超级智能——这三个词正被全网混着用,但多数人并未真正分清它们的边界。最近GPT-6 Astra在一项名为AIC到AGI-3的测试中拿下99.9%的成绩,让"AGI是否已经到来"再次成为热议焦点。冷静拆解后会发现:我们确实站在了AGI的门口,但门还没打开。
AI、AGI、超级智能:三个词,三种阶段
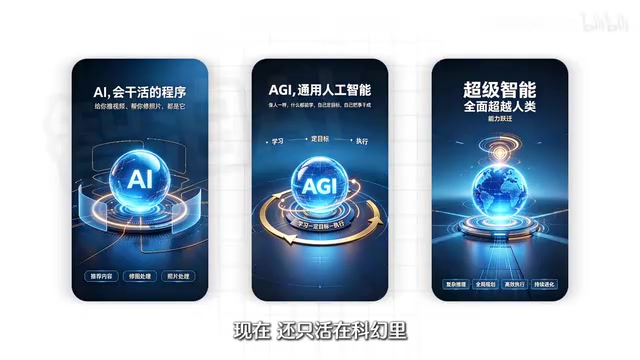
AI是当下最常见的概念,指会干具体活儿的程序——给你推视频、帮你修照片、生成一段文案,都属于AI的范畴。它的特征是任务边界清晰,能力范围可预期。
AGI(通用人工智能)则要求系统像人一样什么都能学,能自己定目标、自己把事干成。它不局限于单一任务,而是具备跨领域的迁移能力。
超级智能是更高一层的想象:全面超越人类,目前只存在于科幻作品中。据B站教程分析,全网炒翻天的讨论其实集中在第二个层次——AGI。
三者并非同一件事的三种说法,而是能力跃迁的三个阶梯。混淆它们,就会误判技术所处的真实位置。
99.9%的测试成绩意味着什么
真正引发震动的是GPT-6 Astra在AIC到AGI-3测试中的表现。这项测试专考"举一反三"——给出从未见过的题目,看系统能否自己悟出规律。这正是人类最引以为傲的认知能力。
AI接近满分,自然会让人追问:AGI是不是来了?
答案需要分层看。测试成绩证明的是模型在抽象推理和模式泛化上的突破,这是AGI的核心能力之一。但一项测试的高分,不等于通用智能的全面达成。
关于AIC到AGI-3这类测试:衡量AI是否具备通用智能,学界通常使用一系列基准测试,如ARC(Abstraction and Reasoning Corpus)、MMLU、BIG-bench等。这类测试的设计逻辑是:题目不依赖训练数据中见过的模式,而是要求系统在少量示例下自行归纳规则——也就是所谓的“少样本泛化”或“分布外推理”。正因如此,它们比传统考试成绩更能反映模型的“举一反三”能力。不过,任何单一基准都存在被“刷分”的风险:模型可能在训练中隐式接触过相似题型,或通过搜索、提示工程等方式绕开真正的推理。因此,一个99.9%的分数,严格来说只说明模型在该测试的题目分布内表现优异,不能直接等同于通用智能。评估AGI需要多维度的测试组合,且要持续更新题库以防止过拟合。
距离AGI还差的三块拼图
清醒版的结论是:AGI的雏形出现了,AGI本身还没到。具体差在哪?至少有三块拼图尚未补齐。
第一块:物理世界
Astra再强,连一杯水都端不起来。机器人那条线才刚起步,具身智能与语言模型的能力之间存在巨大鸿沟。虚拟世界的推理能力无法直接迁移到物理操作上。
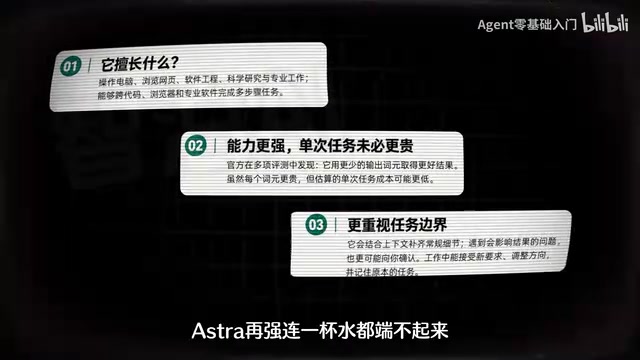
具身智能(Embodied AI) 指的是拥有物理身体、能通过传感器和执行器与真实世界交互的智能系统。它与纯语言模型的根本区别在于:语言模型处理的是符号和文本,而具身智能必须面对重力、摩擦力、物体形状、实时反馈等物理约束。莫拉维克悖论(Moravec's paradox)指出,对AI而言,高级推理反而比低级的感知和运动控制更容易——下棋可以战胜人类,但叠衣服、端水杯却极难。当前机器人学习主要依赖强化学习和模仿学习,在泛化到新物体、新环境时仍十分脆弱。因此,即使语言模型在抽象推理上接近满分,具身智能的进展仍然缓慢,两者之间的能力鸿沟正是通往AGI的关键障碍之一。
第二块:自主目标
当前的"自主"是你给目标、它执行。它不会哪天自己冒出来说"我想干点啥"。真正的AGI需要具备内生目标设定能力,而非被动响应指令。
内生目标设定(Intrinsic Goal Setting) 是AGI定义中一个常被忽视但至关重要的维度。当前的大语言模型本质上是“目标条件化”系统:你给它一个提示或任务,它生成输出;没有外部指令,它不会主动产生意图。真正的自主智能体需要能够根据环境状态、自身知识和长期偏好,自行生成、排序并追求目标。这在认知科学中对应“能动性”(agency)和“意图性”(intentionality)。技术上,这涉及元认知、内在动机、探索与利用的平衡等难题。更深层的问题是:一旦系统能自行设定目标,如何确保这些目标与人类价值观对齐?这不仅是技术挑战,也是AI安全领域的核心议题。
第三块:持续成长
它干完一单,记忆归零。今天的天才,明天失忆。缺乏持续学习和经验积累的机制,意味着系统无法像人一样在时间维度上成长。
这三块拼图对应的是物理交互、目标自主、记忆延续——每一项都直指AGI的定义核心。
持续学习(Continual Learning) 又称终身学习,指模型在不遗忘旧知识的前提下不断学习新任务。当前主流AI采用“训练-部署”分离模式:模型训练完成后参数冻结,推理时不会更新权重,因此每次对话结束记忆便丢失。要实现持续成长,需要解决“灾难性遗忘”(catastrophic forgetting)问题——新数据训练会覆盖旧知识。可能的路径包括:动态网络扩展、记忆回放、参数隔离、以及外部记忆库与检索增强生成(RAG)的结合。但即便技术上可行,持续学习还涉及安全与可控性:一个不断自我更新的系统,其行为边界会随时间漂移,给对齐和监管带来新挑战。
普通人真正该做的事
校准焦虑比消除焦虑更现实。你不需要怕明天就被取代,但要警惕五年后的巨变。
参考智能手机的普及轨迹:从能上网到人人离不开,用了五年。而AI的迭代速度比手机快得多。
普通人现在该做的事只有一件:每周花两小时真上手用这些工具。雏形期你不熟悉它,成熟期它就不需要你了。
这不是危言耸听,而是技术 adoption 曲线给出的朴素提醒——熟悉工具的人,才有资格谈驾驭工具。
常见问题
AGI现在到了吗?
没有。准确说法是AGI的雏形出现了,但物理世界交互、自主目标设定、持续成长三块拼图尚未补齐。
GPT-6 Astra的99.9%成绩说明什么?
说明模型在举一反三的抽象推理测试中接近满分,这是AGI核心能力的突破,但不等于AGI全面达成。
普通人现在应该做什么?
每周花两小时真上手使用AI工具,在雏形期建立熟悉度,避免成熟期被淘汰。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。