AI Agent 工具调用安全网关:Aegotrax v0.2.4 的进化与盲点

Aegotrax v0.2.4 通过服务端意图校验、审批门禁与 schema 锁定,探索 LLM Agent 工具调用的安全边界。
随着 LLM Agent 从问答走向真正执行操作,如何确保每次工具调用都符合用户真实意图成为关键安全命题。开发者将 Aegotrax 迭代至 v0.2.4,针对社区反馈完成了多项安全加固:将意图校验移至服务端防止客户端伪造、引入主机名白名单与 SSRF/IMDS 防护、对 MCP schema 实施锁定与漂移检测,并将原本只记日志的 REQUIRE_APPROVAL 升级为带一次性 token 的真正阻断式审批流。作者同时坦承仍存在盲点——尤其是授权范围内缓慢的数据渗出至今无解。文章最终指向 Agent 安全的本质矛盾:传统 IAM 回答「能否调用」,而意图一致性要回答「是否该调用」,后者无法用权限模型解决,是 Agent 安全基础设施需要重点突破的方向。
当 AI Agent 开始调用工具,安全边界在哪里
随着 LLM Agent 从简单的问答走向真正的「执行者」——调用 API、读取数据库、触发外部服务——一个被长期忽视的问题浮出水面:如何确保 Agent 的每一次工具调用都是用户真正授权的操作?
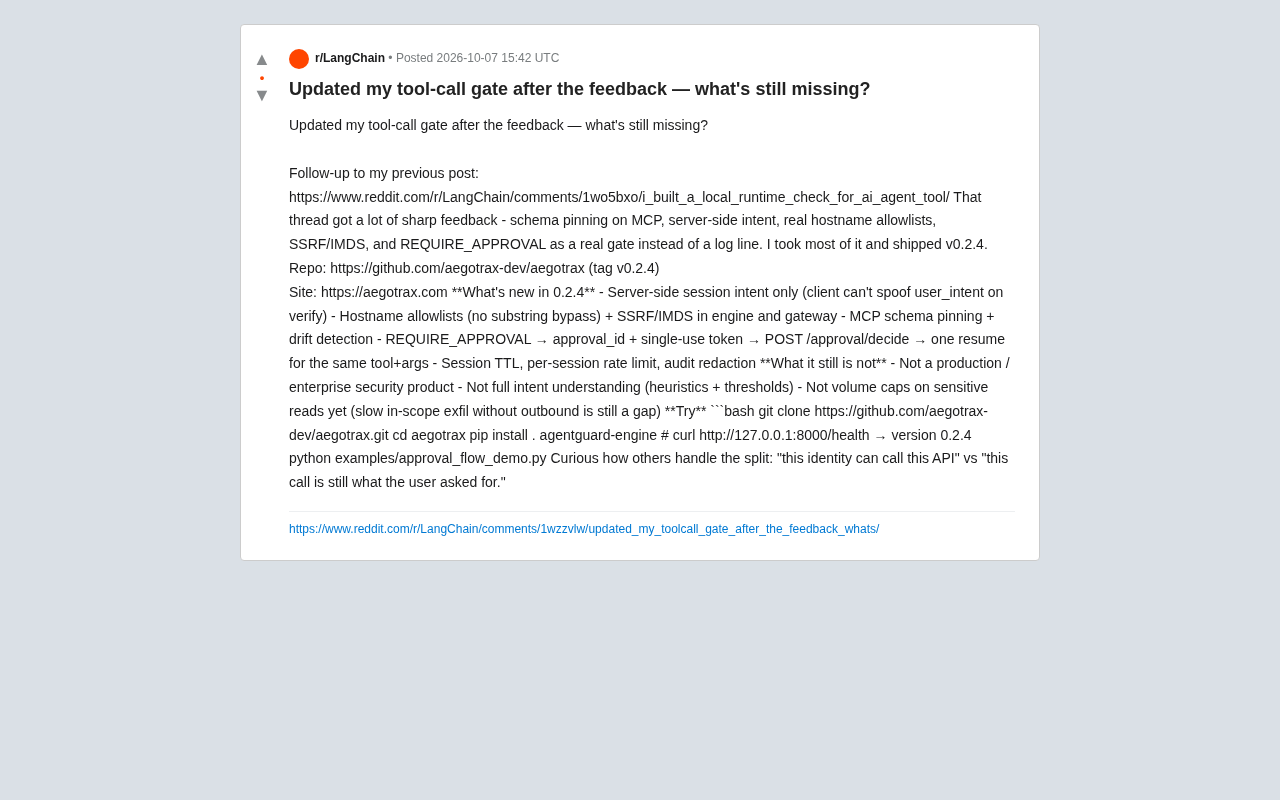
一位开发者在 Reddit 的 r/LangChain 社区分享了他对这个问题的持续探索。继上一篇讨论「本地运行时检查 AI Agent 工具调用」的帖子收获大量反馈后,他基于社区意见迭代出了 Aegotrax v0.2.4,并再次抛出一个核心问题:我还漏掉了什么?
这个项目之所以值得关注,不在于它本身是否成熟(作者坦承它远非企业级安全产品),而在于它清晰地勾勒出了 Agent 时代一个正在成形的安全命题。
v0.2.4 修复了哪些安全漏洞
上一版本收到的反馈相当尖锐,集中在几个经典的安全攻击面上。作者在 v0.2.4 中逐一回应,这份更新清单本身就是一份实用的 Agent 安全加固指南。
防止客户端伪造意图
新版本将会话意图(session intent)完全移到服务端。这意味着客户端在 verify 阶段无法再伪造 user_intent 参数。这是一个关键设计——如果意图校验发生在客户端,恶意调用方只需伪造一个「合法意图」就能绕过所有检查。把信任边界收缩到服务端,是任何安全系统的基本原则。
封堵网络层攻击
v0.2.4 引入了主机名白名单(hostname allowlist),并明确「不做子串匹配绕过」。这个细节很重要:粗糙的白名单实现常用子串匹配,攻击者可以用 evil-trusted.com 这样的域名骗过 trusted.com 的校验。
同时,引擎和网关层都加入了 SSRF/IMDS 防护。SSRF(服务端请求伪造)和对云元数据服务(IMDS,如 AWS 的 169.254.169.254)的访问拦截,是防止 Agent 被诱导去窃取云凭证的标准手段。对一个会主动发起网络请求的 Agent 来说,这几乎是必备防线。
SSRF(Server-Side Request Forgery,服务端请求伪造)是一类经典的网络攻击:攻击者通过构造恶意输入,诱使服务端(这里是 Agent)向攻击者指定的内部地址发起请求。在云环境中,这种攻击最危险的目标是 IMDS(Instance Metadata Service,实例元数据服务)——AWS、GCP、Azure 等云平台均在特定保留 IP(如 AWS 的 169.254.169.254)上提供该服务,用于向虚拟机实例分发临时凭证、IAM 角色信息等敏感数据。一旦 Agent 被诱导访问这个地址,攻击者就能借助 Agent 获取云账号的高权限凭证,进而控制整个云基础设施。对于 LLM Agent 而言,prompt injection 是触发 SSRF 的典型路径:攻击者在 Agent 处理的内容(如网页、文档、数据库返回值)中嵌入指令,驱使 Agent 主动发起恶意请求,整个过程可能完全绕过用户感知。
MCP schema 锁定与漂移检测
针对 Model Context Protocol(MCP),新版加入了 schema pinning + drift detection。Agent 依赖工具的接口定义来决定如何调用,如果底层工具的 schema 在运行时被悄然篡改(drift),Agent 可能被引导执行完全不同的操作。锁定 schema 并检测漂移,是对「供应链式」攻击的防御。
Model Context Protocol(MCP)是 Anthropic 于 2024 年底提出的开放协议,旨在标准化 LLM 与外部工具、数据源之间的连接方式。它的核心设计是:工具以结构化 schema 描述自己的能力和参数格式,LLM 依据这份 schema 决定如何构造调用请求。这种设计提升了工具调用的可组合性,但也引入了新的攻击面——如果工具的 schema 在运行时被悄然修改(schema drift),LLM 会继续信任并遵从新的描述,从而被引导执行完全不同的操作。这类攻击本质上是一种供应链攻击:不攻击 LLM 本身,而是篡改 LLM 所依赖的「说明书」。Schema pinning 的防御思路是在初始化时锁定工具接口的哈希或签名,运行期间持续比对,一旦发现偏差立即告警或拒绝调用,阻断这类「中间人式」篡改。
从日志行到真正的审批门禁
上一版本中,REQUIRE_APPROVAL 只是一条日志记录——它会标记「这个操作需要审批」,但并不真正阻断。社区反馈直指这个痛点:一个只记录不拦截的审批机制形同虚设。
v0.2.4 把它改造成了一套完整的审批流:生成 approval_id 和一次性 token → 通过 POST /approval/decide 做出决策 → 对同一个 tool+args 组合执行单次恢复(one resume)。
这个设计的精妙之处在于「单次使用」和「tool+args 绑定」。审批通过后,token 只能用于那一次特定参数的调用,无法被重放或挪用到其他操作上。配合新增的 会话 TTL、按会话限流、审计日志脱敏,整个门禁系统从「观察者」升级成了真正的「守门人」。
作者坦承的三大盲点
这个项目最可贵的地方,是作者对自身局限的清醒认知。他明确列出了 Aegotrax「还不是什么」:
- 不是生产级/企业级安全产品 —— 仍处于探索阶段;
- 不是完整的意图理解 —— 当前依赖启发式规则加阈值判断,而非真正理解用户意图;
- 尚无敏感读取的流量上限 —— 「缓慢的、范围内的数据渗出(slow in-scope exfil)」在没有外联的情况下仍是一个未解决的缺口。
最后这一点尤其值得玩味。即便所有网络外联都被拦截,一个被攻陷的 Agent 仍可能在授权范围内、以极慢的速度持续读取敏感数据,最终完成渗出。这类攻击因为「每一步都合规」而极难检测,是 Agent 安全领域的真正硬骨头。
核心难题:身份授权 vs 意图一致
作者在帖子结尾抛出的问题,恰恰点中了 Agent 安全的本质分裂:
「这个身份能否调用这个 API」 vs 「这次调用是否仍是用户所要求的」
前者是传统的**身份与访问管理(IAM)**问题,技术已相当成熟——基于角色、权限、API key 做静态授权。但后者是一个全新的命题:Agent 拥有调用某个 API 的权限,不代表它当前这次调用符合用户的真实意图。
一个被 prompt injection 攻陷的 Agent,可能完全在其授权范围内行动,却做着用户从未要求的事。这就是「意图一致性」的核心挑战——它无法用传统的权限模型解决,因为问题不在于「能不能」,而在于「该不该」。
目前 Aegotrax 用启发式规则和阈值来逼近这个判断,但作者自己也承认这远非「完整的意图理解」。这或许正是未来 Agent 安全基础设施需要重点攻克的方向:如何在运行时,持续验证每一次工具调用与用户原始意图的一致性。
Prompt injection 是当前 Agent 安全领域最受关注的攻击向量之一。与传统的 SQL 注入类似,它利用的是「数据」与「指令」边界的模糊:当 Agent 处理来自外部的内容(网页摘要、邮件正文、数据库结果)时,攻击者可以在这些内容中嵌入伪装成用户指令的文本,诱使 LLM 偏离原始任务、执行攻击者指定的操作。间接 prompt injection(indirect prompt injection)尤为隐蔽——攻击者无需直接与 Agent 交互,只需在 Agent 将要访问的数据源中预置恶意指令,等待 Agent 主动「读取」并执行。这正是意图一致性问题的困难所在:被注入的 Agent 所有操作都在授权范围内,从权限模型的视角看完全合规,但执行的却是攻击者的意图而非用户的意图。当前业界尚无成熟的通用防御方案,输入过滤、沙箱隔离、以及类似 Aegotrax 这样的运行时行为校验,均只能部分缓解而无法根除。
对 Agent 开发者的启示
无论你是否使用 Aegotrax,这个开源项目的迭代过程都提供了一份有价值的检查清单。构建会调用工具的 Agent 时,至少应考虑:
- 意图校验是否放在了服务端?
- 网络请求是否有白名单与 SSRF/IMDS 防护?
- 工具 schema 是否可能被运行时篡改?
- 高危操作是否有真正能阻断的审批流,而非仅记日志?
- 是否对敏感数据读取设置了速率上限?
项目已在 GitHub(aegotrax-dev/aegotrax,tag v0.2.4)开源,可通过 pip install . 本地运行体验审批流 demo。对于正在从「能跑」走向「能安全地跑」的 Agent 开发者而言,这类探索值得持续跟踪。
相关推荐

扎克伯格新片口碑两极,微软Surface全押AI开发
扎克伯格新片《The Social Reckoning》口碑两极,烂番茄68分难复刻《社交网络》。微软发布全押AI开发的Surface Laptop Ultra,起售价2600美元;苹果或携手LG进军智能家居。

Nano Banana 2.1 使用教程:在 Google AI Studio 中快速找到并体验
想在 Google AI Studio 里体验超写实图像模型 Nano Banana 2.1,却找不到入口?本教程详解查找路径:进入 Playground,打开右侧模型选择器,点击 Images 标签即可选中这个付费模型,并附人像生成实测效果分析。

Claude Haiku 5.5发布:最便宜最快的小模型来了
Anthropic发布Claude Haiku 5.5,号称最便宜最快最强的小模型。价格比上一代降约75%,输入每百万token仅10美分,计算机使用能力从16%提升至72%,并首次引入effort成本调节设置。