AI Agent vs ChatGPT:从被动应答到自主行动的范式跃迁

AI 正从被动聊天机器人经预设工作流,迈向 LLM 自主决策的真正 Agent。
文章基于 YouTube 科技频道的解析视频,提出 AI 能力的三级框架:Level 1 是被动应答的聊天机器人,决策权完全在人类手中;Level 2 是 AI 工作流,虽能调用工具但路径由程序员硬编码,如同轨道上的火车;Level 3 才是真正的 AI Agent,由大语言模型充当中央大脑,通过 ReAct 框架实现推理与行动交替,能自主拆解任务、调用工具并在失败时迭代纠错。文章以度假防晒霜计算为例展示 Agent 的多步协调能力,同时强调 RAG 只是工作流内部的检索技术而非自主智能体。作者最后指出,Agent 缺乏人类常识且可能陷入无限循环,必须保留人工审批、活动日志和紧急停止按钮,其定位是人类能力增强而非替代。
人工智能正处在一个关键的转折点上。过去我们习惯把 AI 当作"超级百科全书"——问一个问题,得到一个答案;要一封邮件,生成一段文字。但一种新的范式正在成形:AI 不再只是生成内容,而是开始"动手做事"。据 YouTube 科技频道的深度解析视频,2024 年已被业界称为"AI Agent 之年",而理解这一转变的关键,在于厘清聊天机器人、AI 工作流与真正 AI Agent 之间的本质差异。
三级复杂度:从被动应答到自主探索
该视频提出了一个清晰的分级框架:Level 1 是标准聊天机器人,Level 2 是 AI 工作流,Level 3 才是真正的 AI Agent。三者的核心区别不在于模型能力,而在于"谁在做决定"。
Level 1 的聊天机器人建立在大型语言模型之上,擅长生成文本,但本质是被动的——它坐等你的提示词,基于训练数据给出输出。即便现代聊天机器人可以浏览网页或连接基础工具,它们仍需要你逐步指定"浏览什么""用哪个工具",决策权始终在人类手中。
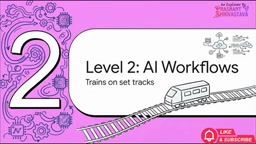
Level 2 的 AI 工作流解决了工具访问问题,但方式很机械。视频用了一个精准的比喻:工作流就像在预设轨道上运行的火车,程序员明确规定"第一步查日历、第二步总结事件、第三步输出结果",系统会完美执行,却无法偏离轨道。如果你问这样一个系统芝加哥的天气,它会直接崩溃,因为它的轨道只通向日历,没有通往天气应用的分支。视频还特意澄清了 RAG(检索增强生成)这一热门术语——它听起来高深,本质上只是工作流内部的一种检索技术,并非自主智能体。只要步骤是人硬编码的,它就是工作流。
真正的 Agent:LLM 成为决策大脑
从工作流跃迁到 Agent 的临界点,是人类决策者被大语言模型本身完全取代。不再是程序员说"先做 A 再做 B",而是 LLM 成为中央大脑,用语言理解能力自行推理、"自言自语"地判断下一步该调用什么工具。
视频中的对比很形象:如果工作流是困在轨道上的火车,AI Agent 就是越野探险者,动态勘察地形并自主寻找最优路线。这种能力的核心是 ReAct 框架——推理(Reason)与行动(Act)交替循环。
视频用一个看似随意的度假规划问题展示了这种能力:"下个月去佛罗里达户外周末旅行,该带几瓶 2 盎司的防晒霜?"这实际上是一个复杂的数学与逻辑问题。Level 1 聊天机器人会直接编造一个随机数字,因为它不知道你的出行日期,无法预测天气,也不掌握健康剂量公式。而 Level 3 的 Agent 会把大问题拆解成可执行的子任务:先访问邮箱获取航班确认信息以确定日期,再调用外部天气 API 获取日照时长,基于 API 数据合理假设你在大部分日照时间处于户外,然后检索健康指南中的涂抹频率,最后调用计算器完成运算。
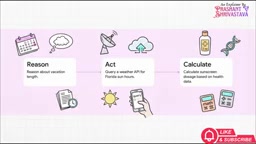
真正体现 Agent 价值的细节在于:当天气 API 报错时,它会观察到这个失败,意识到需要新来源,并自主迭代寻找替代的天气工具。这种"遇到障碍—识别错误—切换策略"的闭环,无需人类干预即可自我修正,被视频称为当前 AI 领域的"圣杯"。
ReAct 框架(Reasoning + Acting)是 2022 年由普林斯顿大学与谷歌研究团队提出的提示工程范式,其核心思想是让大语言模型在推理轨迹与行动步骤之间交替循环。在每一轮中,模型先以自然语言形式输出“思考”(Thought),阐明当前对任务的理解和下一步意图;随后执行“行动”(Action),例如调用某个检索工具、API 或计算器;接着观察工具返回的“结果”(Observation),并据此修正或推进下一步推理。这种“思考—行动—观察”的闭环使模型能够将外部工具的结果动态纳入推理过程,而非一次性生成答案。与传统的思维链(Chain-of-Thought)相比,ReAct 的关键优势在于引入了来自环境的反馈信号,让模型可以在信息不足时主动检索、在工具报错时调整策略。正是这一机制,使得 Agent 能够像前文所述那样在天气 API 失败后自主切换数据源,实现无需人类干预的自我纠错。
人类必须留在回路中
能力越强,风险越大。视频明确强调:Agent 不是魔法,更不会取代人类,这项技术的定位是人类能力的增强。AI Agent 仍然缺乏基本的人类常识,行为可能不可预测,因此人类必须始终充当最终把关者。视频引用 IBM 研究的观点指出,在 Agent 执行高影响动作之前,保持"人类在回路中"是不可妥协的必要条件。
具体的安全措施包括:对数据设置严格权限、保留详细的活动日志以还原 Agent 的"思考过程"、对重大操作要求人工审批,以及最关键的——设置数字紧急停止按钮。
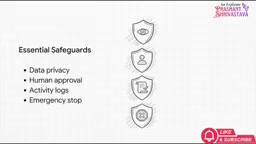
视频特别提醒了"无限反馈循环"风险:Agent 并不总有完美记忆,也不具备无瑕的自主性,有时会反复调用同一个工具卡死。一个陷入循环、不断购买机票的失控 AI,足以在短时间内造成真实损失。这提醒我们,自主性与可控性必须同步设计。
“人类在回路中”(Human-in-the-Loop,HITL) 是人机交互与 AI 安全领域的经典概念,指在自动化系统的决策或执行流程中设置必须由人类参与、审核或批准的环节。在 AI Agent 的语境下,HITL 通常体现为三种形式:一是事前审批,即 Agent 在执行支付、发送邮件、修改数据等高影响操作前必须获得人类确认;二是事中监督,即人类可实时查看 Agent 的推理轨迹与工具调用记录,随时介入或终止;三是事后审计,即通过完整活动日志回溯 Agent 的决策路径。IBM 等机构的研究强调,随着 Agent 自主性提升,HITL 的设计需要从“可选增强”转变为“架构级约束”。这与文章提到的权限控制、活动日志和紧急停止按钮共同构成一套分层防护体系——其本质是在自主性与可控性之间建立可调节的平衡点,而非简单地限制 Agent 的能力上限。
从工具到协作者的距离
这个三级框架的价值在于,它把市场上被混用的"Agent"概念拆解清楚了。很多号称智能体的产品,实际仍停留在工作流层面——有工具调用,但路径由人预设。判断标准很简单:当环境变化、预设路径失效时,系统能否自主找到新路?
对开发者和企业而言,这意味着评估 AI 产品时需要追问决策权归属;对普通用户而言,真正的 Agent 意味着可以把"安排一次咖啡聊天"这类需要多步协调、跨工具操作、应对反复变更的任务整体交出——而不只是让 AI 起草一封邮件。正如视频结尾抛出的问题:看清了"只会写字"和"能在现实世界采取行动"之间的巨大鸿沟后,你准备把哪件复杂耗时的任务,交给你的第一个 AI Agent?
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。