AI Agent成本真相:输入Token才是账单的隐藏大头
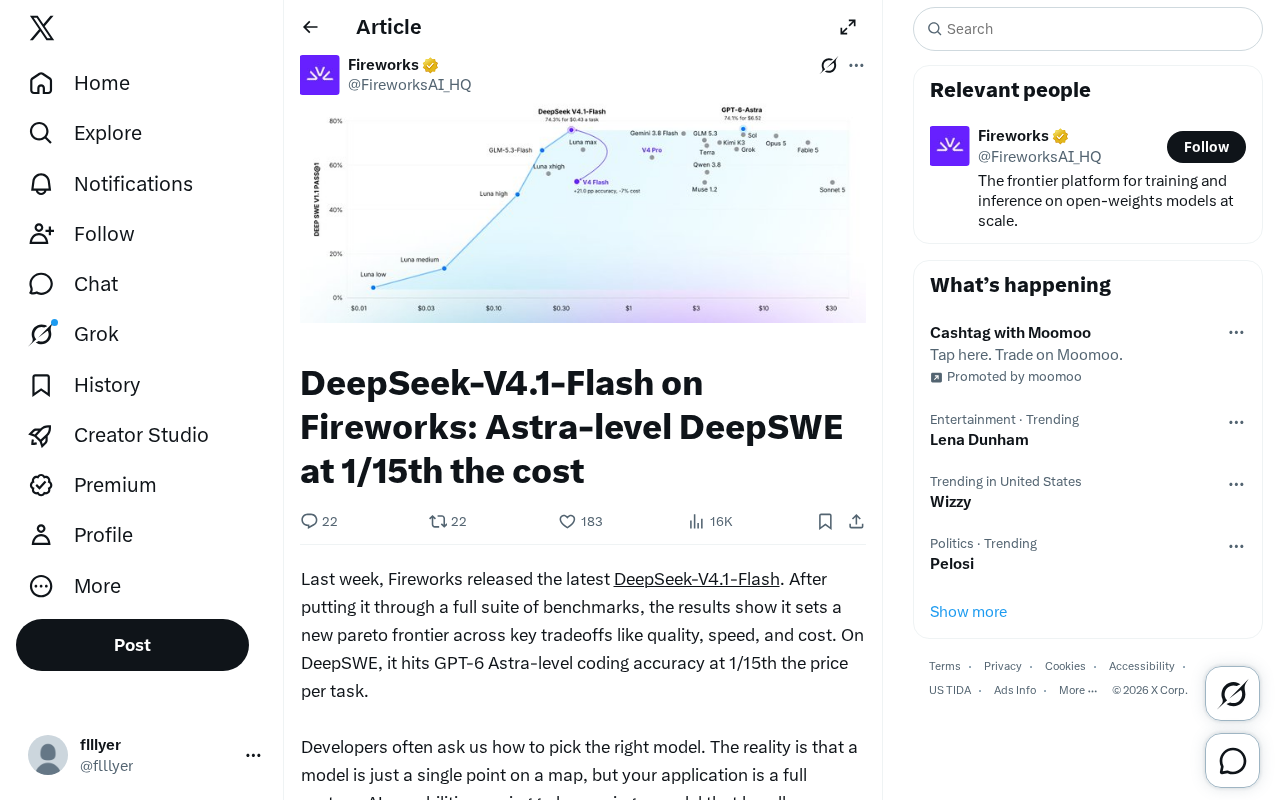
DeepSWE测试揭示AI Agent成本真相:输入Token是输出的174倍,缓存命中占账单60%,方案间成本差距高达15倍。
一项基于DeepSWE基准测试的实验数据颠覆了AI Agent成本的常见直觉。测试发现,Agent运行时输入Token与输出Token的比例高达174:1,根本原因在于Agent每轮推理都需重读庞大的历史上下文与工具返回结果,而真正生成的内容极少。更关键的是,全部输入Token中99.6%为缓存命中,尽管单价较低,这些缓存内容仍贡献了整张账单的60%成本。在任务质量相当的前提下,两种方案的单任务花费相差逾15倍($0.43 vs $6.52)。这说明Agent时代的成本优化,核心战场在缓存机制的定价与效率,而非通常被关注的输出Token,开发者应重新审视账单结构而非依赖传统直觉。
一个被误解的成本假设
谈到AI Agent的运行成本,很多人下意识认为大头在于输出Token(output tokens)——毕竟模型"生成"的内容才是我们真正想要的结果。但一组来自DeepSWE基准测试的实测数据,彻底颠覆了这个直觉。
在一次将DeepSWE分别运行在Astra和DeepSeek V4.1-Flash上的对比实验中,测试方发现:输入Token的数量以174比1的比例碾压了输出Token。换句话说,Agent每生成1个输出Token,背后就要吞掉174个输入Token。这个悬殊的比例,正是理解Agent成本结构的关键。
输入Token为什么这么多
对于编程类Agent(如DeepSWE这类面向软件工程任务的系统)而言,这个比例其实符合逻辑。Agent在完成一个任务时,需要反复读取代码库上下文、历史对话、工具调用返回结果、错误日志等大量信息。每一轮推理,模型都要"重读"一遍庞大的上下文,而真正吐出的决策或代码往往只是寥寥数行。
这种"读得多、写得少"的工作模式,意味着Agent的账单结构与传统聊天机器人有着本质区别。如果沿用"输出为主"的成本直觉去做优化,很可能把力气用错了地方。
这种现象在技术上源于当前主流Agent框架采用的全量上下文传递模式。与人类对话时可以选择性记忆不同,大语言模型本身无状态,每次推理都需要在请求中附带完整的历史信息。在多步骤的软件工程任务中,上下文会随着每一轮工具调用(如读取文件、执行命令、获取错误输出)不断累积:第一轮可能只有几千Token,到第十轮可能已经膨胀至数十万Token,而每一轮新的推理都要把前面所有内容重新打包发送给模型。这一机制被称为"滚雪球式上下文",是Agent与单轮对话在成本结构上产生根本差异的核心原因。部分框架尝试通过摘要压缩(Summarization)或滑动窗口(Sliding Window)来截断历史,但这往往以牺牲任务连贯性为代价,如何在成本与上下文完整性之间取得平衡,仍是Agent工程的重要挑战。
缓存命中:账单里的隐形主角
更值得关注的是缓存(cache)的作用。测试数据显示,在全部输入Token中,99.6%都是缓存命中(cache hits)。这说明Agent处理的上下文中,绝大部分内容是在多轮交互中被重复读取的相同信息。
关键在于:这些缓存命中虽然单价低于常规输入Token,但由于绝对数量极其庞大,它们贡献了整张账单60%的成本。这个数字非常有冲击力——它意味着优化Agent成本的核心战场,既不在输出,也不在"新鲜"的输入,而在如何高效地处理这些被反复读取的缓存内容。
对于开发者和平台方来说,这引出了一个明确的优化方向:谁能把缓存机制的定价和效率做到极致,谁就能在Agent成本竞争中占据优势。
提示词缓存(Prompt Caching) 是当前主流大模型API普遍提供的一项机制。其原理是:当模型接收到的输入前缀与此前某次请求完全一致时,云端可以复用之前已经计算好的KV缓存(Key-Value Cache),跳过重复的注意力计算,从而以更低的价格收费。以Anthropic Claude为例,缓存命中的Token定价约为常规输入Token的十分之一;OpenAI的缓存命中Token则通常按五折计费。对于Agent场景,系统提示词(System Prompt)、工具定义列表、长代码文件等内容在每一轮都保持不变,天然是缓存命中的大户。这也解释了为什么在DeepSWE测试中缓存命中率能高达99.6%——Agent的上下文大部分是"老内容",真正新增的只有最新一轮的工具返回结果和模型回复。理解这一机制,有助于开发者主动设计提示词结构,将稳定内容前置,以最大化缓存命中率。
同等质量下,成本相差15倍
实验最引人注目的结论是成本对比。在任务完成质量相同的前提下:
- Astra方案:$0.43/任务
- DeepSeek V4.1-Flash方案:$6.52/任务
两者相差超过15倍。这个差距并非来自模型能力的高下,而是来自成本结构——尤其是对高比例缓存输入Token的定价和处理方式的差异。
这也说明,在Agent时代评估一个方案的经济性,不能只看模型的表面单价(如每百万Token多少钱),而要结合真实的工作负载特征:输入输出比、缓存命中率、以及缓存Token的实际计费方式。同样能把活干好,账单却可能相差一个数量级。
文中提到的 Astra 是 Google DeepMind 推出的多模态 Agent 框架/平台,专为长时程、多轮工具调用场景设计,在缓存处理和流式推理上做了针对性优化;DeepSeek V4.1-Flash 则是深度求索发布的轻量级高速推理模型,以低延迟和较低的常规Token单价著称。两者在表面定价上的差异并不必然等于实际账单的差异——这正是本文的核心论点:当缓存命中Token占据绝大多数时,缓存的折扣力度和计费粒度才是决定最终成本的关键变量,而非模型官网列出的"每百万Token价格"。这也提示开发者在选型时,应使用接近真实负载的工作流进行端到端成本测算,而非依赖静态价格表做横向比较。
对开发者的启示
这组数据虽然来自单一测试,但它揭示的规律对任何构建Agent应用的团队都有参考价值:
- 成本审计要看结构,而非总量。搞清楚你的Agent账单里,输入、输出、缓存各占多少,才能找到真正的优化杠杆。
- 缓存策略是核心竞争力。当99.6%的输入都是缓存命中时,缓存定价的微小差异会被巨大的数量放大成账单上的鸿沟。
- 别被"输出Token"的直觉误导。对于长上下文、多轮工具调用的Agent工作流,输入端往往才是成本的重心。
需要注意的是,这些结论来自一次特定基准测试(DeepSWE)的对比,具体数字会随任务类型、上下文长度和实现方式而变化。但它至少提供了一个清晰的提醒:在Agent经济学中,直觉常常是靠不住的,数据才是。
相关推荐
百行代码从0手写一个Agent:拆解OpenClaw神话的极简实现
用不到200行代码从0手写一个Agent,拆解OpenClaw、Hermes等智能体的本质。涵盖大模型调用、while循环、history记忆、系统提示词、工具调用与Skill渐进式披露六大核心步骤,附AI应用开发学习路线参考。
4个顶级AI从零打造角斗士游戏:多智能体协作的实战拆解
一位创作者用Fable 5、Opus 5、GPT、GROK四个AI模型协同,从零打造角斗士游戏。本文拆解多智能体协作、独立评审循环、Trippo 3D生成等工作流,以及AI骗过评审的真实失败案例。
AI Agent零基础入门:从大模型认知到智能体开发全景图
AI Agent零基础入门教程:从人工智能、机器学习、深度学习到Transformer与大模型的技术脉络,再到提示词、RAG、MCP、LangChain等Agent开发四阶段学习路线,帮助你系统掌握智能体开发核心技能。