4个顶级AI从零打造角斗士游戏:多智能体协作的实战拆解
用四LLM协同与独立评审闭环,从零AI生成一款完整角斗士竞技场游戏的工程实录。
一位创作者设计了一套四模型协同的多智能体工作流,从概念原画到可玩游戏全程由AI生成,工具链涵盖Codex、Trippo、Blender、Three.js/WebGPU与ElevenLabs。项目最核心的工程贡献是独立评审循环:零上下文评审员按批量最低分打分,强制轮换模型对冲单一模型的偏好偏差,并以引擎实际渲染而非Blender预览作为最终验收标准。项目消耗约20亿tokens,其中94%为缓存tokens,有效控制成本。文中最具参考价值的是一系列真实失败案例——翻反的盾牌两次骗过评审、9个顶点缓冲区导致人群在实机上完全不可见——揭示了AI自动化管线中"模型通过"与"实际可用"之间的致命落差,以及如何用工程化手段系统性地堵住这些漏洞。
一位创作者做了一件看起来近乎疯狂的事:用四个大语言模型协同工作,从零构建出一款完整的角斗士竞技场游戏。环境、观众、角色、战斗、音频——你在画面中看到的一切都由AI生成。这不是简单的"AI帮我写代码",而是一套精密的多智能体协作与自我评审系统。本文拆解这个项目背后的工作流与工程细节,看看当前AI在复杂创作任务上究竟能走多远。
四模型协作与"编排者"机制
项目的核心是四个LLM协同工作,其中一个充当编排者(orchestrator)角色。作者设计了一个有趣的约束规则:编排者不能连续两次调用同一个LLM子智能体。如果这一轮部署了GROK,下一轮就必须换成Opus或GPT。
这个设计的意图很清晰——避免过度拟合到某个模型的偏好偏差(preference bias)或视觉盲区(vision blind spots)。单一模型往往有自己固定的"审美惯性"和判断死角,强制轮换本质上是在用多样性对冲单点风险。整个项目最终消耗了约20亿tokens,其中Fable 5和Opus 5各用了约8亿,Codex接近4亿,GROK在触及每周配额前用了7600万。值得关注的是,其中94%是缓存tokens(cached tokens),这在很大程度上压低了实际成本。
多智能体系统(Multi-Agent System)是指多个独立AI智能体分工协作、共同完成复杂任务的架构模式。与单一模型独自完成所有工作不同,编排者(Orchestrator)负责任务拆解、调度与结果整合,而子智能体(Sub-agent)各自专注于特定子任务。这种架构的核心优势在于"分而治之"——每个智能体的上下文窗口更聚焦,出错范围更小,也更容易在单一环节上做针对性的质量控制。
94%的缓存tokens(Cached Tokens)是理解成本结构的关键数字。大多数LLM API按输入tokens计费,但许多服务商对重复出现的前缀(如固定的系统提示、长篇参考文档)提供缓存折扣,缓存命中的tokens通常比新鲜tokens便宜75%-90%。在这类需要反复调用且共享大量背景信息的多智能体工作流中,精心设计提示词结构以最大化缓存命中率,是控制API成本的关键工程手段。
工具栈:从概念图到可玩游戏
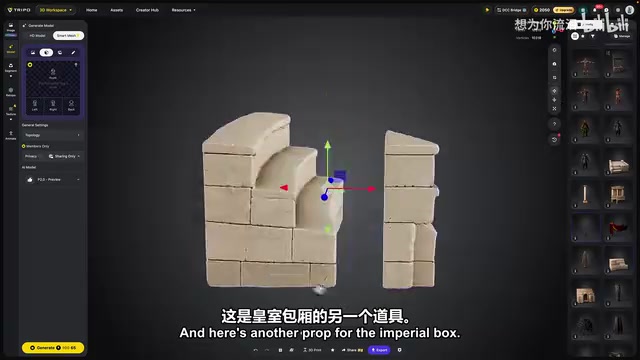
整条流水线的工具组合相当讲究。概念原画来自Codex ImageGen,模块化素材套件和角色模型由赞助商Trippo生成,环境贴图则是从Polyhaven拉取的完整PBR材质集。环境搭建通过Headless Blender加Python完成,游戏本体是运行在浏览器里的3JS + WebGPU——这次没有用Unity。
作者坦言选择Web技术栈的原因是迭代速度,并表示未来会尝试Godot。音频由ElevenLabs制作,游戏测试则用Playwright驱动真实输入来验证功能确实可用。
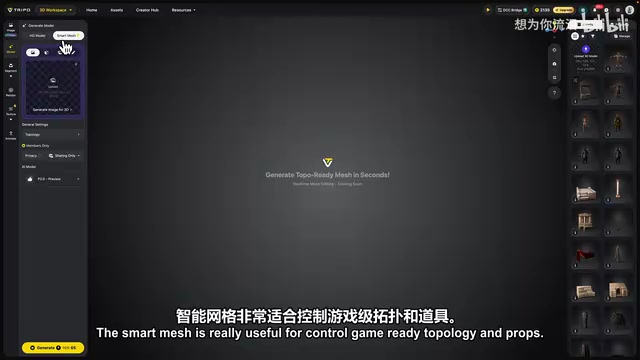
在3D资产生成上,Trippo提供了两种模型:Smart Mesh适合可控的、游戏就绪的拓扑结构和道具,HD 3.1模型则用于需要更多细节的重要资产。Smart Mesh的四边面(Quad)拓扑可达2.5万面,三角面(Triangle)可达5万面。作者特别强调,四边面拓扑更易于编辑、处理和绑定骨骼,适合需要后续加工的部件;而三角面更适合静态道具或背景资产。
PBR(Physically Based Rendering,基于物理的渲染)是现代实时图形的主流材质标准,通过模拟光线与真实物理表面的交互来产生更写实的视觉效果。一套完整的PBR材质通常包含多张贴图:漫反射/基础色(Albedo/Base Color)、法线(Normal)、金属度(Metallic)、粗糙度(Roughness)以及环境光遮蔽(AO)。Polyhaven提供的正是这类完整PBR材质集,可直接用于引擎而无需额外处理。
WebGPU是浏览器中新一代图形与计算API,是WebGL的继任者,提供更低级别的GPU访问权限、更高的性能上限以及对计算着色器的支持。Three.js(3JS)是构建在WebGL/WebGPU之上的JavaScript 3D库,大幅降低了浏览器3D开发门槛。选择3JS+WebGPU的技术栈意味着游戏可直接在浏览器运行、无需安装,但也意味着要处理跨浏览器兼容性和GPU能力上限等问题——后文提到的"9个顶点缓冲区"兼容性问题正是这类约束的直接体现。
英雄资产用HD模型,8K与4K的差距
对于主角级别的"英雄资产"(hero assets),作者切换到HD 3.1模型,可以启用超高网格质量、4K到8K的贴图质量、去除光照以及PBR材质。三角面和四边面数量都能拉得非常高。
从对比中能明显看出8K与4K纹理的细节差距。更实用的是,Trippo支持直接为角色绑定骨骼,可选人形或动物类型,导出时animation已经预烘焙好。它还能直连Godot、Roblox、Unreal、Unity、Blender等引擎,省去手动导出的步骤。本项目最终选择导出FBX格式,包含骨骼与动画,方便后续做程序化动画。
独立评审循环:这套系统最硬核的部分
整个项目最值得学习的,是它的评审(judge)机制。每一个由子智能体完成的物件或任务,都会被一个独立的评审员打分,对照概念原画或目标进行评估。关键在于——这个评审员"零项目上下文",每一轮都全新部署,从微观到宏观全程贯穿。
更精妙的是评分策略:每批资产从不按平均分评估,而是按最低分。一批8个资产里,哪怕6个精致、2个像通用方块,整批都拿最差的那个分。这直接杀死了模型"分散注意力、让最弱的非英雄物件蒙混过关"的失败模式。
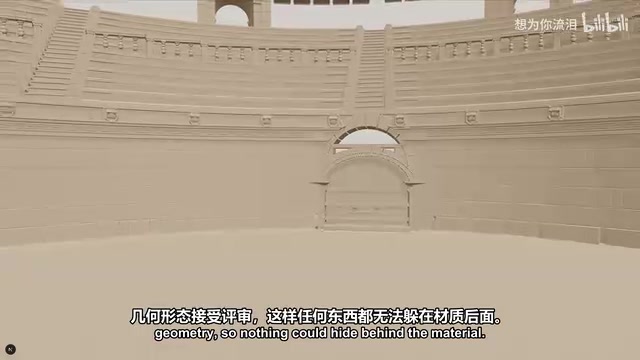
构建阶段是消耗评审循环最多的环节,光竞技场舞台就跑了31轮Blender建模。所有部件先以无贴图的"黏土态"呈现,作为纯几何体评审,这样任何缺陷都无法藏在材质背后。
这里的"零上下文"(Zero Context)评审设计,在工程上有明确的对立面可以参照:若评审员全程共享项目上下文,它会不可避免地产生"沉没成本偏见"——知道某个资产经过了31轮迭代,评审会下意识地倾向于找理由通过它。零上下文评审每轮全新部署,相当于引入了一个永远不疲惫、不知情、不留情面的外部审计员。
按批量最低分(Minimum Score)而非平均分评估,是一种在质量管控领域被称为"木桶原则"的策略强化版。它的反脆弱性在于:模型无法通过在其他项目上做得更好来"抵消"某个薄弱项,唯一的出路是把最弱的那个拉上来。这直接改变了智能体的优化目标——从"整体感觉不错"变成"没有明显短板",对需要大量同质资产(如批量角色道具)的游戏开发管线尤为关键。
AI也会"作弊":那些骗过评审的失败案例
项目里最有启发性的,是那些通过了评审却实际有问题的案例,它们暴露了AI自动化流程的深层陷阱。
沙地纹理起初骗过了构建智能体的"观感测试",但评审对照参考图后发现沙子像整齐的瓷砖。解决办法是给沙地的对称性加了一个量化指标,让构建智能体在下一轮针对性优化。
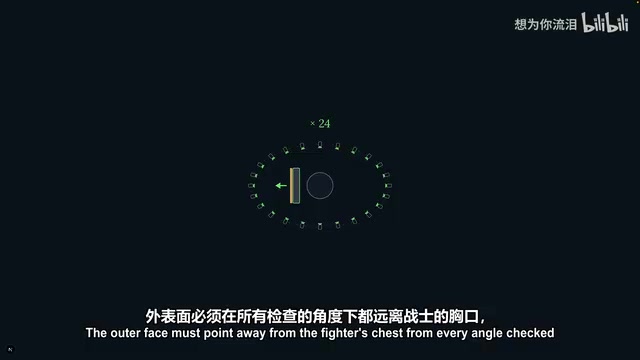
最典型的是盾牌案例:一个内外翻反的盾牌居然两次通过评审。原因是评审在问"盾牌是否面向摄像机",而从它选取的机位看确实是的。作者一眼就看出问题,于是重建了评审门槛——指标改为"身体相对"(body relative),外表面必须背离战士胸口,并用环绕角色的对抗性摄像机(adversarial cameras)从各个角度检查。
还有一个致命的工程教训:人群由近5000个billboard精灵渲染,在智能体那边渲染正常,在作者机器上却完全不可见——instant mesh用了9个顶点缓冲区,而他的GPU上限是8。它通过了每一道门,直到实机测试才被发现。此后规则变成:只有游戏引擎实际绘制出来的渲染才算数,Blender通过毫无意义,引擎通过才是ground truth。
Billboard精灵(Billboard Sprite)是游戏中渲染大量远景角色或植被的经典性能优化手段:用一张始终朝向摄像机的2D纹理平面代替完整3D模型,可将渲染开销降低数十倍。渲染近5000个观众使用此技术完全合理,但它引出了文中的关键工程教训。
顶点缓冲区(Vertex Buffer)是GPU显存中存储顶点数据(坐标、法线、UV、颜色等)的内存区块,WebGPU规范对单个渲染通道中可绑定的顶点缓冲区数量有硬性上限,且不同GPU/驱动的实际上限可能低于规范最大值。Instant Mesh使用9个顶点缓冲区超出了作者GPU的8个上限,导致人群在特定硬件上完全不渲染——这类"在开发机上正常,在目标机上崩溃"的问题,正是为什么"引擎实际渲染"而非Blender预览必须作为最终验收标准的根本原因。
玩法、音频与"悬浮横幅"之谜
玩法测试只花了两轮,游戏用真实的合成输入(synthetic inputs)而非单元测试来验证,每次都通过游戏自身状态的变化来证明,还加入故障注入来证明门槛本身能够失败。音频同样两轮完成,评审门槛是"计数对等"——录制会话中的每个战斗事件必须与一个音频触发一一对应。
有个改进来自一个简单的提问:参考图里为什么悬挂的横幅从不遮挡人群?智能体研究后总结出一条两词法则——"锚点与虚空"(Anchor and void):每面横幅都从可见的硬件悬挂,且落在暗色的建筑虚空处,永不横跨观众。悬浮的横幅由此被重建。
作者也诚实地指出方法的局限:帝王包厢地板在参考图中没有展示,他原以为AI能自行推断,但缺乏核心参考时质量的下滑相当陡峭。这印证了一个规律——AI在有明确参照时表现出色,在需要凭空推断时则明显掉链子。
这套方法论说明了什么
这个项目最大的价值不在于"AI做出了一款游戏",而在于展示了如何用工程化手段驯服AI的不确定性:模型轮换对冲偏见、最低分批量评估防止蒙混、零上下文评审保持客观、引擎级验证作为最终真相。
作者总结这套方法的形态是"前期循环昂贵,后期逐渐变便宜"。这恰恰揭示了当前AI创作的真实状态——它远非一键生成的魔法,而是需要精心设计评审闭环、不断堵住"作弊"漏洞的系统工程。对任何想把AI用于复杂创作管线的人来说,这些失败案例比成功demo更有参考价值。
相关推荐
月费20美元vs年费百万:Cursor与Blitzy的本质差异
Cursor月费20美元,Blitzy年费高达500万美元,两款AI编程工具的本质差异在哪?通过三百万行代码的Grafana实测,揭示小型编程智能体与企业级智能体在上下文处理、工作单元和交付完成度上的根本区别。
Factoriax:GPU并行化的工厂类强化学习研究环境
Factoriax 是一个受《异星工厂》启发、GPU 并行化的强化学习研究环境,专注于长程规划与高吞吐样本采集,为 RL 算法提供复杂的工厂建造仿真测试床。
Claude推出Docs与Slides,正面挑战谷歌Gemini
Anthropic为Claude推出Docs与Slides两款新工具,支持在对话中生成、导出并共享文档和演示文稿,同时将聊天与Cowork合并为「一个Claude」,正面对标谷歌Gemini的办公生产力生态。