AI Agent调试盲区:为什么Bug根因常常不在Trace里?

AI Agent调试的最大盲区:Bug根因往往根本不在trace记录里
这篇文章围绕AI Agent调试中一个普遍却常被忽视的痛点展开:开发者往往手握详尽的调用链路trace,却发现真正的Bug根因藏在trace之外——配置变更、权限差异、缓存过期、数据库状态变化或外部API行为异常等。文章提出了一个关键区分:「证据被埋藏」(数据存在但难以定位)与「证据从未被记录」(覆盖盲区)是两种性质截然不同的调试困境,后者在Agent系统中尤为常见。文章分析了Agent系统特别容易踩坑的三个原因——外部依赖的不可见性、配置与权限的静默漂移、环境状态的时间性,并给出了识别「找错了地方」的三个实用信号。最终指向一个工程结论:健壮的Agent可观测性应主动快照外部上下文,将「未记录」的盲区转化为「可查找」的埋藏证据。
一个让开发者头疼的调试问题
当你排查AI Agent的诡异Bug时,是否遇到过这样的情况:你手握一份看似非常详尽的调用链路(trace),逐行分析、反复推敲,最终却发现真正的问题根本不在这份记录里?
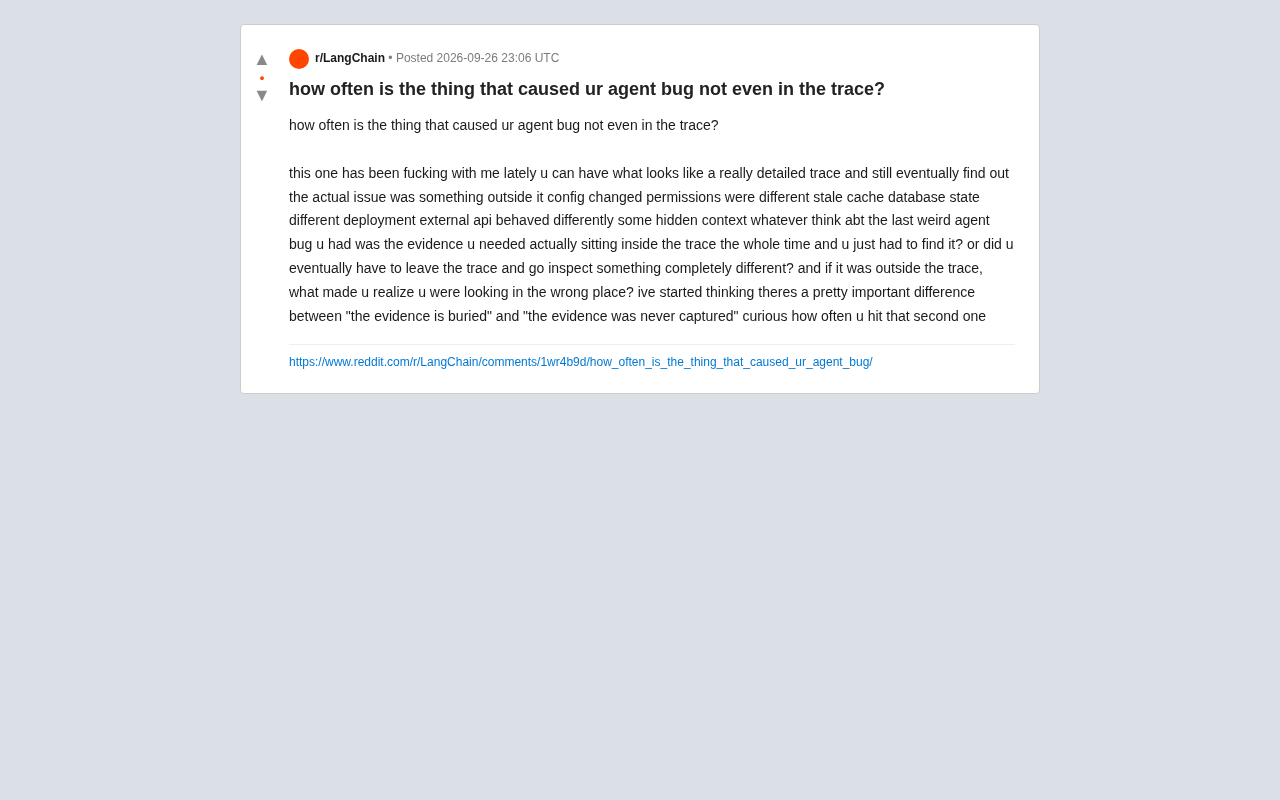
这个话题最近在Reddit开发者社区引发了不少共鸣。一位开发者直言,这件事「最近一直折磨着我」——你可以拥有一份看起来极其详细的trace,但最终却发现真正的问题出在链路之外:某个配置被改了、权限设置不同、缓存过期、数据库状态变化、部署环境差异、外部API行为异常,或者某些隐藏的上下文……总之,是那些trace根本没有捕获到的东西。
「证据被埋藏」还是「证据从未被记录」
这条讨论中最有价值的洞察,是提出了两种截然不同的调试困境之间的关键区别:
- 证据被埋藏(the evidence is buried):你需要的线索其实一直就躺在trace里,只是被大量的信息淹没了,你需要做的是耐心地把它挖出来。
- 证据从未被记录(the evidence was never captured):你需要的线索压根就不在trace里,无论你怎么翻找都不可能找到,因为系统从一开始就没有采集这部分信息。
这两者的性质完全不同。前者是可观测性的信噪比问题——数据齐全但难以定位;后者是可观测性的覆盖盲区问题——数据本身就缺失。对于AI Agent这类高度依赖外部环境和动态上下文的系统,第二种情况可能比我们想象的更常见。
为什么Agent系统特别容易踩这个坑
传统软件的执行相对确定,输入输出可控。而AI Agent的运行往往交织着大量外部依赖和隐性状态:
外部依赖的不可见性
Agent频繁调用外部API、访问数据库、读取缓存。这些外部系统的行为变化——API返回格式微调、数据库中某条记录被改动、缓存命中了过期数据——通常不会完整地反映在Agent自身的trace中。你看到的可能只是「调用了某个工具、返回了某个结果」,却看不到那个结果背后隐藏的环境真相。
从可观测性工程的角度看,这个问题本质上是「分布式追踪覆盖边界」的问题。主流的追踪框架(如 OpenTelemetry)通过在代码中埋点来生成 Span,这些 Span 只能记录「你明确告诉它记录什么」。当 Agent 调用外部工具时,追踪系统通常只会记录调用开始时间、结束时间和返回的顶层结果,而不会自动捕获那个外部服务内部的状态变化。更棘手的是,很多外部 API 会在不通知调用方的情况下悄悄改变行为——比如分页逻辑调整、字段格式变更、限流策略收紧——这些变化在 HTTP 层面可能仍然返回 200 OK,但实际内容已经不同。这意味着仅靠 Agent 侧的 trace,系统性地存在一类「行为变了但记录显示正常」的盲区。
配置与权限的静默漂移
发帖者特别提到了「配置改动」和「权限差异」。这类问题最阴险的地方在于它们是静默的:没有报错、没有异常日志,Agent只是「表现得不太一样」。当trace只记录了逻辑流程而没有快照当时的配置与权限上下文,这些根因就成了永久的盲区。
「配置漂移(Configuration Drift)」是 DevOps 领域的一个经典概念,指系统在多次手动变更后,实际运行状态与预期配置之间逐渐偏离的现象。在传统 Web 服务中,这类问题通常会通过明确的错误码(如 403 Forbidden)暴露出来,比较容易定位。但在 AI Agent 场景下,权限或配置的细微差异往往不会触发硬性报错,而是以「模型做了不同的决策」或「工具调用返回了不同的数据子集」等形式悄然改变输出结果。Agent 的输出天然带有一定的不确定性,这反而给配置漂移提供了很好的掩护——开发者很难区分「这是模型的正常随机性」还是「这是某个配置悄悄被改动了」。将关键配置和权限范围作为 Span 属性快照进 trace,是防御这类问题的有效手段之一。
环境状态的时间性
缓存、数据库、部署版本这些状态是随时间变化的。当你事后回看trace时,环境可能早已改变,导致你无法复现,也无法从记录中还原当时的真实状态。
如何判断自己「找错了地方」
发帖者抛出了一个很实际的问题:如果根因在trace之外,是什么让你意识到自己一直在错误的地方找?
通常有几个信号值得警惕:
- trace内部逻辑完全自洽,每一步看起来都「正确」,但整体结果却是错的——这往往暗示问题出在输入或环境层面,而非逻辑层面。
- 无法稳定复现:同样的代码、同样的输入,有时对有时错,强烈指向外部状态(缓存、数据库、并发)在作祟。
- 多环境表现不一致:本地正常、线上异常,几乎必然是配置、权限或部署差异,而这些恰恰是应用层trace最容易忽略的维度。
当你发现trace里的一切都「说得通」却依然解释不了Bug时,就是该跳出trace、去检查外部世界的时候了。
对可观测性设计的启示
这场讨论指向了一个更深层的工程命题:Agent的可观测性不应止步于执行链路本身。
真正健壮的追踪系统,需要在关键节点上快照更广的上下文——调用外部API时记录完整的请求与响应、访问数据库时标注读取的数据版本、执行时快照关键配置与权限状态。换句话说,要主动把「容易成为盲区」的外部因素纳入采集范围,把「证据从未被记录」的情况尽量转化为「证据虽被埋藏但可被找到」。
因为在调试的世界里,最难解决的从来不是那些被埋得很深的线索,而是那些从一开始就不存在的线索。
这一思路与近年来兴起的「宽事件(Wide Events)」或「结构化日志」理念高度契合。传统观测以指标(Metrics)和链路(Traces)为核心,记录的是「发生了什么动作」;而宽事件主张在每个关键节点将尽可能多的上下文信息聚合进单条记录,包括调用时的环境变量快照、当前用户权限集合、依赖服务的版本号等。对于 AI Agent,这一理念尤为重要——因为 LLM 的决策路径难以用固定的代码流程图描述,外部上下文对最终行为的影响权重远高于传统确定性程序。Honeycomb 等工具在这一方向上有较多实践积累,值得关注。当然,更宽的事件意味着更高的存储成本,工程上需要在覆盖深度与采集开销之间做合理权衡。
结语
这条来自Reddit的讨论没有给出标准答案,但它精准地戳中了每个Agent开发者都会遇到的痛点。它提醒我们:一份「看起来很详细」的trace,并不等于一份「捕获了真相」的trace。在构建和调试AI Agent时,比起埋头分析现有记录,或许更该经常问自己一句——我需要的证据,到底有没有被记录下来?
相关推荐

OpenAI全量推送GPT-6与Intelligent UI:ChatGPT告别纯文本
OpenAI向全部ChatGPT用户推送GPT-6模型,并上线Intelligent UI智能界面,可动态生成按钮、滑块与交互图表。本文解析双旗舰下放策略、交互革命及三大使用边界。

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。