智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进

YC分享会揭示:Harness底座设计比模型权重本身更能决定AI智能体的实际性能上限。
YC在"Harness Night"技术分享会上提出,同一个模型仅凭不同的Harness(智能体底座/脚手架)设计,就能让ARC-AGI成绩从30%跃升至95%甚至100%,证明"包裹层"的重要性远超通常的认知。分享会梳理了Harness从2019年V0朴素循环、经过六年静态功能堆叠(Few-shot、CoT、工具调用、多智能体)到今天自改进Harness(DSPy、Darwin Gödel Machine、Continual Harness)的完整演进脉络。Prime Intellect用冯·诺依曼计算机类比加了Harness的LLM系统,强调上下文管理与"智能体式垃圾回收"的关键作用。工程落地层面,OpenJarvis展示了本地化部署实现约800倍成本降低的路径,YC自研的QM则以极薄Harness和集中式会话管理为核心,揭示了自动改进循环需要人类在环、特权信息泄漏等真实落地挑战。
当大多数人还在追逐更大、更聪明的模型时,YC在一场名为"Harness Night"的技术分享会上提出了一个颇具冲击力的观点:真正拉开智能体能力差距的,往往不是模型权重本身,而是包裹在模型外层的那套"底座"(Harness)。
这个被不少研究者轻视为"只是提示工程""只是脚手架"的东西,到底有多重要?YC给出的数据相当直接——在ARC-AGI这类衡量流体智能的基准上,同一个模型,仅靠不同的Harness设计,成绩就能从30%跃升到95%甚至100%。
Harness为什么值得被当作研究对象
Harness长期被学术圈当作"上不了顶会的二流工作"。社交媒体上甚至有人直言"上下文工程不是一个研究问题"。但YC用一组数据反驳了这种偏见:Harness 1和Harness 2之间,可以带来18%的性能提升。
以ARC-AGI为例,这个基准的核心价值在于考察模型适应新问题、新分布的速度——即所谓的流体智能。Claude Opus在私有holdout集上原生验证的最佳成绩是30%,而加上适当的Harness后,Prime Agent做到了95%,NVIDIA的ABO甚至达到了100%。
这背后反映了一个更深层的问题:当前的进步过度集中在"把模型IQ往上推"这个维度,却几乎没有充分利用测试时经验(test-time experience)。我们生成了大量测试时的交互数据,但面对新领域时,模型并不能快速适应。从ICL(上下文学习)到LoRA小秩、大秩,再到SFT,我们被迫在一套割裂的训练流程之间切换。而Harness,恰恰是在这个"快速适应"的缺口上发挥作用。
ARC-AGI(Abstraction and Reasoning Corpus for Artificial General Intelligence) 由François Chollet于2019年提出,是目前公认最难被"刷榜"的AI基准之一。它的每道题都是一个视觉模式变换谜题,要求模型从极少量示例(通常2-5个)中归纳出抽象规则并应用到新情况。与依赖大量预训练知识的问答基准不同,ARC-AGI的题目被刻意设计成在训练数据中从未出现过的新分布,因此单纯靠记忆无法取巧。Chollet将其定性为衡量"流体智能"(fluid intelligence)的工具——即面对全新问题时快速建立心智模型的能力,而非"晶体智能"(crystallized intelligence,即已储存的知识)。正因如此,它成为检验Harness真实效用的理想试验场:在这里,模型权重里储存的知识优势被大幅压缩,Harness对测试时推理过程的组织能力就变得格外凸显。
从V0到V1:静态Harness的六年演进史
YC梳理了一条从2019年GPT-2至今的Harness发展脉络,这段历史对刚入行的从业者尤其有价值。
V0:最朴素的循环
最初的Harness极其简单——一个"while not end-of-sequence"的循环加上top-p采样,再加一个环境。没有工具调用,没有技能,什么都没有。以经典的GSM8K数学题为例,系统提示设定persona("你是一位数学老师"),给出题目,模型直接输出答案,对就+1,错就-1。
功能逐步注入的静态Harness
过去六年,本质上是在不断往这个静态框架里塞功能:
- Few-shot(2020):把示例放进上下文帮助学习
- Chain-of-Thought:把计算逻辑摊开到更多token上,而非直接预测答案
- WebGPT / Toolformer:赋予模型工具调用能力,本质是一个指定好的JSON对象
- MemGPT:让模型能对自己的上下文做增删改查(CRUD),而非只能append
- Voyager:把工具链条固化、蒸馏回系统提示,这就是"技能(skill)"的雏形
- ReAct / Self-Refine / Reflection:引入多角色智能体,在环境反馈下自我改进
再往上,就是能递归派生子智能体的RLM(递归语言模型)和主编排智能体。YC把这一整套不改进系统提示、不更新Harness自身的架构,统称为Harness V1:它包含智能体规格、系统提示、轮次与工具调用上限、工具列表、技能列表、子智能体列表,外加一个循环和上下文编译机制。
自改进Harness:最激动人心的前沿
过去半年真正的突破,在于让Harness自己学习——要么学系统提示,要么学Harness代码本身,后者"非常trippy(颠覆认知)"。
- DSPy(Demonstrate-Search-Predict):用一小组样本,通过遗传编程式的候选合并与评估,学出最优系统提示
- Darwin Gödel Machine:更进一步,允许智能体修改Harness代码本身。维护一个由"Harness+系统提示"组成的智能体档案库,采样、评估、回填,循环往复,越来越强
- Continual Harness:在记忆分类上做了更细的划分,并引入DAgger式的在线学习,直接在测试时对权重文件做更新——这被YC视为一个极其重要的研究方向
DAgger(Dataset Aggregation) 是Ross等人2011年提出的一种模仿学习算法,核心思想是:在测试时收集模型真实遇到的状态分布,并将专家标注反馈持续追加到训练集中,从而弥合"训练分布"与"真实执行分布"之间的协变量偏移(covariate shift)问题。传统监督学习只用离线数据训练一次,模型一旦在测试时犯错就会进入从未见过的状态,错误会级联放大;DAgger通过在线迭代收集让模型始终在"自己真实走过的路径"上被纠正。Continual Harness将这一思路引入智能体场景:每次测试时的交互都成为新的训练信号,权重文件在运行过程中被直接更新,实现了真正意义上的"边用边学"。这与传统的离线微调(SFT)和固定上下文学习(ICL)形成本质区别,也是YC将其视为重要研究方向的原因——它有望填补"快速适应新领域"这一当前LLM系统的核心缺口。
Darwin Gödel Machine 的命名来自两个典故的合并:达尔文的进化选择机制(通过变异与筛选持续优化)和哥德尔机(Jürgen Schmidhuber 2003年提出的自修改程序理论框架,允许智能体在有形式化证明更优的前提下重写自身代码)。现实中的Darwin Gödel Machine以更实用的方式实现了这一理念:用采样、评估、回填的进化循环代替严格的形式证明,使智能体能在无需人工干预的情况下持续改写并优化自身的Harness代码。
Prime Agent:把LLM当图灵机,把Harness当冯·诺依曼计算机
Prime Intellect的Seth提出了一个精妙的类比。裸LLM更像一台图灵机:有一条带子、一堆指令,执行操作后输出。而加了Harness的系统更像冯·诺依曼计算机——能对外部存储做读写,从而在一类问题上远比图灵机更有表达力。
Seth把上下文管理类比成计算机的缓存层级:模型权重是L1(最快但更新昂贵),活跃输入上下文是中间层,文件系统/REPL/子智能体则是L2、L3的调度状态。关键在于,超出上下文窗口后,不能只做compaction(压缩),还要考虑如何更新和删除状态——他称之为"智能体式垃圾回收"。
Prime Agent在ARC-AGI上用GPT系列拿到约78%,用Opus拿到95.5%。对比之下,一些流行的Harness(如Hermes Agent)"很快烧掉了5000美元却没多少性能提升",这凸显了性价比的重要性。Seth特别强调长时程评估应该看"实用平台期"——在多投入多少测试时token后才只剩边际收益。他们还流式运行了一个持续七天、动用633个智能体、消耗2300万输出token的Factorio式实验,最关键的发现是:模型不会卡住,能持续推进技术树。
本地化与工程落地:OpenJarvis与QM
除了纯研究,这场分享会还展示了两个工程方向。
斯坦福的John展示了OpenJarvis——一个几乎完全在本地设备运行的个人AI栈。核心论点是:本地LLM只落后前沿6到12个月,如今的Qwen 3 32B级别模型已能接近此前Claude Opus的水平。通过让云端LLM去"优化"本地栈的配置(而非在推理时承担云端成本),OpenJarvis实现了约800倍的成本降低和显著的延迟优化。
YC自家的QM则是一个面向真实办公场景的开源智能体Harness。它经历了从2025年初"通用智能体"、到接入Slack和Cron、再到每位员工专属助手的完整演化。QM的设计哲学值得玩味:
- 把"大脑"从沙盒里拎出来:所有会话卸载到Postgres集中管理,沙盒从"智能体的家"变成"按需取用的资源"
- 保持Harness极薄:核心只有三个工具——远程沙盒执行、对象存储读写、发布内部应用
- grind工具:给任务设置时间或token预算,禁止智能体过早放弃,显著提升了研究输出质量
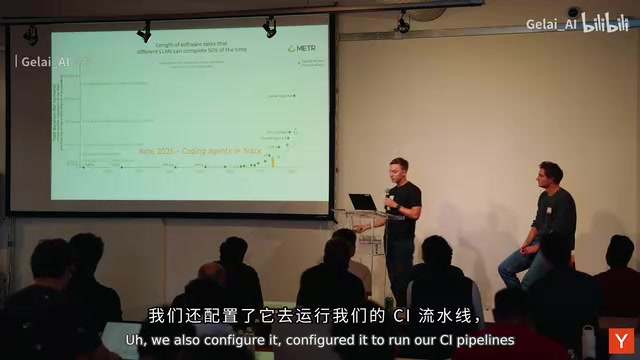
QM团队也坦诚了踩过的坑:LLM-as-judge的自动改进循环会产生"主角综合征"——智能体只看到"大象的局部"就动手修复,因此人类在环仍不可或缺;此外,智能体缺乏社交语境理解,特权信息极易泄漏,这意味着"能放进大脑的信息,实质上被权限系统的好坏所限定"。
Qwen 3 32B 是阿里巴巴通义千问广告团队于2025年发布的开源大语言模型,参数量32B,支持混合思维模式(可切换"思考模式"与"非思考模式")。在多个公开基准上,其性能已接近此前的Claude Opus 3水平,而推理成本仅为闭源前沿模型的几十分之一。对本地化部署而言,32B参数量在单张或双张消费级/专业级GPU(如RTX 4090、A100)上即可运行量化版本,使个人或小团队无需依赖云端API就能获得接近顶级的模型能力。OpenJarvis的核心论点——"本地LLM只落后前沿6到12个月"——在这一代模型发布后得到了有力佐证:当开源模型与闭源前沿的差距从能力维度上快速收窄,本地化部署的成本与隐私优势便开始在实际工程决策中占据主导地位。
写在最后
这场分享会传递的核心信号很清晰:在模型能力指数级增长的大背景下,Harness正从"脚手架"演变为一种智能体操作系统。无论是追求最强ARC-AGI成绩的Prime Agent,还是追求本地化省钱的OpenJarvis,抑或追求企业落地的QM,它们都在回答同一个问题——如何用更好的底座,把模型里"尚未被利用的那部分智能"释放出来。对于构建者而言,一个可行的启发是:让你的Harness在某些能力上略微超前于当前模型,这样才能收集到优质的推理轨迹,并借此把自己"bootstrap"到更高的性能台阶。
相关推荐
2026诺贝尔化学奖解读:手性放大背后的化学革命
2026年诺贝尔化学奖授予亨利·卡根与左右田健次,表彰其在不对称有机合成中发现非线性效应与自催化。本文解读手性分子、不对称催化及63万倍手性放大实验的科学意义。
诺贝尔化学奖得主硖合宪三:手性之谜与生命起源
诺贝尔化学奖得主硖合宪三接受电话采访,谈及其发现的硖合反应如何满足Frank判据、揭示分子手性起源,为地球生命起源这一世纪难题提供关键实验证据。
2026诺贝尔化学奖:破解分子手性之谜
2026年诺贝尔化学奖授予亨利·卡根与硕井健三,表彰其在不对称有机合成中发现非线性效应与自催化反应。本文解读手性、放大效应及其对制药与生命起源研究的意义。