AI Agent记忆设计实战:4.5小时工作坊拆解持久化记忆难题

Agent记忆的核心不是存聊天记录,而是有策略地保留、检索、整合与遗忘。
本文介绍了一场由Oracle的Nacho Martínez Rincón主讲的4.5小时线上工作坊,主题是LangChain、LangGraph等框架下Agent持久化记忆的设计与实现。文章指出,Agent记忆的真正挑战在于上下文窗口的稀缺性:记忆越多越容易过载,越少则跨会话连续性越差。工作坊覆盖跨会话持久化、记忆提取与检索、记忆整合与遗忘、上下文窗口负载管理四个环节,实操基于Python和Oracle Agent Memory Package,无需Oracle前置经验。参与者可获得代码、notebook和录像。文章最后强调,把"遗忘"列为正式议题,反映出Agent记忆工程正从"尽量多存"转向"有选择地管理"。
为什么Agent的记忆不只是存聊天记录
给Agent加记忆,很多人的第一反应是把对话历史塞进向量库。但据Reddit上发布的一场实战工作坊介绍,真正的挑战在于判断:哪些信息该保留、哪些该检索、哪些该更新、哪些该遗忘。这场由Oracle的Nacho Martínez Rincón主讲的4.5小时线上工作坊,主题正是围绕LangChain、LangGraph等框架下的Agent持久化记忆展开。
这个问题的本质是上下文窗口的稀缺性。Agent每轮推理都要携带记忆,记忆越多,上下文越容易过载;记忆越少,跨会话的连续性就越差。工作坊把「在不过载上下文窗口的前提下管理记忆」列为独立议题,说明单纯扩大上下文并不是解法。
上下文窗口指大语言模型单次推理能够处理的token数量上限,包括系统提示、对话历史、检索到的记忆和当前用户输入。主流模型的上下文窗口从早期的4K、8K扩展到如今的128K甚至1M token,但扩大窗口并不等于解决记忆问题:一方面,填入无关内容会稀释模型对关键信息的注意力(即"lost in the middle"现象);另一方面,更长的上下文意味着更高的推理成本和延迟。因此,Agent记忆系统的设计目标是在有限的上下文预算内,只放入与当前任务最相关的信息,而非把所有历史都塞进去。这也是为什么记忆的检索、整合和遗忘策略与存储本身同等重要。
工作坊覆盖的五个记忆环节
根据组织者公布的大纲,内容覆盖从存储到遗忘的完整链条:
跨会话持久记忆的构建
让Agent在两次会话之间保持状态,是持久化记忆的第一层。这涉及的工程问题包括存储选型、读写时机和数据模型设计。工作坊会用到Oracle Agent Memory Package与Oracle AI Database做Python实操,且明确说明不需要事先有Oracle工具经验。
记忆的提取与检索
存下来的记忆不等于能用的记忆。如何从大量历史中抽取与当前任务相关的片段,是检索层的核心。这一环节直接决定了Agent的回答质量——检索偏了,后续推理再强也无济于事。
记忆的整合与遗忘
这是多数教程容易跳过的一环。记忆整合指把零散信息归纳成更高层的认知,遗忘则是有策略地丢弃低价值内容。两者共同控制记忆库的膨胀速度,也影响检索精度。
记忆整合(memory consolidation) 借鉴了认知科学中的概念,在Agent语境下指将多条零散、重复或低层次的经验归纳为更精炼的高层表示。例如,把"用户周一提到喜欢科幻"和"用户周三提到看过《三体》"整合为"用户偏好科幻文学"。常见实现方式包括周期性摘要、实体/事实抽取后写入结构化记忆库、以及基于相似度的聚类合并。整合能显著降低记忆条目数量、提升检索信噪比,但也带来信息损失的风险——过度压缩可能丢掉对特定任务有用的细节,因此需要在压缩率和保真度之间权衡。
记忆遗忘在工程上通常通过几类机制实现:基于时间衰减的权重(越久远的记忆检索优先级越低)、基于访问频率的淘汰(类似LRU缓存策略)、基于重要性评分的裁剪(由模型或规则判断某条记忆是否仍有价值),以及显式的过期与删除策略(如临时性任务上下文在任务完成后清除)。遗忘的反面是记忆库无限膨胀,导致检索变慢、噪声增多、存储成本上升。与向量库"只增不删"的默认模式相比,引入遗忘策略意味着记忆系统需要维护元数据(时间戳、访问计数、重要性标签),这也对数据模型设计提出了额外要求。
上下文窗口的负载管理
即使记忆库设计合理,塞进上下文的量仍需控制。工作坊把这一项单独列出,暗示实践中常见的失败模式是:记忆系统建好了,但每次调用都灌入过量内容,导致模型注意力被稀释。
实操路线与受众定位
工作坊以Python代码为主线,参与者会拿到可运行的代码、notebook以及完整录像。这种交付形式对自学者比较友好——4.5小时的直播难以全程跟完,录像和代码可以事后复现。
从技术栈看,内容面向已经在用LangChain、LangGraph或其他Agent框架的开发者。对完全没有接触过Agent框架的人来说,记忆层属于进阶话题,前置知识缺口可能较大。组织者特别标注「无需Oracle经验」,说明数据库部分会从基础讲起,不会假设听众熟悉Oracle生态。
LangGraph是LangChain团队推出的用于构建有状态、多步骤Agent应用的框架,其核心抽象是"图":节点代表处理步骤(如调用模型、执行工具),边定义控制流,而内建的checkpointer机制可以把图的执行状态持久化到外部存储,从而支持跨会话恢复和长期记忆。这与本文讨论的持久化记忆直接相关——checkpointer负责保存Agent的运行时状态(包括消息历史),而记忆层则在此基础上决定哪些内容值得长期保留、如何检索和更新。理解这一分层有助于区分"状态持久化"和"语义记忆管理"两个不同层面的工程问题。
一个值得关注的信号
把「遗忘」作为正式议题而非附带说明,反映了Agent记忆工程正在从「尽量多存」转向「有选择地管理」。对话历史无限堆积的做法在短会话场景下勉强可行,一旦Agent需要长期运行,记忆的写入、更新和淘汰策略就会成为系统稳定性的关键变量。这场工作坊把整合与遗忘和持久化、检索并列,可以看作这一认知转变的缩影。
对正在搭建Agent的开发者来说,比起再找一个向量数据库,更值得先想清楚的是:你的Agent应该在什么时候忘记什么。
活动信息:时间为11月21日,线上直播,时长4.5小时,报名详情见 luma.com/agentic-memory。
相关推荐

Codex入门教程:从安装部署到API中转配置实战
Codex入门教程详解:绕过官方登录的信用卡与手机号门槛,通过API中转站完成注册、充值与密钥配置,手把手演示Windows下config.toml文件的修改方法,十分钟完成部署。
DeepSeek Harness从入门到实战:安装与插件全解析
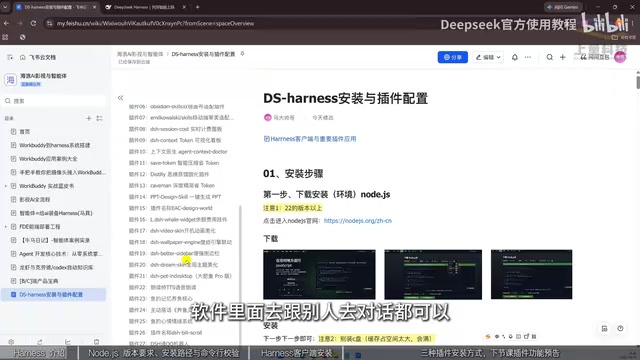
DeepSeek Harness 教程:从安装 NodeJS 环境、部署 Harness 客户端到三种插件安装方式(AI 代装、插件市场、命令行),解析 AI Agent 工作流搭建的实操路径。

DeepSeek Harness实战教程:从安装到插件打造AI超级Agent
DeepSeek Harness实战教程:详解Node.js环境安装、Harness客户端下载配置,以及让AI自装、插件市场、命令行三种插件安装方式,帮你把AI从聊天工具变成能处理本地文件和复杂任务的超级Agent。