AI Agent开发零基础入门:三步上手的最简学习路径

三步入门AI Agent:够用的Python、理解大模型、用LangChain跑通第一个Agent,全程重实操轻理论。
本文提炼了一条专为零基础新人设计的AI Agent入门路径,核心思路是"够用即可、以实操驱动"。第一步只需用三四天学会Python的变量、函数、循环等基础,无需钻研算法底层。第二步通过一本系统性书籍理解大模型的架构、向量/嵌入等核心概念,再借助阿里云、百度等低代码平台亲手搭建知识库和工作流,把抽象概念变成直观体验。第三步直接上手LangChain官方文档,理解"Agent = 大模型 + 记忆 + 工具"这一本质公式,跑通第一个能自动调用工具完成任务的Agent即算入门。整条路径的最大价值在于帮助被术语劝退的初学者明确方向、快速起步,但作者也坦承这只是入门地图,提示工程、评估调优等能力还需后续持续积累。
想入门 AI Agent 开发,却一看到 Python、大模型、LangChain 这些词就犯怵?这其实是很多初学者的通病——总觉得要先把理论全啃透才敢动手。B站一位UP主结合自己踩过的坑,把入门路径浓缩成了三个关键步骤,核心理念只有一个:以够用为目标,实操为主,别死磕理论。
下面结合这份路线图,拆解一条小白也能跟着走的 AI Agent 学习路径。
第一步:Python 够用就好,别死磕
很多人学 AI Agent 的第一个误区,就是一上来抱着厚厚的 Python 教材从头啃到尾。这条路看似扎实,实际上非常浪费时间。
UP主给出的建议很直接:学 Python 的目标只有两个——能看懂 AI 项目的代码,能写简单的逻辑。注意,我们是为了做 AI Agent 开发去学 Python,而不是要成为算法工程师,所以够用就行。
具体的时间投入也不夸张:按照整理好的知识点脑图,挑重点学,每天花一到两个小时,三到四天基本就能过关。这里的关键在于分清主次——变量、函数、循环、基本的数据结构和逻辑控制是重点,而那些偏算法、偏底层的内容在入门阶段完全可以先跳过。
第二步:搞懂大模型,这是 Agent 的发动机
如果说 Python 是入场券,那大模型就是整个 AI Agent 的核心引擎。UP主用了一个很贴切的比喻:大模型就像车子的发动机,没有它整个系统根本跑不起来。
很多人觉得大模型高深莫测,其实是没找对方法。这里有两个很实用的建议:
先看一本书,抓住三个重点
网上教程铺天盖地,看得越多反而越乱。更有效的做法是先系统地看一本书,把三件事搞明白:
- 大模型是怎么拼起来的(基本架构)
- 核心概念有哪些(比如向量、嵌入 Embedding)
- 大模型是怎么跑起来的(推理与调用流程)
理解这几个概念,大模型对你来说就不再是黑盒。
**向量(Vector)与嵌入(Embedding)**是理解大模型的两个基础概念,值得单独说明。嵌入是指将文字、句子等自然语言转换成一串数字(即向量)的过程,这样计算机才能对语义进行数学运算。两段意思相近的文字,其对应的向量在空间中距离也会更近,这正是大模型能"理解"语义的底层原理。知识库检索、语义搜索等功能,本质上都是在比较向量之间的相似度。理解了这一点,后续在搭建 RAG(检索增强生成)类 Agent 时,你就能快速明白为什么需要先把文档"向量化"再存入数据库,而不是直接把原文塞给大模型。
上手实操,用低代码平台找感觉
光看书不够,一定要动手。UP主推荐借助阿里云广告、百度这类平台,用零代码或低代码的方式快速实验:
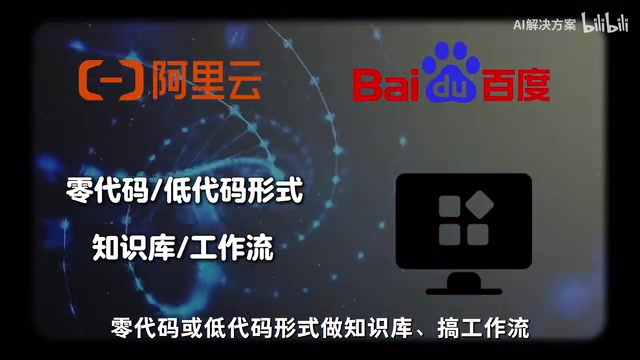
- 把自己的内容传上去,搭建一个知识库
- 尝试搭建工作流
- 试着微调大模型,直观感受模型是如何被调用、如何适配具体需求的
这种“先体验再深究”的方式,往往比干啃理论来得快。当你亲眼看到大模型根据你喂的内容给出回答时,很多抽象概念瞬间就通了。
第三步:用 LangChain 做 Agent 开发
到了真正做 Agent 的阶段,LangChain 是目前最主流的开发框架。UP主的建议同样务实:直接看官方文档,跟着教程完整过一遍即可。
这一步的核心,可以用一句话概括:
Agent = 大模型 + 记忆 + 工具
这个公式其实点出了 Agent 的本质——它不只是一个会聊天的大模型,而是一个能记住上下文(记忆)、还能主动调用外部工具(搜索、计算、API 等)去完成任务的智能体。入门阶段最该搞懂的,就是如何让 Agent 自动调用工具来干活。
跟着官方文档一步步跑通你的第一个简单 Agent,就算正式入门了。
LangChain 是目前生态最完整的大模型应用开发框架,由 Harrison Chase 于2022年发布并开源。它的核心价值在于将大模型调用、记忆管理、外部工具集成等常见能力封装成标准化组件,开发者无需从零实现这些基础设施。框架中的几个关键概念值得提前了解:Chain(链)用于把多个处理步骤串联起来;Memory(记忆)负责在多轮对话中保留上下文;Tool(工具)代表 Agent 可以调用的外部能力,比如搜索引擎、计算器或自定义 API;Agent 则是在这些组件之上,由大模型自主决定"下一步该调用哪个工具"的决策层。LangChain 目前维护着 LangChain 与 LangGraph 两条主线,入门阶段先跑通 LangChain 的基础 Agent 即可,LangGraph 适合处理更复杂的多步骤、有状态工作流。
总结:最简路径就三步
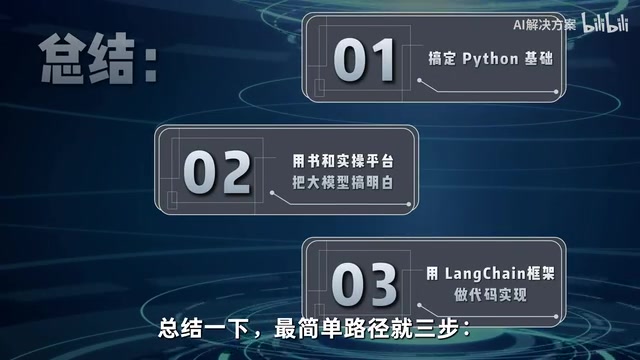
把整条路线梳理一遍,核心就是三步走:
- 搞定 Python 基础——够用即可,三四天挑重点学完
- 用书本加实操平台把大模型搞明白——理解概念 + 低代码实操双管齐下
- 用 LangChain 框架做代码实现——跟着官方文档跑通第一个 Agent
整条路径最大的特点是全程不需要死抠理论,理解各个模块的处理逻辑就够了,重心始终放在实操上。对小白来说,这确实降低了不少入门门槛。
当然,这份路线更像是一张“入门地图”,帮你明确方向、少走弯路。真正要做出能用的 Agent,后续在工具链、提示工程、评估调优等方面还需要持续投入。但对于那些被一堆术语吓退、迟迟不敢动手的新人来说,先按这三步跑起来,远比纠结“我是不是还没准备好”更重要。
相关推荐

FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。

前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
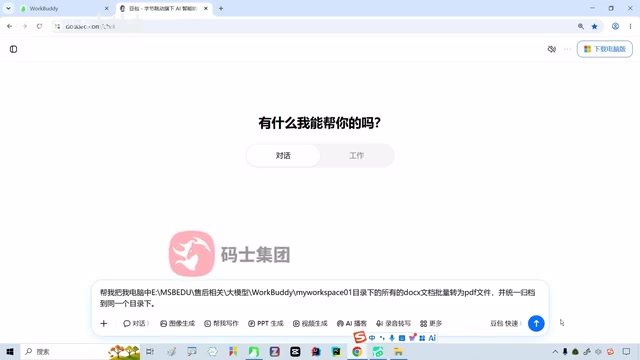
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。