AI Agent零基础学习路线:三阶段从入门到落地

为什么同样学Agent,有人快速落地有人频频踩坑
随着大模型技术的成熟,AI Agent(智能体)已成为近年来最热门的技术方向之一。AI Agent是一种能够自主感知环境、制定决策并执行行动以完成目标的AI系统,与传统的单次问答式大模型不同,它具备「感知-思考-行动」的循环能力,可以调用外部工具、访问数据库、执行代码,甚至协调多个子Agent协作完成复杂任务。
延伸背景:Agent循环的认知科学渊源 AI Agent的「感知-思考-行动」循环在设计上与认知科学中的「感知-行动循环」(Perception-Action Cycle)有深刻的理论渊源。早在1990年代,MIT人工智能实验室的Rodney Brooks就在其包容架构(Subsumption Architecture)中提出了分层反应式控制思想——不同优先级的行为层相互竞争,底层反射行为可以抑制高层规划行为。现代LLM-based Agent则将这一循环提升到了语言推理层面,通过自然语言作为内部表征,赋予其符号化规划与跨域泛化能力,弥补了早期反应式架构无法处理抽象目标的根本局限。
值得一提的是,Multi-Agent系统(MAS) 是Agent技术的重要延伸方向,指多个自主Agent协作完成单一Agent难以胜任的复杂任务。典型架构包括:主从式(Orchestrator-Worker),由主Agent分解任务并分配给专项子Agent;对等式(Peer-to-Peer),多个Agent平等协商与协作;以及竞争式,多Agent通过博弈优化输出质量。AutoGen、CrewAI等框架专为Multi-Agent场景设计,解决了Agent间通信协议、任务分配、结果汇总等工程问题。
Multi-Agent系统在实际工程落地中面临的核心挑战远不止任务分配。Agent间的通信协议设计直接影响系统吞吐量:同步通信(请求-响应模式)简单可靠但存在阻塞风险,异步消息队列(如Kafka、RabbitMQ)则支持高并发但增加了状态同步复杂度。此外,多Agent协作中的「死锁」与「活锁」问题——即Agent相互等待或反复触发但无法收敛——是生产环境中频繁出现却鲜被提及的故障模式,需要通过超时机制、优先级调度和全局状态监控来预防。理解这一扩展方向,有助于在学习单体Agent之后自然过渡到更复杂的协作系统设计。
2023年以来,随着GPT-4、Claude等基础模型能力的跃升,以及ReAct、CoT等推理范式的成熟,Agent从实验室概念迅速走向工程落地。其中,ReAct(Reasoning + Acting) 由谷歌与普林斯顿大学于2022年联合提出,核心思想是让模型在行动前先输出「思维轨迹」(Thought),再决定执行什么动作(Action),随后观察环境反馈(Observation),形成思维-行动-观察的交替循环。CoT(Chain-of-Thought,思维链) 则由Google Brain团队于同年提出,最初发表于论文《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》,通过在Prompt中加入逐步推理示例,引导模型分步思考而非直接输出答案——实验数据表明,在540B参数的PaLM模型上,CoT提示将数学推理准确率从18%大幅提升至57%。
ReAct范式在工程实现中需要特别注意Thought-Action-Observation的格式一致性问题。由于模型在生成Thought时可能提前「幻想」出Action结果而跳过实际工具调用,通常需要通过解析器(Parser)强制拦截Action输出并实际执行工具后再注入Observation。CoT的Few-Shot示例选取同样有讲究:示例的推理步骤数量、领域相关性和错误示例的比例都会影响模型的泛化表现,这是Prompt工程中容易被忽视的调优维度。
围绕Prompt工程,学界还发展出了更多推理范式:Tree-of-Thought(ToT) 将线性思维链扩展为树状多路径搜索,允许模型在关键决策节点探索多种可能性后再选择最优路径;Self-Consistency 则通过对同一问题多次采样并取多数结果来提升准确率。在Agent系统中,系统提示(System Prompt) 的设计尤为关键,需精确定义Agent的角色、能力边界、输出格式和安全约束,直接决定Agent行为的稳定性与可控性——这往往是区分专业Agent工程师与入门者的隐性技能。ReAct进一步将CoT的「思考」与外部工具的「行动」深度结合,使模型不仅能推理还能与真实世界交互,两者共同奠定了Agent自主执行复杂任务的理论基础,也是现代Agent系统的推理基石。
越来越多的开发者希望入门Agent开发,但一个普遍的困境是:同样投入时间学习,有人能快速做出可落地的项目,有人却踩坑不断、浪费精力。
这背后的核心差异,往往不在于智商或投入时长,而在于学习路线是否科学。缺乏系统规划的学习,容易陷入盲目追新框架、忽视基础、跳过实战的误区。本文基于B站精选的Agent零基础教程内容,梳理出一条清晰的三阶段学习路径,帮助初学者少走弯路。
第一阶段:筑牢基本功
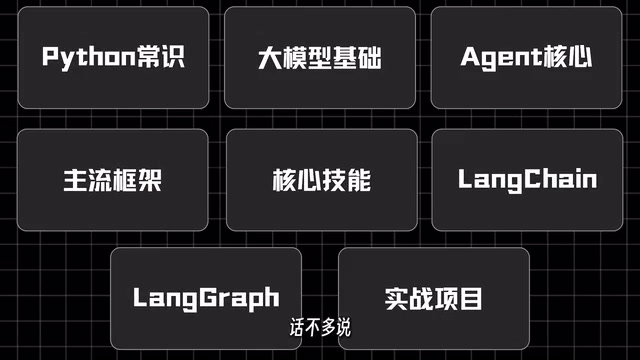
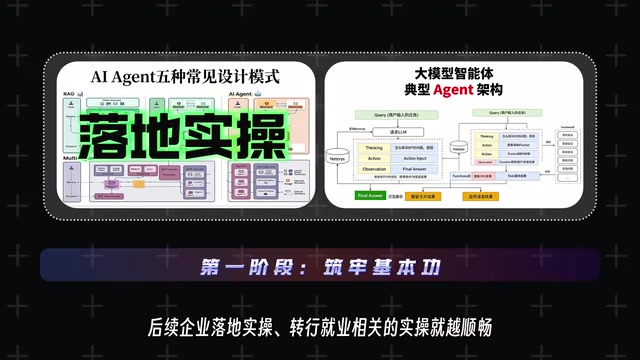
很多人急于上手框架和项目,却忽视了地基的重要性。AI Agent开发的第一阶段,核心是打好三方面的基础。
Python与大模型基础
Python是Agent开发的主流语言,掌握基本语法、数据结构、函数与类的使用是入门门槛。此外,理解大模型(LLM)的基础工作原理同样关键——包括Token机制、上下文窗口、提示词(Prompt)设计等概念。
Token是大模型处理文本的基本单位,并非等同于字词——英文中一个单词约为1-2个Token,中文一个汉字约为1-2个Token。大模型的分词器(Tokenizer)通常采用BPE(字节对编码)或SentencePiece等算法,将文本拆解为子词单元;BPE通过迭代合并高频字节对来构建词表,这也解释了为何代码、数学公式、特殊符号等内容的Token消耗往往远高于普通自然语言文本——这些内容中罕见字符组合无法被高效压缩,需要更多Token单元来表示。上下文窗口(Context Window) 则决定了模型在单次交互中能「记住」的信息总量,早期GPT-3.5仅有4K Token,而GPT-4 Turbo已扩展至128K Token,Claude 3系列更达到200K Token。在Agent开发中,上下文窗口的管理至关重要:过长的历史对话、工具调用结果、检索内容都会消耗窗口容量,如何压缩和优先级排序是实战中的核心挑战之一。这里并不要求你从零训练模型,而是要清楚模型的能力边界与调用方式。
延伸背景:Transformer架构与上下文窗口的物理约束 上下文窗口的限制并非任意设定,而是源于Transformer架构中自注意力机制(Self-Attention)的计算复杂度——其时间和空间复杂度均为O(n²),其中n为序列长度(Token数量)。这意味着序列长度翻倍,计算量将增加四倍。正因如此,扩展上下文窗口需要专门的工程优化,如FlashAttention算法通过分块计算显著降低显存占用,RoPE(旋转位置编码)则通过相对位置编码支持更长序列的外推。理解这一底层约束,有助于开发者在设计Agent记忆策略时做出更理性的工程决策,而非盲目追求最长上下文。
吃透Agent核心概念
在动手之前,需要理解Agent的核心术语与本质特征。Agent与传统程序的根本区别在于其自主决策能力:它能够感知环境、规划任务、调用工具并根据反馈调整行为。同时,了解主流框架之间的设计理念差异,能帮助你在后续选型时做出更合理的判断。
教程中特别强调,这一步走得越扎实,后续企业落地实操与转行就业相关的实践就越顺畅。基础不牢,越往后越吃力。
第二阶段:掌握核心技能与工具
打好基础之后,进入能力构建阶段。这一阶段的目标是攻克Agent的五大核心能力,并掌握主流框架的基础用法。
Agent的五大核心能力
一个完整的AI Agent通常需要具备以下五种能力:
-
任务规划:将复杂目标拆解为可执行的子任务序列。这一能力在工程实现上依赖Plan-and-Solve、HuggingGPT等规划范式,核心是让Agent先生成整体执行计划,再逐步落实,避免在复杂任务中「走一步看一步」导致的方向性偏差。
-
工具调用:通过API、函数等外部工具扩展自身能力边界。OpenAI于2023年推出的Function Calling机制是目前最成熟的工具调用标准——开发者在API请求中以JSON Schema格式声明可用工具(包括函数名、参数类型、描述),模型经过专门的RLHF对齐训练后,能够判断当前任务是否需要调用工具、选择哪个工具,并以结构化JSON格式输出参数。
延伸背景:RLHF对齐训练与工具调用可靠性 Function Calling的高可靠性并非凭空而来,而是大量工程投入的结果。RLHF(基于人类反馈的强化学习,Reinforcement Learning from Human Feedback)由OpenAI在InstructGPT论文中系统阐述:标注者首先对模型在工具调用场景下的输出进行偏好评分(正确的JSON格式、合理的参数选择得分高,格式错误或参数幻觉得分低),这些偏好数据训练出一个奖励模型(Reward Model),再用PPO(近端策略优化)算法持续强化基础模型的工具调用行为。相比早期通过纯Prompt工程「诱导」模型输出工具指令的方式,经过RLHF专项对齐的Function Calling将格式幻觉率(模型输出非法JSON的概率)降低了一个数量级,是Agent从实验走向生产的关键工程里程碑。
相比早期通过Prompt工程「诱导」模型输出工具调用指令的方式,官方Function Calling显著减少了格式幻觉(模型输出非法JSON)的发生率,使工具参数的类型校验与错误处理更加规范,是Agent从实验走向生产的重要里程碑。值得关注的是,2024年底Anthropic提出了MCP(Model Context Protocol,模型上下文协议),旨在标准化大模型与外部工具、数据源之间的接口规范,类似于AI领域的「USB接口」。MCP定义了Resources(数据资源)、Tools(可调用工具)、Prompts(提示模板)三类标准化接口,使同一套工具实现可被不同模型和框架复用,与OpenAI Function Calling形成互补竞争格局,有望成为工具调用领域的统一标准,也是2025年Agent生态中值得密切关注的新兴规范。
-
记忆管理:维护短期与长期记忆,支撑连续对话与上下文关联。通常分为四类:对话缓冲(短期)、摘要压缩记忆(中期)、向量数据库存储(长期语义记忆)、以及结构化知识图谱(实体关系记忆),不同场景需选用不同策略组合。
-
自我反思:对执行结果进行评估与修正,提升输出质量。这一能力源自Reflexion、Self-RAG等学术研究范式——Agent在执行完一个步骤后,不直接输出结果,而是对自己的输出进行批判性评估,判断任务是否完成、结果是否符合预期、是否需要重新规划,形成「执行→评估→修正」的闭环。缺乏反思能力往往导致多步骤任务中错误累积放大,这也是「玩具Demo」与生产级应用的重要分水岭之一。
-
上下文优化:在有限的上下文窗口内高效组织关键信息。常见策略包括滑动窗口截断、对话摘要压缩、关键信息置顶(Lost-in-the-Middle研究表明模型对上下文首尾部分的注意力显著高于中间段)等,这些工程技巧在实际项目中往往比算法选型更能决定系统表现。
这五大能力构成了Agent智能的核心,也是区分「玩具Demo」与「可落地应用」的关键所在。
主流框架:LangChain与LangGraph
在框架选择上,教程建议重点掌握LangChain与LangGraph。
LangChain 由Harrison Chase于2022年10月发布,是目前最具影响力的LLM应用开发框架之一,GitHub星标超过9万。它通过「链式调用」(Chain)将LLM与工具、记忆、数据源串联,提供了完整的工具集成生态,大幅降低了Agent开发门槛,适合快速原型开发。LangChain的核心抽象——LCEL(LangChain Expression Language)——允许开发者用管道符(|)声明式地组合各处理组件,使复杂的多步骤流水线能够以极少的代码清晰表达,并内置了流式输出、异步执行、批处理等生产级特性。
LangGraph 则由LangChain团队于2024年推出,以图(Graph)结构建模Agent工作流——节点(Node)代表处理步骤,边(Edge)代表状态转移条件,支持条件分支、并行执行和循环反馈。其设计借鉴了有向无环图(DAG)与状态机思想:每个节点接收一个全局State对象并返回更新后的State,边可以是固定跳转或基于State内容的条件路由,这种设计使Agent的行为完全可追溯和可调试。与BabyAGI、AutoGPT等早期Agent框架相比,LangGraph通过显式建模工作流避免了「无限循环」和「任务漂移」等生产环境常见故障。其持久化检查点(Checkpoint)机制不仅支持任务中断后的断点恢复,还天然支持人工介入(Human-in-the-Loop)节点,满足企业合规审查的实际需求。两者形成互补关系,共同覆盖从原型到生产的完整开发链路。
延伸背景:有向无环图(DAG)在工作流调度中的工程传承 LangGraph借鉴的DAG思想并非AI领域独创,而是有着深厚的工程传承。Apache Airflow、Luigi等数据工程工具早已将DAG作为任务调度的核心抽象,Spark的执行计划、TensorFlow的计算图也遵循相同理念。DAG的核心价值在于:它使执行依赖关系可视化、可验证(通过拓扑排序检测循环依赖),并天然支持并行化调度(无依赖关系的节点可并行执行)。LangGraph将这一成熟范式引入Agent工作流设计,赋予了AI系统数据工程领域积累数十年的可观测性和可靠性工程经验,这也是它相比早期Agent框架在生产稳定性上更具优势的深层原因。
熟练使用这两款框架,既能适配企业Agent落地的实际需求,也能为转行就业积累扎实的核心技能。
第三阶段:实战练手进阶
技术学习的终点必然是实战。第三阶段遵循「由浅入深、循序渐进」的原则。
从Demo到项目的进阶路径
实战应当从简易Demo入手,比如一个能调用天气API的对话机器人,逐步过渡到具备完整功能的简易项目。在积累一定经验后,再挑战难度更高的进阶实战。
教程中给出的典型进阶案例是:独立开发一个本地文档RAG知识库智能体应用。
RAG(Retrieval-Augmented Generation,检索增强生成)由Meta AI Research团队于2020年提出,是当前企业级Agent落地最广泛的技术范式之一。其核心流程分为四步:首先将文档切片并转化为**向量嵌入(Embedding)**存入向量数据库;用户提问时,将问题同样向量化,在数据库中检索最相关的文本片段;随后将检索结果作为上下文拼入Prompt,由大模型基于真实文档内容生成回答。
延伸背景:RAG与微调的技术路线权衡 RAG与模型微调(Fine-tuning)是解决大模型知识局限性的两条主要技术路径,二者各有适用场景,需要结合业务特点做出权衡。RAG的核心优势在于知识的动态可更新性——无需重新训练模型,只需更新向量数据库即可注入新知识,且每条检索结果都有明确的文档来源,天然具备可溯源性,适合合规要求高的金融、法律场景;其代价是增加了系统复杂度和检索延迟,以及对检索质量的高度依赖(「Garbage In, Garbage Out」在RAG中尤为突出)。Fine-tuning则能让模型内化特定领域的语言风格、隐式知识和推理模式,推理时无额外检索开销,但更新知识需要重新训练,成本高昂且存在「灾难性遗忘」风险(新知识覆盖旧能力)。生产级系统往往将两者组合:用Fine-tuning赋予模型领域语言习惯与输出风格,用RAG动态补充实时知识与私有数据。
这里涉及的向量嵌入与向量数据库是RAG系统的技术基石,值得深入理解。向量嵌入将文本映射为高维数值向量,语义相近的内容在向量空间中距离更近——这一特性使得「如何取消订单」与「退订流程」能够被识别为语义等价的查询。常用的Embedding模型包括OpenAI的text-embedding-3系列、开源的BGE、E5等,中文场景下BGE-M3因其多语言、多粒度特性而广受认可。向量数据库(如Pinecone、Chroma、Weaviate、Milvus)专门为高维向量的存储与相似度检索而设计,主流ANN(近似最近邻)算法包括HNSW(层次化可导航小世界图,检索精度更高)和IVF-PQ(倒排文件+乘积量化,内存占用更低),实际项目中需根据数据规模与延迟要求权衡选择,效果远优于传统基于关键词的倒排索引检索。
在向量数据库选型上,还需综合考量运维成本与数据主权两个维度:Chroma适合本地开发和小规模场景,轻量易部署,是学习阶段的首选;Milvus支持分布式部署,适合亿级向量的企业场景,拥有活跃的开源社区;Pinecone作为完全托管的云服务降低了运维负担,但存在数据出境合规风险,不适合有数据本地化要求的金融、医疗等行业。值得关注的是,混合检索(Hybrid Search)是提升RAG召回率的重要手段——将向量相似度检索与BM25关键词检索结果通过RRF(倒数排名融合)算法合并,能有效弥补纯向量检索在精确词汇匹配上的短板,在金融、法律等专业术语密集的场景中效果提升尤为显著。
在RAG系统的工程实践中,文档切片策略(Chunking Strategy) 往往是被低估却至关重要的环节。Chunk Size与Overlap的设置直接影响检索质量:过小的切片(如128 Token)丢失段落上下文语义,过大的切片(如2048 Token)引入噪声并稀释关键信息,通常需要针对具体文档类型进行实验调优。进阶的切片策略还包括:基于语义边界的切分(而非固定字符数)、父子文档检索(小块用于精准匹配,大块用于上下文补全)、以及针对表格、代码等结构化内容的专项处理。此外,Reranker重排序模型(如BGE-Reranker、Cohere Rerank)作为检索后的精排步骤,能在向量检索召回候选后进一步提升相关性排序质量,是生产级RAG系统的重要优化手段。这些调优细节往往是RAG系统从「能用」到「好用」的关键所在。
RAG有效解决了大模型的两大痛点:知识截止日期限制(无法获取实时信息)和幻觉问题(生成不存在的内容),典型应用场景涵盖企业内部知识库问答、法律/医疗文档检索、智能客服系统等。
能够独立完成这样一个项目,意味着你已经打通了文档解析、向量化、检索、生成整合的完整链路。
实战经验的双重价值
这些实战经验具有双重价值:一方面可以直接服务于企业业务落地,另一方面也能作为转行求职的核心履历,显著提升个人竞争力。相比空谈概念,一个能跑通的完整项目往往更能打动招聘方。
总结:科学路线是效率的关键
回到最初的问题——为什么同样学Agent,效果差异如此之大?答案已经清晰:科学的学习路线能让你少走弯路。
从筑牢Python与大模型基础(Token机制、上下文窗口管理),到掌握五大核心能力(尤其是自我反思这一生产级应用的关键特征)与LangChain、LangGraph等主流框架,再到RAG实战项目的独立落地,这条三阶段路径构成了从零基础到具备就业竞争力的完整闭环。对于初学者而言,与其盲目追逐每一个新框架,不如沉下心来按照这条路线系统推进。
有意思的是,Agent技术仍在快速演进,框架与工具会持续更新——从LangChain、LangGraph到AutoGen、CrewAI,从Function Calling到MCP协议,从单体Agent到Multi-Agent协作系统,新范式层出不穷。但核心的能力模型(任务规划、工具调用、记忆管理、自我反思、上下文优化)与工程思维是相对稳定的。抓住这些不变的本质,才能在变化中保持持久的竞争力。
相关推荐

Meta与出版商的AI数据之争:服务条款修改引爆互联网未来之战
Meta修改商业账户服务条款,允许用关联网站数据训练AI模型,引发出版商和创作者强烈反弹。媒体行业组织联名致信扎克伯格,Meta被迫删除"训练"措辞并推迟条款生效。这场争议揭示了AI时代数据授权与互联网未来的深层博弈。

当Outside Xbox遇上血染钟楼:Minecraft里的军团对局
Outside Xbox嘉宾Ellen和Mike做客Minecraft版《血染钟楼》,迎战军团恶魔局。三名好人如何在信息噪音中对抗多数邪恶?本文解析军团机制、信息角色博弈与终局逆转。

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。