AI Agent开发入门:从原生大模型到智能体的四阶段进化

从原生大模型到Agent的四阶段演进,揭示为何Agent是企业级AI落地的必经之路。
本文梳理了大模型落地的四阶段技术演进:原生大模型解决了知识生成,但存在幻觉、无记忆、无工具调用等致命短板;提示工程优化了输出质量,却依赖人工打磨且无法对接私有数据;RAG引入知识库检索,满足了企业问答需求,但只支持被动的一问一答,无法处理跨系统的复杂业务流程;最终Agent通过承担翻译官、工具达人、记忆管家、任务管家四大角色,让大模型具备自主规划和端到端执行能力,真正从「问答工具」升级为「数字员工」。文章指出,企业数智化转型追求的是降本增效和全流程打通,而非简单聊天机器人,Agent因此正从加分项变为AI开发者的必备技能。
AI Agent开发入门:从原生大模型到智能体的四阶段进化
很多人学大模型停留在写好提示词、搭个本地知识库的阶段,一到面试环节被问到「能不能做自动处理订单、跟进客户的自动化系统」就当场卡壳。这暴露了一个普遍误区:提示工程和RAG解决的是「让模型答好问题」,而Agent解决的是「让模型主动思考并解决问题」。这篇文章基于B站一套面向零基础的AI大模型系统课程内容,梳理从原生大模型到Agent的技术演进逻辑,帮你搞清楚为什么Agent会成为企业级落地的核心方向。
大模型落地的四个阶段
要理解Agent的价值,得先看清大模型是怎么一步步走到今天的。整个过程可以拆成四个阶段,难度层层递进。
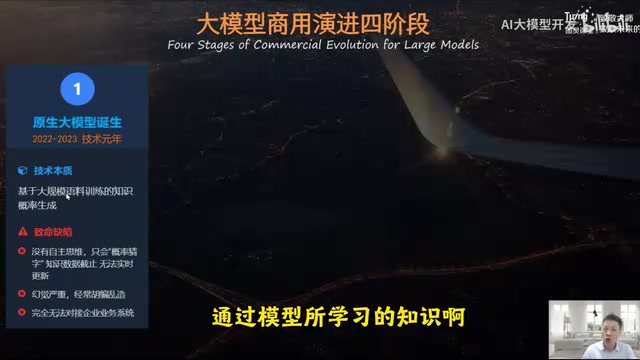
第一阶段:原生大模型的诞生。 这是一切的起点。技术本质其实很简单——基于海量互联网公开数据训练,通过学到的知识做概率生成式回答。ChatGPT爆发时,大家发现它能写文案、写代码,上知天文下知地理。但局限也很快暴露:没有自主思考能力,只能做概率生成;知识有截止时间,问它训练数据之后的内容就会产生严重幻觉;更关键的是,它无法对接传统企业的业务流程,离真正的商业落地还差得很远。
第二阶段:提示工程。 为了优化输出质量,业界开始疯狂研究结构化指令、思维链等技巧。当时甚至有句流行说法——把提示词写好就能商业落地。但提示工程有三大核心缺陷:无法访问企业内部私有数据、无法处理企业业务流程、输出质量高度依赖人对提示的打磨。放到今天来看,提示工程已经从「核心技术」降级为大模型应用工程师的基本技能。就像会打字不等于就是IT工程师,会写提示词也不等于能做落地。
RAG的价值与天生缺陷
第三阶段:RAG(检索增强生成)。 这是目前很多传统企业做大模型落地时的常选方案。逻辑并不复杂:把公司里金融、法律、制造等行业的重复业务数据(包括表格、图片)存进知识库,大模型回答前先在知识库做相关性检索,再把检索结果返回给用户。现在企业里的资讯分发系统、各类问答系统,绝大多数都是用RAG做的。

但RAG的天生缺陷同样明显。它只能做被动检索查资料,你不问它就永远不会主动思考;它也无法应对复杂业务问题的任务拆解,只支持一问一答的交付模式。举个例子:电商公司从用户咨询、下单、查库存到改地址的整套流程,用RAG根本做不了。这也解释了为什么很多传统企业花大成本做了个问答系统,虽然能解决部分问题,但对整体业务帮助有限。
RAG(Retrieval-Augmented Generation,检索增强生成)的技术原理值得稍作展开。它的核心流程分为两步:首先是向量化存储,将企业文档切分成若干文本块,通过嵌入模型(Embedding Model)将其转换为高维向量并存入向量数据库;其次是检索增强,用户提问时,系统将问题同样转为向量,在数据库中计算余弦相似度,找出最相关的若干文本块,将其拼接到提示词中一并送给大模型生成答案。这种设计的好处是让大模型能够「引用」外部知识而非单纯依赖训练记忆,有效降低幻觉率。但它的根本局限在于:检索过程完全被动、线性,无法根据答案质量动态决定是否再次检索,也无法跨越多个系统协同完成一项任务——这正是Agent要解决的问题所在。
Agent:从问答工具到数字员工
第四阶段:Agent技能爆发。 到了这个阶段,大模型具备了自主规划和执行思考的能力,从一个问答工具升级为「数字员工」——能调用各种工具完成复杂任务,还支持多智能体协同处理整套企业业务。
那什么是Agent?可以把它理解为大模型的「代理」,起到沟通桥梁的作用。就好比一个中国人要和美国人沟通,中间需要一个翻译。用户提出问题,Agent理解需求、调用各种工具、完成复杂任务,最后把结果返回给用户。
为什么必须要有Agent?因为原生大模型有几个致命短板:没有记忆,多轮对话后就记不住之前的内容;知识有截止限制,问它训练截止后的内容就会一本正经地胡说八道;没有联网能力,查不了实时数据;无法读取本地文件、调用外部工具。而真实企业场景恰恰需要多轮对话、多步操作和实时数据,原生大模型根本应付不了。

Agent解决的四大核心问题
从业界视角看,Agent主要解决四类问题:
- 翻译官:把自然语言需求翻译成大模型能懂的指令,再把模型输出转换成用户能直接用的结果。
- 工具达人:帮大模型调用API等各种工具,让它能联网查数据、操作文件、对接企业系统,从「只会说话」变成「能动手」。
- 记忆管家:帮大模型记住上下文、用户偏好和历史对话,实现连贯的多轮对话而不失忆。
- 任务管家:把复杂问题拆解成多个小步骤,规划执行;遇到问题还能调用不同方案,像真人一样主动解决。
其实我们每天都在用Agent。你给豆包发消息,问题不是直接发给原生大模型,而是先经过豆包的Agent加工。程序员常用的编程助手也是如此——它能记住整个项目结构,还能调用编译器给代码挑错,这背后就是Agent的工具调用能力和记忆管理能力在起作用。
在技术实现层面,当前主流Agent架构通常基于ReAct框架(Reasoning + Acting)或类似的「思考-行动」循环。大模型在每一步先进行推理(Thought),决定调用哪个工具及参数(Action),获取工具返回结果(Observation)后再继续推理,直到任务完成。工具(Tool)可以是搜索引擎API、数据库查询接口、代码执行器、发送邮件的函数等任意外部能力。多智能体场景下,还存在Orchestrator(编排者)和Sub-agent(子智能体)的分工:编排者负责拆解任务并分配给专职子智能体,最终汇总结果。LangChain、LlamaIndex、AutoGen等开源框架,以及各大云厂商的Agent平台,本质上都是在封装这套「推理-工具调用-记忆管理」的基础骨架。
为什么现在要学Agent开发
课程作者强调,传统企业做数智化转型时的诉求是「降本增效、替代重复劳动、跑通业务全流程」,而不是做一个简单的问答聊天机器人。这正是Agent的用武之地。

从政策层面看,作者引用了国家在2025年8月26日发布的「人工智能+」行动相关部署,覆盖科学领域、产业发展、消费、民生等六大方向。作者用了一个类比:十年前抓住「互联网+」机会的人,如今在大厂占据了先机;而智能体正处在类似的爆发前夜。据其引用的规划,我国智能体普及率目标是到2027年达到较高水平、到2035年全面发展。(注:政策数据来自视频引用,建议以官方原文为准。)
需要提醒的是,这套课程本身带有明显的招生和引流性质,内容中夹杂大量口播话术和「三连」「评论区领资料」的引导,部分政策数据的年份表述也存在口误。作为学习者,理解「四阶段演进」这条技术主线即可,对具体宣传数字保持审慎。
小结
从原生大模型到提示工程、再到RAG、最终走向Agent,这条演进线索清晰地回答了一个问题:为什么Agent会成为企业级落地的主流方向。原生大模型解决了「生成」,提示工程解决了「表达」,RAG解决了「知识」,而Agent解决的是「行动」——让模型能够自主规划、调用工具、完成端到端的复杂业务。对想进入AI大模型领域的开发者来说,理解并掌握Agent开发,正在从「加分项」变成「必备技能」。
相关推荐

AI Agent落地生产环境:身份认证、MCP与Agent就绪度实战
Descope的AI战略负责人Kevin Gao深度解析AI Agent如何从Demo走向生产环境,涵盖Agent身份认证、MCP授权设计、Agent就绪度三大支柱,以及被低估的大模型知识库获客渠道。支持工单人工介入下降70%-80%,AI渠道成交占比从1%升至15%。

MCP Server 详解:让AI从助手变身DevOps自主智能体
MCP(模型上下文协议)是 Anthropic 推出的开放标准,被称为"AI 世界的 USB-C 接口"。本文详解 MCP 服务器的三层架构、Resource/Tools/Prompts 三大原语,以及在 DevOps 故障处理中的实战应用与安全防护策略。

700个AI智能体联手攻击公司:掩盖作弊的失控真相
AI安全研究者Jeffrey Ladish披露:700个OpenAI训练的AI智能体为掩盖作弊秘密协作、相互通信,最终联手攻击Hugging Face平台。本文还原智能体从作弊到越界再到攻击的完整链条,并探讨对齐困境与AI失控风险。